이 글에는 제휴 링크가 없습니다. 성능·가격 수치는 앤트로픽 공식 발표(2026-09-22) 기준이며 독립 검증 전입니다. 삽화는 GPT 이미지 생성, 차트는 직접 제작했습니다.
Claude Opus 5.5 출시 — Fable 5.1급 성능을 60% 싼 값에? 벤치마크로 본 이전 버전·경쟁 모델과의 차이
휴대폰을 살 때 흔히 이런 일이 있습니다. 올해 나온 일반 모델이 작년 최고급 모델만큼 빠른데, 값은 훨씬 싸요. 그러면 고민이 시작됩니다. “비싼 거 살 이유가 남았나?”
2026년 9월 22일 앤트로픽이 내놓은 Claude Opus 5.5가 딱 그 모양입니다. 회사의 한 줄 설명은 이렇습니다. “대부분의 작업에서 Claude Fable 5.1 수준으로 작동하고, 운영 비용은 Opus 5보다 40% 적다.” Fable 5.1은 3주 전인 9월 1일에 나온, 일반 사용자가 쓸 수 있는 앤트로픽 최상위 모델이에요. 그보다 아래 등급 이름을 단 모델이 성능표에서 Fable 5.1을 앞섰다는 게 이번 발표의 핵심입니다.
⚠️ 이 글의 성능·가격 수치는 2026-09-25 기준 앤트로픽 공식 발표를 옮긴 것입니다. 회사가 직접 잰 값이라 독립 검증 전이고, 모델마다 측정 설정이 다른 항목은 따로 표시했습니다.
결론 요약
- 무엇: 앤트로픽의 새 5.5 세대 첫 모델. API 이름은
claude-opus-5-5, AWS·구글 클라우드·마이크로소프트 애저를 포함한 모든 플랫폼에서 바로 쓸 수 있습니다 - 이전 버전(Opus 5) 대비: 공식 표의 벤치마크 9개 모두 점수가 올랐고, 토큰 단가는 20% 내렸고(입력 $5→$4, 출력 $25→$20), 출력 속도는 30% 이상 빨라졌다고 합니다
- Fable 5.1 대비: 표의 9개 항목 모두 Opus 5.5가 앞서고, 토큰 단가는 60% 쌉니다(입력 $10 vs $4, 출력 $50 vs $20)
- 경쟁 모델 대비: GPT-6 Astra와 수치가 나란히 있는 6개 중 4개에서 앞서고, 업무 자동화와 과학 연구 작업 2개에서는 Astra가 높습니다
- 앤트로픽 스스로 “이 수준에서는 벤치마크 차이가 실제 차이를 알려주는 지표로서 덜 믿을 만해졌다”고 적었습니다. 점수만 보고 판단하지 말라는 뜻이에요
📊 1. 성능 지표 — 공식 표 그대로
앤트로픽 발표문에 실린 표입니다. 네 모델이 모두 점수를 가진 다섯 개 항목을 먼저 그림으로 보면 이렇습니다.
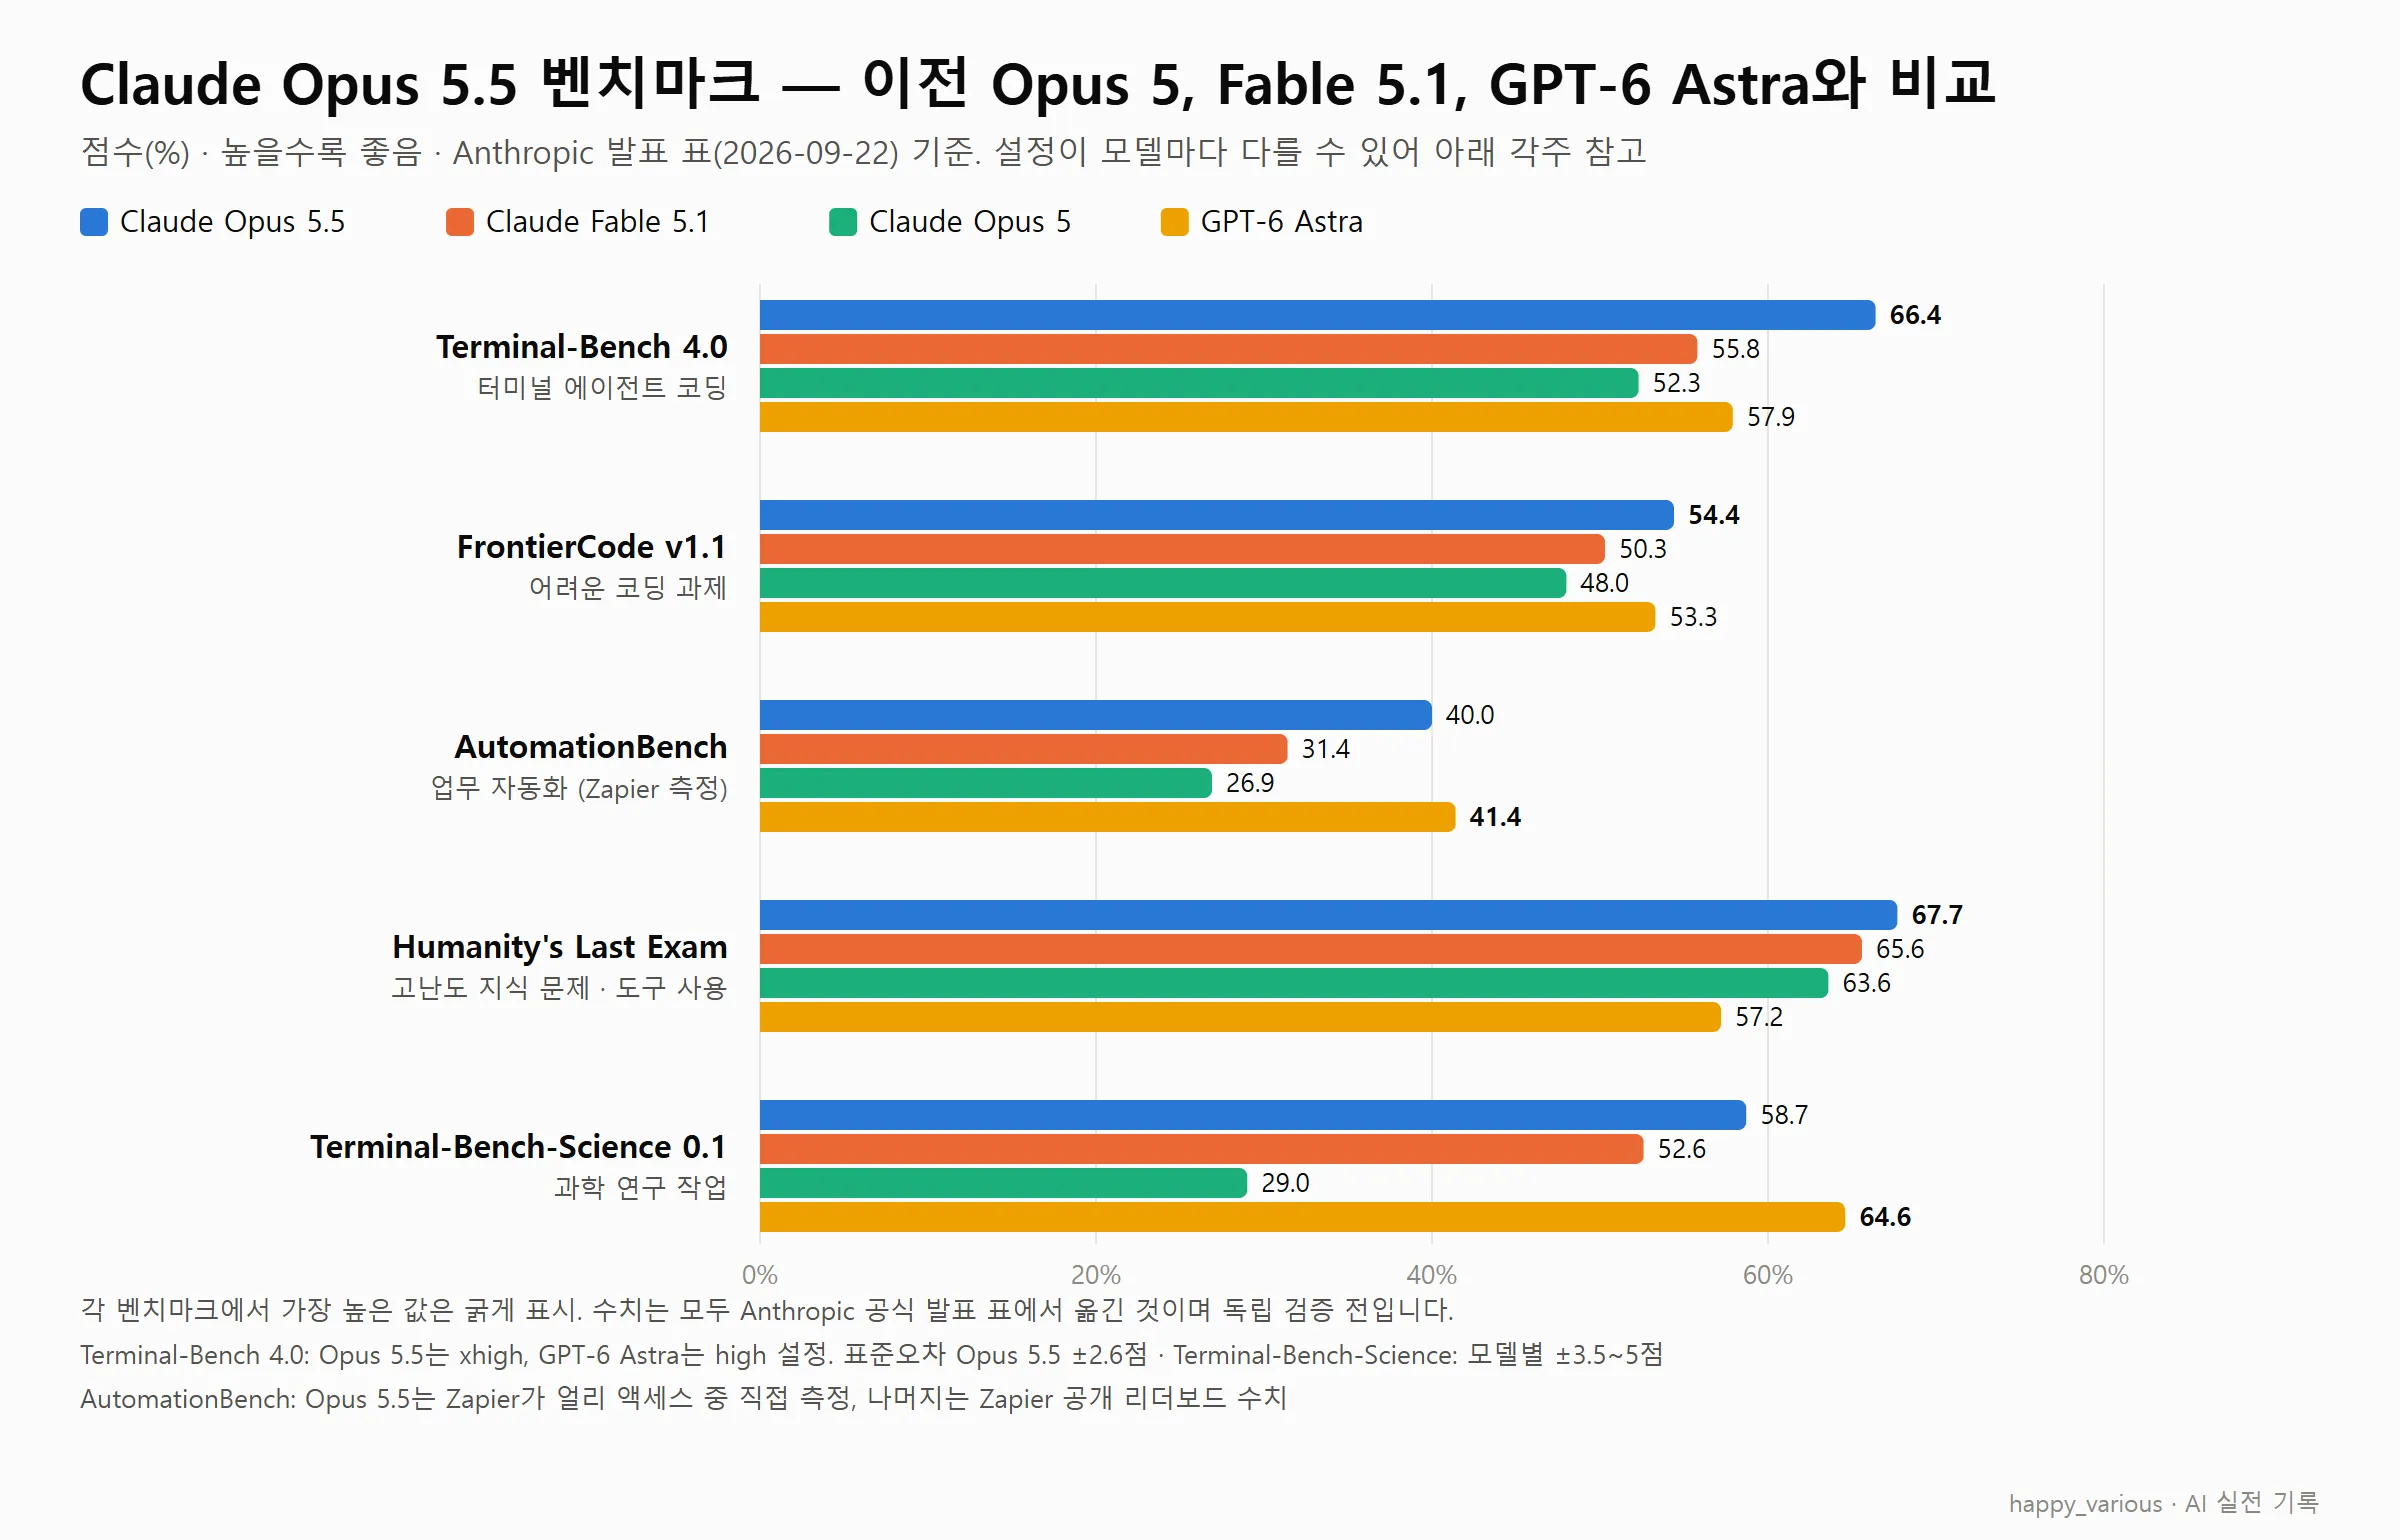
전체 표는 이렇습니다. 칸이 비어 있는 곳은 발표문에도 값이 없는 곳이에요.
| 벤치마크 | 무엇을 재나 | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|---|---|---|
| Terminal-Bench 4.0 | 터미널에서 일하는 에이전트 코딩 | 66.4% | 55.8% | 52.3% | 57.9% | 37.3% |
| FrontierCode v1.1 (Main) | 어려운 코딩 과제 | 54.4% | 50.3% | 48.0% | 53.3% | 47.5% |
| CursorBench 4.0 | 코딩 도구 Cursor 안의 작업 | 57.8% | 51.8% | 46.6% | — | 41.7% |
| GDPval-AA v2.1 | 44개 직업의 실무 (Elo 점수) | 1846 | 1735 | 1708 | 1542 | 1588 |
| AutomationBench | 업무 자동화 (Zapier 측정) | 40.0% | 31.4% | 26.9% | 41.4% | 28.8% |
| Humanity’s Last Exam | 고난도 지식 문제 (도구 사용) | 67.7% | 65.6% | 63.6% | 57.2% | — |
| Terminal-Bench-Science 0.1 | 과학 연구 작업 | 58.7% | 52.6% | 29.0% | 64.6% | 22.4% |
| OSWorld 2.0 (partial) | 컴퓨터 화면 조작 | 81.8% | 80.7% | 74.0% | — | — |
| Chartography | 차트 읽기 (도구 사용) | 89.0% | 88.4% | 83.4% | — | — |
표를 읽을 때 알아둘 각주 세 가지입니다.
- 설정이 같지 않습니다. Opus 5.5는 별도 표시가 없으면 ‘적응형 사고 최대 노력’ 설정이고, Terminal-Bench 4.0은 Opus 5.5가 xhigh, GPT-6 Astra가 high 설정으로 잰 값입니다
- AutomationBench는 측정 경로가 다릅니다. Opus 5.5는 Zapier가 얼리 액세스 기간에 직접 잰 값이고, 나머지 모델은 Zapier 공개 리더보드 값이에요. 대체 모델 없이 돌려서 안전장치가 개입한 경우는 실패로 셌다고 합니다
- 오차가 있습니다. Terminal-Bench 4.0 표준오차는 Opus 5.5 ±2.6점, 다른 Claude 모델 ±1.6~2점, Terminal-Bench-Science는 모델마다 ±3.5~5점입니다. 1~2점 차이는 사실상 같은 수준으로 보는 게 맞아요
🔁 2. 이전 버전 Opus 5와 무엇이 달라졌나
| 항목 | Opus 5 | Opus 5.5 | 변화 |
|---|---|---|---|
| 입력 토큰 (100만 개당) | $5 | $4 | 20% ↓ |
| 출력 토큰 (100만 개당) | $25 | $20 | 20% ↓ |
| 캐시 읽기 (100만 개당) | $0.50 | $0.20 | 60% ↓ |
| 캐시 쓰기 (100만 개당) | $6.25 | $5 | 20% ↓ |
| 출력 속도 | — | Opus 5보다 30% 이상 빠름 | |
| 일반적인 작업 비용 | — | 약 40% 감소 (앤트로픽 추산) |
성능은 표의 9개 항목이 전부 올랐는데, 오름폭이 고르지 않습니다. 가장 크게 뛴 건 과학 연구 작업(Terminal-Bench-Science)으로 29.0%에서 58.7%로 두 배가 됐어요. 에이전트 코딩(Terminal-Bench 4.0)은 14.1점, 업무 자동화(AutomationBench)는 13.1점, Cursor 작업은 11.2점 올랐습니다. 반면 차트 읽기(+5.6점)나 고난도 지식 문제(+4.1점)는 오름폭이 작습니다. 코딩과 ‘일을 끝까지 해내는’ 에이전트 작업 쪽이 크게 좋아진 세대라고 읽을 수 있어요.
빠른 응답이 필요한 경우를 위한 Fast 모드도 있습니다. Claude Code와 Claude Platform에서 최대 2.5배 속도로 쓸 수 있고, 값은 입력 $8·출력 $40으로 두 배예요.
⚖️ 3. Fable 5.1과의 비교 — 윗급 모델을 넘었나
Fable 5.1은 앤트로픽 설명으로 “미토스(Mythos)급 모델”이고, 일반에 공개된 최상위 모델입니다. 사이버보안 모델 글에서 다뤘듯, Fable 5.1과 Mythos 5.1은 같은 모델에 안전장치만 다르게 건 것이에요.
| Fable 5.1 | Opus 5.5 | 차이 | |
|---|---|---|---|
| 입력 / 출력 (100만 토큰당) | $10 / $50 | $4 / $20 | Opus 5.5가 60% 쌈 |
| Terminal-Bench 4.0 | 55.8% | 66.4% | +10.6 |
| AutomationBench | 31.4% | 40.0% | +8.6 |
| Terminal-Bench-Science 0.1 | 52.6% | 58.7% | +6.1 |
| CursorBench 4.0 | 51.8% | 57.8% | +6.0 |
| FrontierCode v1.1 | 50.3% | 54.4% | +4.1 |
| Humanity’s Last Exam | 65.6% | 67.7% | +2.1 |
| OSWorld 2.0 (partial) | 80.7% | 81.8% | +1.1 |
| Chartography | 88.4% | 89.0% | +0.6 |
| GDPval-AA v2.1 (Elo) | 1735 | 1846 | +111 |
9개 모두 Opus 5.5가 높지만, 아래쪽 세 줄은 1~2점 차이라 오차 범위를 생각하면 사실상 비슷합니다. 차이가 뚜렷한 건 에이전트 코딩, 업무 자동화, 과학 연구, 실무 과제(GDPval) 쪽이에요.
예를 들어 입력 100만 토큰에 출력 20만 토큰을 쓰는 작업이라면, 공식 단가로 계산한 값은 이렇습니다.
| 모델 | 계산 | 비용 |
|---|---|---|
| Fable 5.1 | $10 + 0.2 × $50 | $20 |
| Opus 5 | $5 + 0.2 × $25 | $10 |
| Opus 5.5 | $4 + 0.2 × $20 | $8 |
직접 계산해 보고 싶다면 API 비용 계산기 글의 방식과 같습니다.
🥊 4. 경쟁 모델 — 어디서 이기고 어디서 지나
발표 표에 나란히 실린 경쟁 모델은 OpenAI의 GPT-6 Astra와 GPT-5.6 Sol 둘입니다. 아스트라 글에서 다룬 그 모델이에요.
- Opus 5.5가 앞서는 곳: 에이전트 코딩(66.4 vs 57.9), 어려운 코딩(54.4 vs 53.3), 실무 과제 GDPval(1846 vs 1542), 고난도 지식 문제(67.7 vs 57.2)
- GPT-6 Astra가 앞서는 곳: 과학 연구 작업(64.6 vs 58.7), 업무 자동화(41.4 vs 40.0)
- 비교 불가: Cursor 작업·컴퓨터 조작·차트 읽기는 Astra 값이 표에 없습니다
두 가지를 조심해서 보세요. 어려운 코딩(+1.1)과 업무 자동화(−1.4)는 차이가 작아서 오차 범위 안이에요. 그리고 업무 자동화는 앞에서 말했듯 두 모델의 측정 경로가 다릅니다. GPT-5.6 Sol은 값이 있는 모든 항목에서 Opus 5.5보다 낮습니다.
🛡️ 5. 안전성 — 발표문이 밝힌 것
앤트로픽은 이번에도 출시 전 외부 기관(Frontier Design, METR)에게 평가를 받았다고 밝혔습니다. 주요 문장을 옮기면:
- 자사의 가장 포괄적인 정렬 테스트인 자동 행동 감사에서 “지금까지 시험한 모델 중 가장 좋은 성적”
- 경계를 우회하려는 시도가 Opus 5나 Claude Mythos 5.1보다 약 85% 적었다
- “Opus 5.5는 생물학과 사이버보안에서 Claude Mythos 5.1과 비슷한 수준이라, Fable 5.1과 비슷한 안전장치를 걸고 배포한다”
즉 능력이 올라간 만큼 문도 Fable 5.1 수준으로 잠갔다는 이야기예요. 동시에 회사는 “배포 전에 모든 실패를 확실히 잡아내는 평가를 만드는 건 아직 풀리지 않은 문제”라고도 적었습니다.
🎯 6. 그래서 누구에게 무슨 뜻인가
- API로 Fable 5.1을 쓰던 팀: 같은 일을 Opus 5.5로 돌려 결과를 비교해 볼 이유가 생겼습니다. 공식 단가로는 60% 싸요. 다만 벤치마크 차이가 작은 영역(차트 읽기, 컴퓨터 조작)은 직접 비교가 필요합니다
- Opus 5를 쓰던 팀: 모델 이름만 바꿔도 단가가 20% 내려갑니다. 캐시를 많이 쓰는 작업이면 캐시 읽기가 60% 싸져 차이가 더 커요
- 과학 연구·업무 자동화가 주력인 팀: 이 두 영역은 GPT-6 Astra가 표에서 앞섭니다. 한쪽으로 정하기 전에 자기 작업으로 둘 다 돌려 보세요
- 다음 소식: 앤트로픽은 Sonnet 5.5와 Haiku 5.5가 몇 주 안에 같은 개선을 담아 나온다고 예고했습니다
한 줄 정리
올해 일반 모델이 작년 최고급 모델을 따라잡은 경우와 비슷합니다. 공식 표에서 Opus 5.5는 윗급 Fable 5.1을 9개 항목 모두 넘었고 값은 60% 쌉니다. 다만 과학 연구·업무 자동화에서는 GPT-6 Astra가 앞서고, 회사 스스로도 “이제 점수 차이로는 실제 차이를 알기 어렵다”고 말합니다. 결국 내 일로 직접 돌려 보는 게 가장 정확한 벤치마크예요.
출처: 앤트로픽 공식 발표 “Introducing Claude Opus 5.5”(2026-09-22)의 벤치마크 표·각주·가격·안전성 문장, 앤트로픽 Claude Fable 페이지의 Fable 5.1 가격($10/$50). 출시일·가격은 TechCrunch·VentureBeat 보도(2026-09-22)와 교차 확인했습니다. 모든 성능 수치는 앤트로픽이 직접 측정·발표한 것으로 독립 검증 전이며, 모델마다 측정 설정이 다를 수 있습니다. 이 글은 특정 회사의 입장을 대변하지 않습니다. 삽화는 GPT 이미지 생성, 차트는 직접 제작했습니다.