이 글에는 제휴 링크가 없습니다. 삽화는 GPT 이미지 생성, 도식은 직접 제작했습니다.
Claude Code 서브에이전트 실전 — 잡지사처럼 작가 열한 명에게 글 32편을 하루에 청탁한 방법
잡지 편집장은 한 호에 실릴 원고 서른 편을 혼자 쓰지 않습니다. 대신 두 가지를 합니다. 취재 노트를 작가에게 통째로 넘기고, 들어온 원고는 교열부가 형식부터 거릅니다. 작가가 열 명이어도 잡지의 결이 흐트러지지 않는 이유는 작가가 뛰어나서가 아니라 이 두 장치 때문이에요.
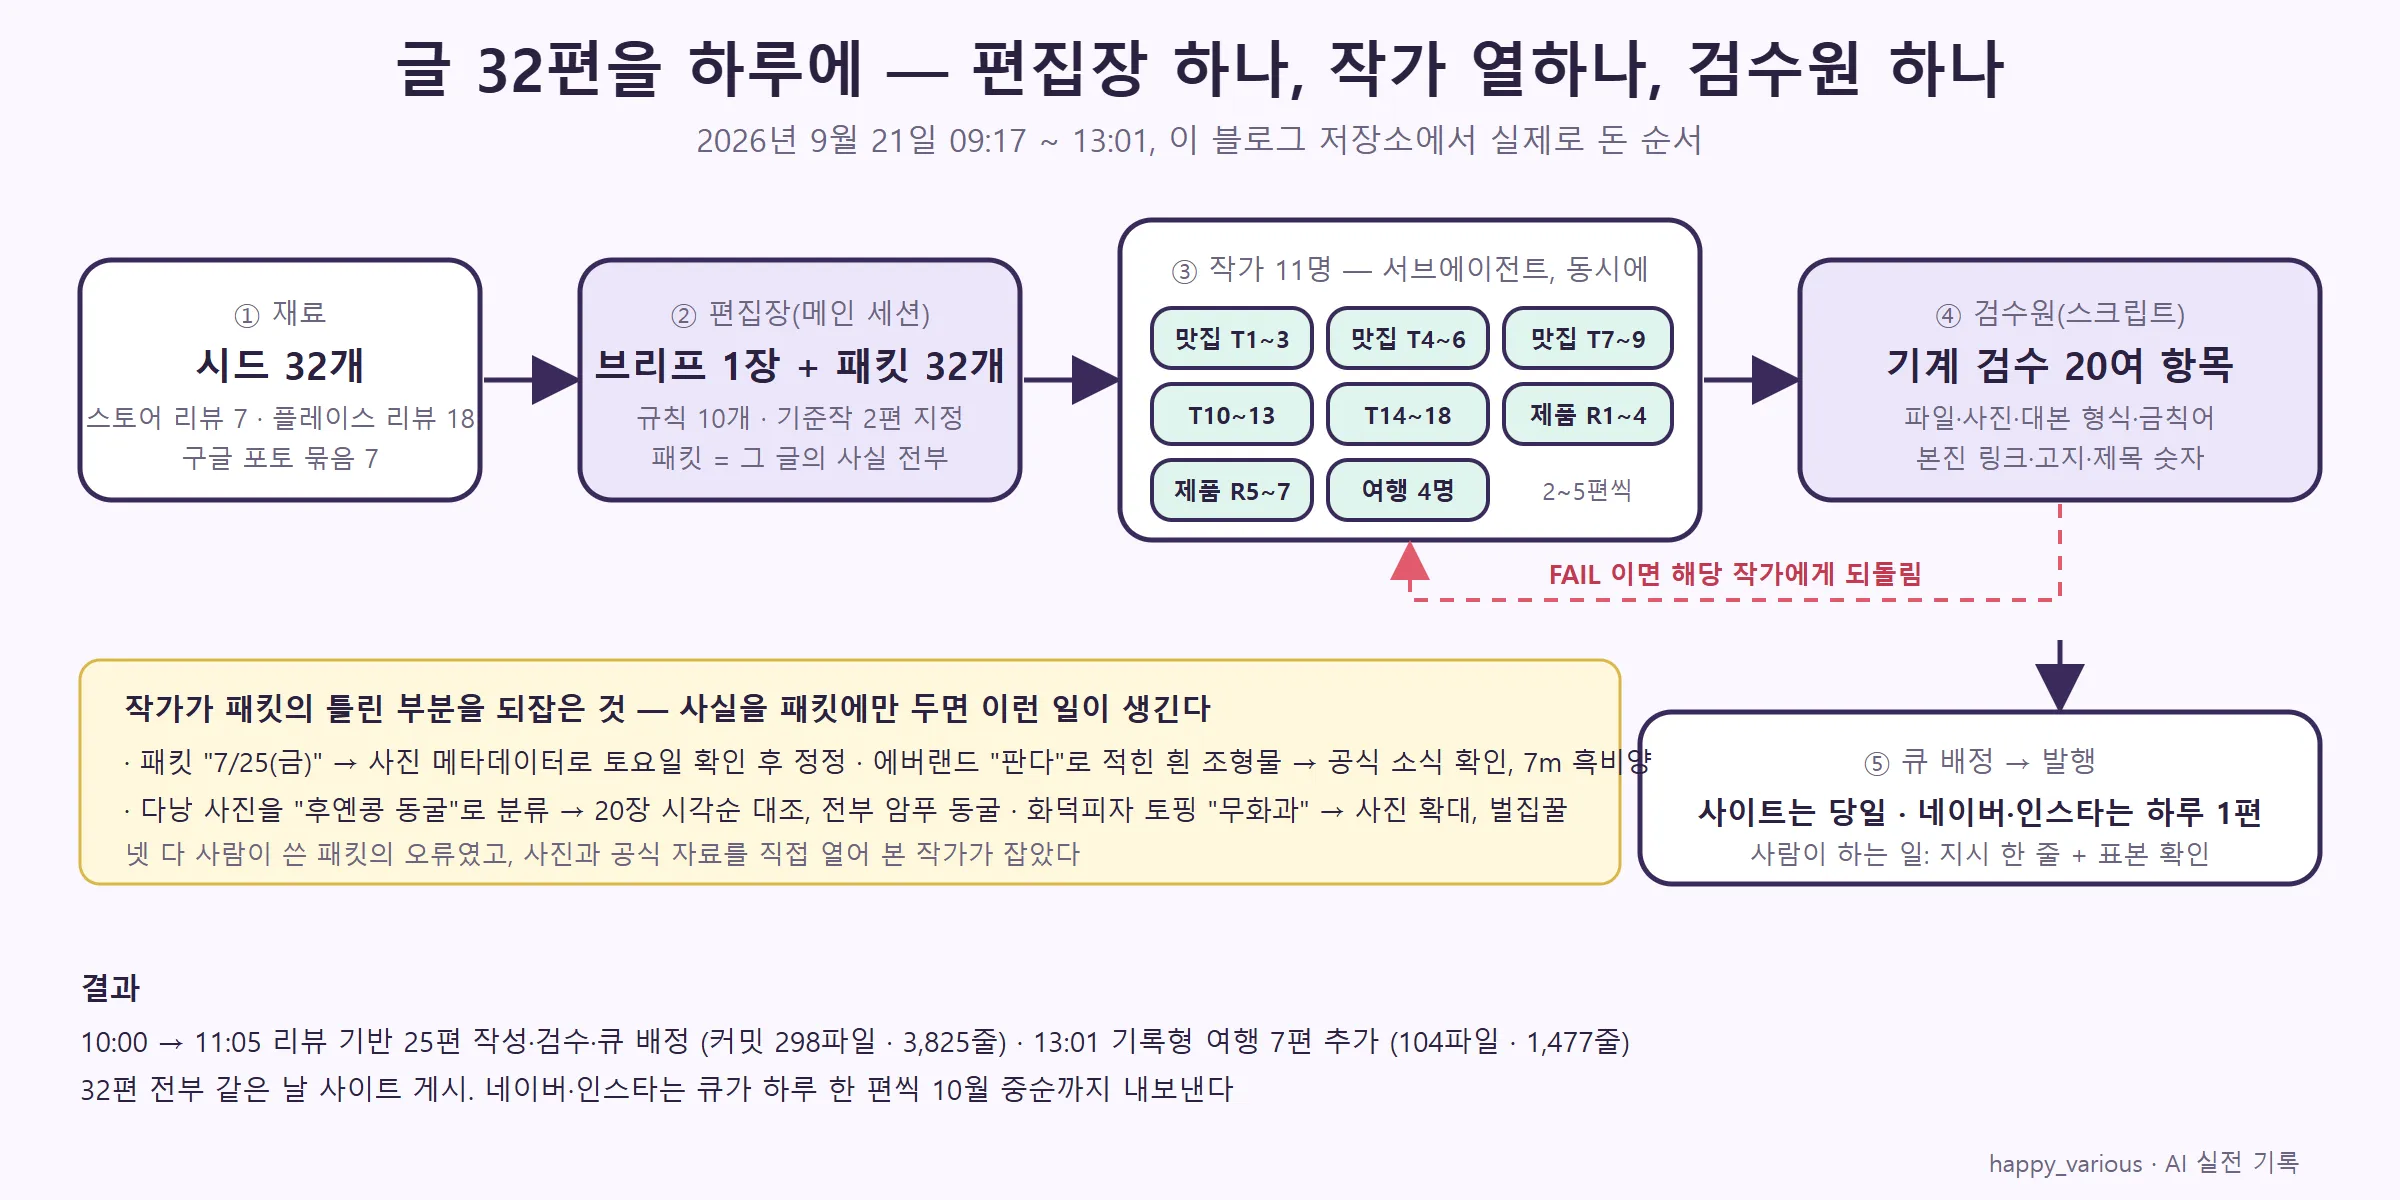
이번 주 제 블로그 공장에서 정확히 이 방식으로 글 32편을 하루에 만들었습니다. 소재는 쌓여 있던 스토어 리뷰 7개, 플레이스 리뷰 18개, 사진만 남은 구글 포토 묶음 7개. 편집장 역할은 제 Claude Code 메인 세션이, 작가는 서브에이전트 열한 명이, 교열은 스크립트 하나가 했습니다. 브리프와 패킷, 검수 코드를 실물 그대로 보여드릴게요.
결론 요약
- 서브에이전트를 여러 개 돌릴 때 성패는 작가에게 뭘 쥐여주느냐에 달려 있습니다. 브리프(공통 규칙) 한 장 + 패킷(그 글의 사실 전부) 한 장이면 결이 맞습니다
- 패킷에 “여기 있는 사실만 써라”를 못 박으면 지어내기가 막힐 뿐 아니라, 작가가 패킷의 오류를 되잡아 줍니다. 이번에 넷을 잡았어요
- 사람이 32편을 다 읽을 수는 없습니다. 형식은 스크립트가, 사실은 표본만 사람이 봅니다
- 실측: 리뷰 기반 25편이 10시에 시작해 11시 5분에 검수·큐 배정까지 끝났고, 기록형 7편이 13시 1분에 더해졌습니다
🧩 1. 왜 한 세션에서 32편을 쓰면 안 되나
처음엔 메인 세션에서 차례로 쓰려 했습니다. 세 가지 이유로 접었어요.
- 다 안 들어갑니다. 글마다 리뷰 본문, 사진 여러 장, 규칙, 기준작 두 편을 봐야 하는데 32편이면 컨텍스트 창 하나에 안 담깁니다
- 사진은 한 장씩 열어봐야 합니다. 아이 얼굴이 정면이면 빼고, 영수증이 찍혔으면 가려야 하니까요. 이 판단은 글쓰기와 별개의 일이고, 글마다 따로 해야 합니다
- 순서대로 쓰면 뒤로 갈수록 앞의 규칙을 잊습니다. 열 번째 글쯤부터 고지 문장이 빠지고 제목 패턴이 흐트러지는 걸 이미 겪었어요
서브에이전트는 빈 컨텍스트에서 시작하는 새 작업자입니다. 메인 세션의 대화를 모르고, 제가 준 것만 알아요. 그래서 무엇을 주느냐가 전부입니다. 서브에이전트 사용법 글에서 “맥락을 나눠 맡기고 결론만 받는다”고 썼는데, 이번 글은 그 원칙의 실전 편이에요.
📄 2. 브리프 한 장 — 작가 열한 명이 똑같이 읽는 것
브리프는 마크다운 한 장입니다. 실제 파일의 뼈대만 옮기면 이렇습니다.
# 배치 집필 브리프 — 2026-09-21 (시드 25편)

## 기준작 (형식은 이 두 폴더를 그대로 따른다 — 네 파일 전부 열어볼 것)
- 맛집/육아: content/20260916-suwon-daemeori-kalguksu/
- 제품 리뷰: content/20260916-bucket-dolly-two-ways/

## 글마다 만들 것
canonical.md · content.yml · channels/naver.yml · cards.yml · assets/img/photo-NN.jpg · 카드뉴스

## 절대 규칙
1. 패킷의 리뷰 본문에 있는 사실만 쓴다. 없는 경험·평가를 지어내지 않는다.
2. 외부 사실(주소·영업시간·가격)은 공식 페이지에서 확인해 넣고 출처를 밝힌다. 확인 안 되면 넣지 않는다.
3. 방문 시점은 과거형으로 명시한다.
4. 사진은 한 장씩 열어본다. 아이 얼굴 정면은 제외, 영수증·전화번호는 가린다.
5. 도메인 분리 — 맛집 글에 세차·AI 이야기 금지.
6. 단점을 뺀 리뷰 글은 없다.
7. 제목에 내부 번호 금지.
8. 네이버 대본은 자동서식 회피 — 숫자목록 대신 ①②③, 하이픈 대신 ·
9. 내부 링크는 패킷에 적힌 것만.
10. 하지 말 것: 큐 배정·커밋·발행 금지. content/ 밖 파일 수정 금지.

## 끝나면 보고할 것
만든 파일 · 쓴 사진과 뺀 사진(이유) · 외부에서 확인한 사실과 출처 · 리뷰에 없어서 안 쓴 것
포인트는 세 개입니다. 기준작을 파일 경로로 지정해서 “이 폴더처럼 만들어라”로 형식 설명을 대신했고, 규칙은 열 개로 끊었고, 하지 말 것을 명시했어요. 열 번째 규칙이 특히 중요합니다. 작가가 발행까지 해버리면 하루 한 편이라는 발행 큐 원칙이 무너지니까요.
📦 3. 패킷 32개 — 그 글의 사실 전부
패킷은 글 하나에 파일 하나입니다. 편집장(메인 세션)이 소재 풀을 훑어 만들었고, 안에는 이것만 들어 있어요.
- 라인과 네이버 카테고리, 글의 각도 한 줄
- 원재료 — 리뷰 본문 그대로. 제목이 “리뷰 본문 (사실의 전부)“입니다
- 사진 경로 목록 (열어보고 고르라는 지시와 함께)
- 내부 링크 후보 (이것만 쓰라는 제한과 함께)
후기 본문이 없는 구글 포토 묶음 7개는 성격이 다른 패킷을 받았습니다. 삼척 대금굴 편의 “확보된 사실” 부분을 그대로 옮기면 이렇습니다.
## 이 글의 성격 — 기록형 (매우 중요)
후기 본문이 없다. 재료는 (1) 사진에 보이는 것 (2) 사진 촬영 시각 (3) 아래 '확보된 사실'
(4) 공식 페이지에서 확인한 정보 뿐이다.
- 맛·감정·아이 반응·"좋았다/아쉬웠다" 같은 평가를 지어내지 않는다.
- 장소를 사진만으로 단정할 수 없으면 "~로 보인다"고 쓰고 근거를 적는다.

## 확보된 사실
- 2026-08-28(금) 10:53 대금굴 표지석 앞 가족 사진 여러 장 → 이날 오전 방문 확실
- 11:06~11:07 사진 3장: 어두운 목조 실내(서까래, 화로). 동굴지대 안에 국가민속문화재
  너와집·굴피집이 있다 → "옛집(너와집으로 보인다)"까지만
- 공식 예매 페이지에서 직접 확인한 값만 쓴다. 어떤 회차를 탔는지는 기록이 없으니 쓰지 않는다
“쓰지 않는다”가 “쓴다”만큼 많습니다. 패킷의 절반은 경계선이에요. 어디까지가 사실이고 어디부터가 추측인지를 편집장이 먼저 그어두면, 작가는 그 안에서만 움직입니다.
⚡ 4. 작가 열한 명이 동시에 — 실제 배치
32편을 열한 명에게 나눴습니다. 맛집 글 18편은 3~5편씩 다섯 명, 제품 글 7편은 두 명, 기록형 여행 7편은 네 명. 한 작가가 2~5편을 맡은 셈이에요. 각자 브리프와 자기 패킷 경로만 받고 시작했고, 사진을 열어보고, 공식 페이지를 확인하고, 파일 네 개와 카드뉴스를 만들고, 보고서를 남겼습니다.
시간은 커밋이 말해줍니다. 소재 정리가 끝난 게 오전 10시, 리뷰 기반 25편의 작성·검수·큐 배정 커밋이 11시 5분(298개 파일, 3,825줄). 기록형 7편은 13시 1분(104개 파일, 1,477줄). 사람이 한 일은 지시 한 줄과 표본 확인이었어요.
🔍 5. 작가가 패킷을 고쳐 준 네 장면
패킷은 사람(과 편집장 세션)이 만든 것이라 틀릴 수 있습니다. 이번에 작가들이 되잡은 게 넷이에요.
| 패킷에 적힌 것 | 작가가 확인한 것 | 근거 |
|---|---|---|
| 방문일 “7/25(금)” | 토요일 | 사진 촬영 메타데이터의 날짜 |
| 에버랜드의 흰 조형물 = 판다 | 7m 크기 흑비양 | 에버랜드 공식 소식(2026-05-07) |
| 다낭 사진 = 후옌콩 동굴 | 20장 전부 암푸 동굴 | 사진 20장을 시각순으로 공식 안내와 대조 |
| 화덕피자 토핑 = 무화과 | 벌집꿀 | 사진 확대 |
넷 다 규칙 2번 덕분입니다. “외부 사실은 공식 페이지에서 확인하라”가 있으니 작가가 패킷을 그대로 믿지 않고 대조했고, “확인 안 되면 넣지 말라”가 있으니 애매한 것은 빠졌어요. 사실을 패킷에만 두는 방식은 지어내기를 막는 장치이면서, 동시에 패킷 자체를 검증받는 장치이기도 합니다.
✅ 6. 검수원은 스크립트 — 형식은 기계가, 사실은 표본만 사람이
32편을 사람이 다 읽을 수는 없습니다. 그래서 큐에 넣기 전에 스크립트가 거릅니다. 실제로 보는 항목의 일부예요.
if "publish_at" in fm: bad(cid, "publish_at 이 미리 들어가 있음")      # 발행일은 큐가 정한다
if cy.get("schedule"): bad(cid, "schedule 이 미리 들어가 있음")
if re.search(r"^\s*\d+\.\s", joined, re.M): bad(cid, "네이버 대본에 '1. ' 숫자목록")
if re.search(r"^\s*-\s", joined, re.M): bad(cid, "네이버 대본에 '- ' 하이픈 불릿")
if not url_segs: bad(cid, "본진 링크 세그먼트 없음")
for w in (T_BAD if line == "T" else R_BAD):                            # 맛집 글의 '세차', 제품 글의 '욕실'
    if w in body: bad(cid, f"도메인 교차 단어 '{w}'")
if "협찬" not in can: bad(cid, "고지(협찬 아님) 없음")
파일 네 개가 다 있는지, 본문의 사진 파일이 실제로 있는지, 카드뉴스가 생성됐는지, 제목에 내부 번호가 섞였는지까지 20여 항목입니다. 하나라도 걸리면 그 글은 해당 작가에게 되돌아갑니다. 통과한 뒤에 사람은 표본 몇 편의 사실 관계만 읽었어요.
⚠️ 7. 한계 — 이 방식이 못 하는 것
- 문체 편차. 기준작을 같이 봐도 작가마다 결이 조금씩 다릅니다. 같은 라인은 같은 작가에게 몰아주면 줄어들어요
- 패킷이 틀리면 글도 틀립니다. 넷은 잡았지만 못 잡은 게 없다고 장담할 수 없어요. 확인이 안 된 항목은
update_due에 남겨 다음 점검 때 봅니다 - 검수 스크립트는 형식만 거릅니다. “사실이 맞는가”는 못 봐요. 그래서 표본 확인이 남습니다 — AI 산출물은 검증까지가 한 세트
- 보고서를 시키지 않으면 사라집니다. 서브에이전트는 끝나면 없어져요. “뺀 사진과 이유, 확인 못 해 안 쓴 것”을 보고하게 한 덕에 편집장이 뒤를 볼 수 있었습니다
- 비용은 작가 수에 비례합니다. 열한 명이 각자 기준작과 사진을 읽으니 한 세션보다 훨씬 많이 씁니다. 두세 편이면 그냥 메인 세션에서 쓰는 게 낫습니다
🎯 시작 코스 — 글 다섯 편부터
- 기준작 하나를 정합니다. “이 폴더처럼”이 어떤 형식 설명보다 정확합니다
- 브리프 한 장: 규칙은 열 개 이하, “하지 말 것”을 꼭 넣습니다 (발행·커밋·다른 파일 수정)
- 패킷은 글마다 파일 하나: 사실 전부 + 경계선(“이건 쓰지 않는다”)
- 작가에게는 브리프 경로와 패킷 경로만 줍니다. 대화 맥락은 안 넘어가니 파일에 다 있어야 해요
- 검수 규칙 세 개부터 스크립트로: 필수 파일 존재, 고지 문장 존재, 금지어 없음
편집장이 하는 일은 글을 쓰는 게 아니라 작가가 틀릴 수 없는 종이를 만드는 것입니다. 그 종이가 좋으면 작가가 열한 명이어도 잡지는 한 권처럼 나옵니다.
기준: 2026-09-21. 브리프·패킷·검수 코드는 이날 실제로 쓴 파일에서 발췌했고, 시간과 파일 수는 저장소 커밋(11:05, 13:01) 기준입니다. 작가 수(11)와 배치는 세션 기록에서 집계했습니다. 삽화는 GPT 이미지 생성, 도식은 직접 제작했습니다.