이 글에는 제휴 링크가 없습니다. TypeSafe AI와 아무 관계가 없고, 게이트웨이는 제가 직접 만들어 쓰는 프로젝트입니다. 삽화는 GPT 이미지 생성, 도식은 직접 제작했습니다.
LLM 게이트웨이에 판정 창구 하나를 더 냈다 — Jev의 계약을 사내 AI 창구에 옮긴 기록
은행에 창구가 하나뿐이라고 해 보세요. 대출 상담도, 잔액 확인도 같은 줄에 섭니다. 잔액 확인은 10초면 되는데 앞사람 대출 상담이 30분이면 다 같이 기다리죠. 그래서 은행은 빠른 창구를 따로 냅니다. 상담은 원래 창구로, 확인·판정은 빠른 창구로.
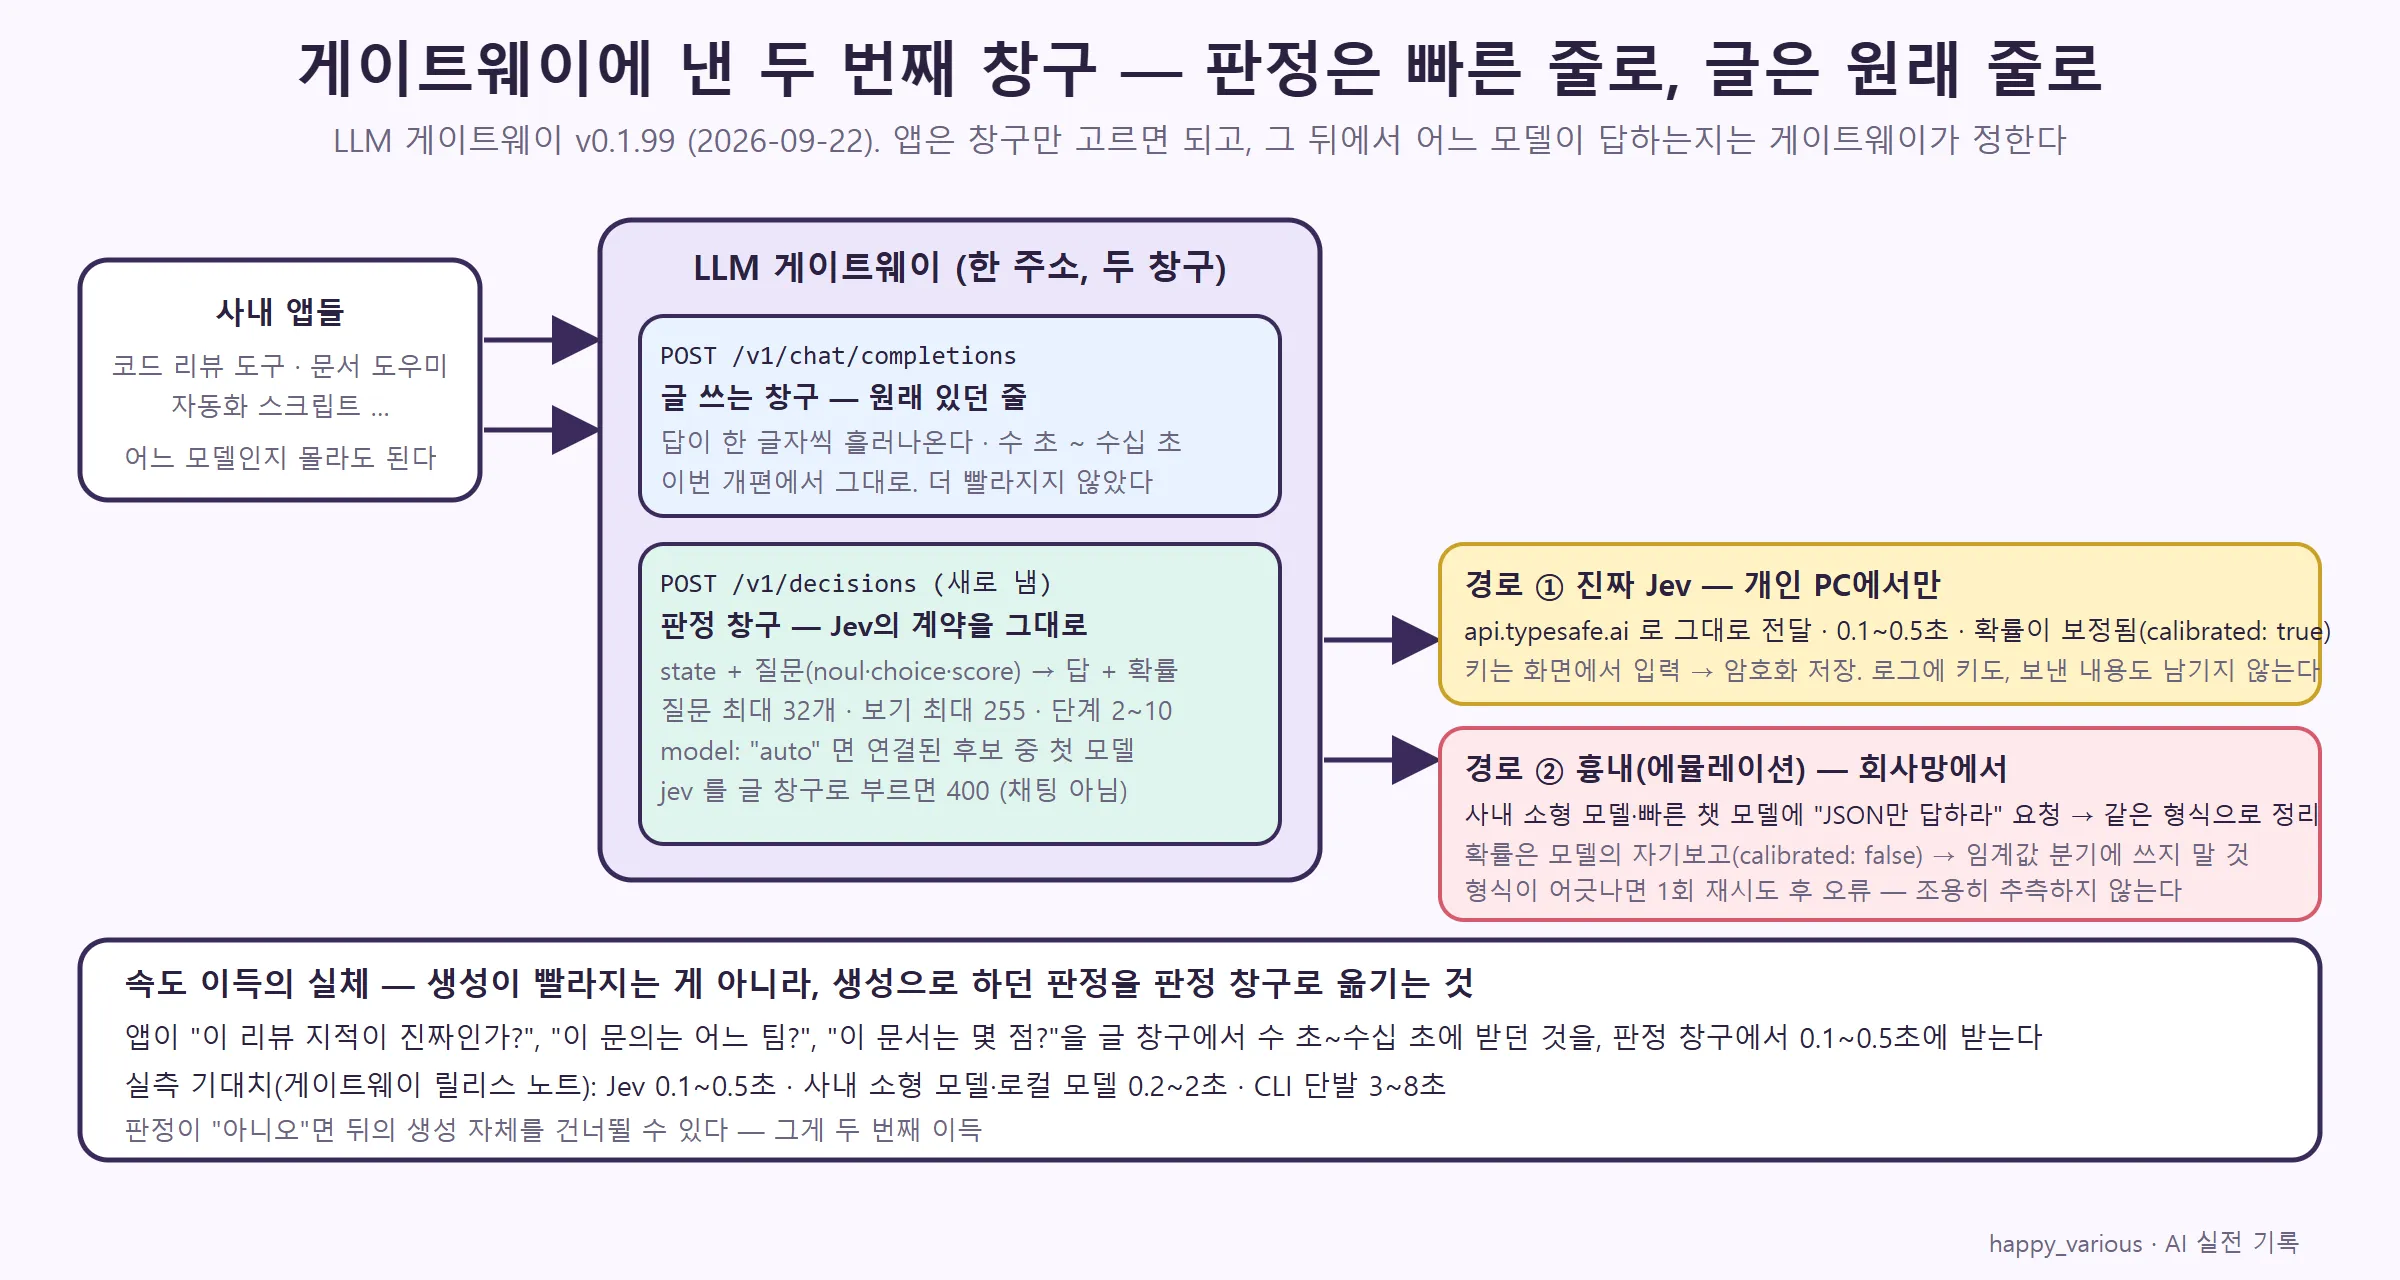
제가 만들어 쓰는 LLM 게이트웨이가 정확히 이 상태였습니다. 회사 앱들이 AI를 쓰는 단일 창구인데, “이 문의는 어느 팀?”, “이 리뷰 지적은 진짜인가?” 같은 판정도 글을 만드는 창구에서 수 초~수십 초에 받고 있었어요. 그래서 2026년 9월 22일, 판정 전용 창구 POST /v1/decisions를 새로 냈습니다. 계약은 1편과 2편에서 본 Jev의 것을 그대로 가져왔어요. 이 글은 그 기록입니다 — 무엇을 왜 만들었고, 어디서 막혔고, 무엇은 빨라지지 않았는지.
결론 요약
- 게이트웨이에 두 번째 창구
POST /v1/decisions를 냈습니다. 상태 + 타입 질문(noul·choice·score) → 답 + 확률. 글 창구(/v1/chat/completions)는 그대로 - 같은 계약을 두 경로가 냅니다. ① 진짜 Jev(개인 PC 전용, 0.1~0.5초, 보정된 확률) ② 흉내(에뮬레이션) — 클라우드에 못 닿는 회사망에서는 빠른 챗 모델에 “JSON만 답하라”고 시켜 같은 형식으로 정리. 확률은 자기보고라
calibrated: false로 표시 - 속도 이득의 실체는 생성이 빨라지는 게 아닙니다. 생성으로 하던 판정을 판정 창구로 옮기고, 판정 결과로 불필요한 생성을 건너뛰는 것
- 키는 화면에서 입력해 암호화 저장, 로그에는 키도 보낸 내용도 남기지 않습니다
🏦 1. 게이트웨이가 뭔지 30초 — 앱은 창구만 안다
LLM 게이트웨이는 회사 안의 앱들(코드 리뷰 도구, 문서 도우미, 자동화 스크립트)이 AI를 부를 때 거치는 단 하나의 주소입니다. 앱은 “어느 모델을 쓸지”를 몰라도 됩니다. 게이트웨이가 회사망 안의 소형 모델, 개인 PC의 로컬 모델, 클라우드 모델 중 연결된 것을 골라 주고, 키와 동시 접속 수와 대기열을 관리합니다. MCP·API·CLI 글의 분류로는 “프로그램이 프로그램을 부르는 API”이고, 앱 입장에서는 리모컨이 하나뿐인 셈이에요.
이 창구가 하나였다는 게 문제였습니다. 글을 만드는 요청과 판정만 필요한 요청이 같은 줄에 섰거든요.
🚪 2. 두 번째 창구 — 계약은 Jev 것을 그대로
릴리스 노트(v0.1.99)의 첫 줄을 옮기면 이렇습니다.
빠른 판정 엔드포인트
POST /v1/decisions— TypeSafe AI Jev(System One Model)의 결정 계약을 게이트웨이 계약으로 채택했다. 텍스트를 생성하지 않고 상태(state) + 타입 질문(noul / choice / score) → 타입 안전한 확률적 결정을 돌려준다.
새 형식을 발명하지 않고 남의 계약을 그대로 채택한 게 이번 설계의 핵심 결정이었어요. 이유는 둘입니다. 첫째, 2편에서 본 대로 그 계약은 이미 잘 설계돼 있습니다(질문 셋, 확률, 확신도). 둘째, 앱 입장에서 “게이트웨이가 Jev를 쓰든 다른 모델을 쓰든 요청·응답 모양이 같다”는 게 창구의 존재 이유이니까요.
게이트웨이가 창구에서 지키는 한도는 공식 한도를 그대로 따르거나 조금 더 보수적입니다 — 질문 최대 32개, Choice 보기 최대 255개, Score 단계 2~10개, 질문 문장 4,000자, 상태는 기본 20만 자에서 먼저 자릅니다(공식 한도는 질문당 32k 토큰·합 64k). 그리고 Jev 모델을 글 창구로 부르면 400 오류로 돌려보냅니다. “모델을 못 찾은 게 아니라 능력이 없는 것”이라고 코드 주석에 적어 뒀어요.
🎭 3. 두 경로 — 진짜와 흉내
여기서 회사 환경의 현실이 끼어듭니다. Jev는 api.typesafe.ai라는 클라우드 서비스예요. 그런데 회사망은 바깥 클라우드에 닿지 않습니다. 개인 PC에서는 되고 회사에서는 안 되는 창구는 창구가 아니죠. 그래서 같은 계약을 두 경로가 내게 만들었습니다.
경로 ① 네이티브 — 진짜 Jev. 게이트웨이에 jev라는 프로바이더를 추가했습니다. 개인 PC 모드에서만 나타나고, 요청을 Jev 공식 주소로 그대로 넘깁니다. 어댑터 코드의 주석 그대로 “결정 계약 그대로 패스스루”. 응답에 calibrated: true가 붙습니다 — 이 확률은 임계값 분기에 써도 된다는 뜻.
경로 ② 에뮬레이션 — 흉내. 회사망에서는 Jev 대신 연결된 빠른 챗 모델(사내 소형 모델, 로컬 모델)에게 구조화된 지시를 보냅니다. “이 상태를 보고 이 질문들에 JSON으로만 답해라.” 지원하는 모델에는 응답 형식(json_schema)까지 강제하고, 생각(추론) 기능은 끄고, 도구 없이 단발로 부릅니다. 돌아온 JSON을 Jev 응답과 같은 모양으로 정리해 돌려줍니다. 단, 확률은 그 모델이 스스로 적어낸 숫자입니다. 1편에서 본 “보정된 확률”이 아니에요. 그래서 응답에 calibrated: false를 붙이고, 앱에게 “이 확률로 임계값 분기를 하지 말고 choice·score 값만 믿어라”고 문서에 적었습니다. JSON이 어긋나면 한 번만 다시 시도하고, 그래도 안 되면 조용히 추측하지 않고 502 오류로 돌려줍니다.
앱이 model: "auto"로 보내면 게이트웨이가 후보를 순서대로 봅니다. 개인 PC에서는 Jev → 로컬 모델 → 클라우드 소형 모델 순, 회사에서는 사내 소형 모델부터. 연결돼 있고 허용되고 지금 받을 수 있는 첫 모델이 답합니다. 앱은 어느 쪽이 답했는지 응답의 calibrated 값으로 알 수 있어요.
⏱️ 4. 속도 이득의 실체 — 생성은 안 빨라진다
이 부분을 릴리스 노트에 굵게 적어 뒀습니다. “텍스트 생성 자체(첫 글자까지의 시간·초당 글자 수)는 바뀌지 않는다.” 판정 창구를 냈다고 글 창구가 빨라지지 않아요. 이득은 두 군데서 옵니다.
- 판정을 옮긴다. 앱이 글 창구에서 “이 리뷰 지적이 진짜인가?”를 문장으로 받아 파싱하던 것을, 판정 창구에서
noul: 0.93으로 받습니다. 릴리스 노트의 실측 기대치는 Jev 0.1~0.5초, 사내 소형·로컬 모델 0.2~2초, 상주 세션 없는 CLI 모델 3~8초 - 판정으로 생성을 건너뛴다. “이 청크는 검토할 가치가 있나?”가 아니오면 뒤의 긴 생성 자체를 하지 않습니다. 이게 더 큰 이득이에요
즉 빨라지는 건 모델이 아니라 앱의 흐름입니다. 문의 분류·검증·점수 매기기는 판정 창구로, 글이 필요한 것만 글 창구로. 이렇게 나누면 글 창구의 줄도 짧아집니다.
🔐 5. 키와 데이터 — 로그에 남기지 않는 것
Jev를 붙이면서 지킨 규칙은 게이트웨이의 다른 프로바이더와 같습니다.
- API 키는 화면(UI 패널)에서 입력하고 암호화 저장소에만 둡니다. 환경변수·코드·로그 금지
- 로그에는 모델 이름·걸린 시간·질문 개수만 남깁니다. 상태(state)와 질문 문구는 절대 남기지 않아요. 상태에는 고객 문의 원문이 들어가니까요
- 회사망 모드에서는 Jev 프로바이더가 목록 자체에서 사라집니다. 연결 시도조차 하지 않도록
- Jev 쪽 오류 429(속도 초과)와 529(과부하)는 같은 재시도 계열로 묶어 2초 뒤 지수 백오프로 재시도합니다 — 2편에서 본 공식 지침 그대로
🧪 6. 검증 — 개발 PC에서 확인한 것
릴리스 노트의 검증 항목입니다. 자동 테스트(npm test, 핵심 게이트)에 더해 실환경 스모크로 — Jev 네이티브를 영어·한국어·객체 상태로, 에뮬레이션을 클라우드 소형 모델 둘로, auto 후보 순서, 모델 특성(traits) 노드, 오류 코드, 그리고 로그에 키와 상태가 없는지. 한국어 상태로도 답이 왔지만, 1편에서 본 대로 문서는 영어 외 언어의 정확도가 같지 않다고 하니 판정 품질은 앱마다 따로 봐야 합니다.
⚠️ 7. 아직 안 한 것과 함정
- 앱 쪽 전환은 이제 시작입니다. 창구를 냈다고 앱이 저절로 옮겨 오지 않아요. 코드 리뷰 도구의 “지적이 진짜인가” 검증, 청크 우선순위 매기기가 첫 후보입니다
- 에뮬레이션의 확률을 믿는 실수.
calibrated: false를 무시하고 0.9 문턱을 걸면 1편의 “자신만만한 환각”이 그대로 돌아옵니다. 문서에 굵게 썼지만, 결국 앱 개발자가 읽어야 합니다 - 판정 결과 캐시(같은 상태·질문이면 재사용), 리뷰 전 선별(판정이 아니오면 건너뜀)은 후속 후보로 남겨 뒀습니다
- Jev는 신제품이라 요금·한도·버전이 바뀔 수 있습니다. 게이트웨이는 응답에 실린 실제 버전(
jev-1.13.0)을 기억해 앱이 고정할 수 있게 노출합니다
🎯 시작 코스 — 회사에 AI 창구가 있다면
- 앱들이 AI에게 보내는 요청을 “글이 필요한 것”과 “판정만 필요한 것”으로 나눠 봅니다. 후자가 생각보다 많습니다
- 판정 요청을 상태 + 질문 셋(어느 것·몇 단계·예/아니오)으로 다시 적어 봅니다. 안 되는 것은 글이 필요한 것
- 창구를 하나 더 냅니다. 계약은 발명하지 말고 이미 있는 것(Jev의 것이 좋은 출발점)을 채택합니다
- 클라우드가 막힌 환경이면 흉내 경로를 같이 두되, 응답에 “흉내”라는 표시(
calibrated: false)를 반드시 붙입니다 - 첫 앱 하나만 옮기고 두 창구의 대기 시간을 비교합니다
빠른 창구를 낸다고 은행원이 빨라지지 않습니다. 줄이 갈라질 뿐이에요. 그런데 대부분의 사람은 잔액 확인만 하러 왔었다는 걸, 줄을 갈라 보면 알게 됩니다.
이전 편: System One 모델 Jev란 · Jev 사용법 — 확신도로 세 갈래
기준: 2026-09-22. 게이트웨이 내용은 제 LLM 게이트웨이 프로젝트의 릴리스 노트 v0.1.99, API 문서, 결정 모듈과 Jev 어댑터 코드, 이날 커밋(“빠른 판정 POST /v1/decisions — Jev(System One) 계약 채택”) 기준입니다. Jev의 계약·한도·오류 코드·재시도 지침은 TypeSafe AI 공식 문서(docs.typesafe.ai — HTTP API, 모델 페이지)를 이날 확인했습니다. 지연 수치는 릴리스 노트의 실측 기대치이며 환경에 따라 다릅니다. 삽화는 GPT 이미지 생성, 도식은 직접 제작했습니다.