이 글에는 제휴 링크가 없습니다. TypeSafe AI와 아무 관계가 없고, 내용은 2026년 9월 22일 공식 발표문과 문서를 확인해 쓴 것입니다. 삽화는 GPT 이미지 생성, 도식은 직접 제작했습니다.
System One 모델 Jev란 — 생각하지 않고 고르기만 하는 AI, 왜 0.5초면 되나
친구 얼굴을 보면 화가 났는지 보자마자 압니다. 근거를 따지지 않아요. 반대로 “왜 화났는지 설명하는 편지”를 쓰려면 한참 걸립니다. 심리학자 대니얼 카너먼은 앞의 것을 빠른 생각(System 1), 뒤의 것을 느린 생각(System 2)이라고 불렀어요.
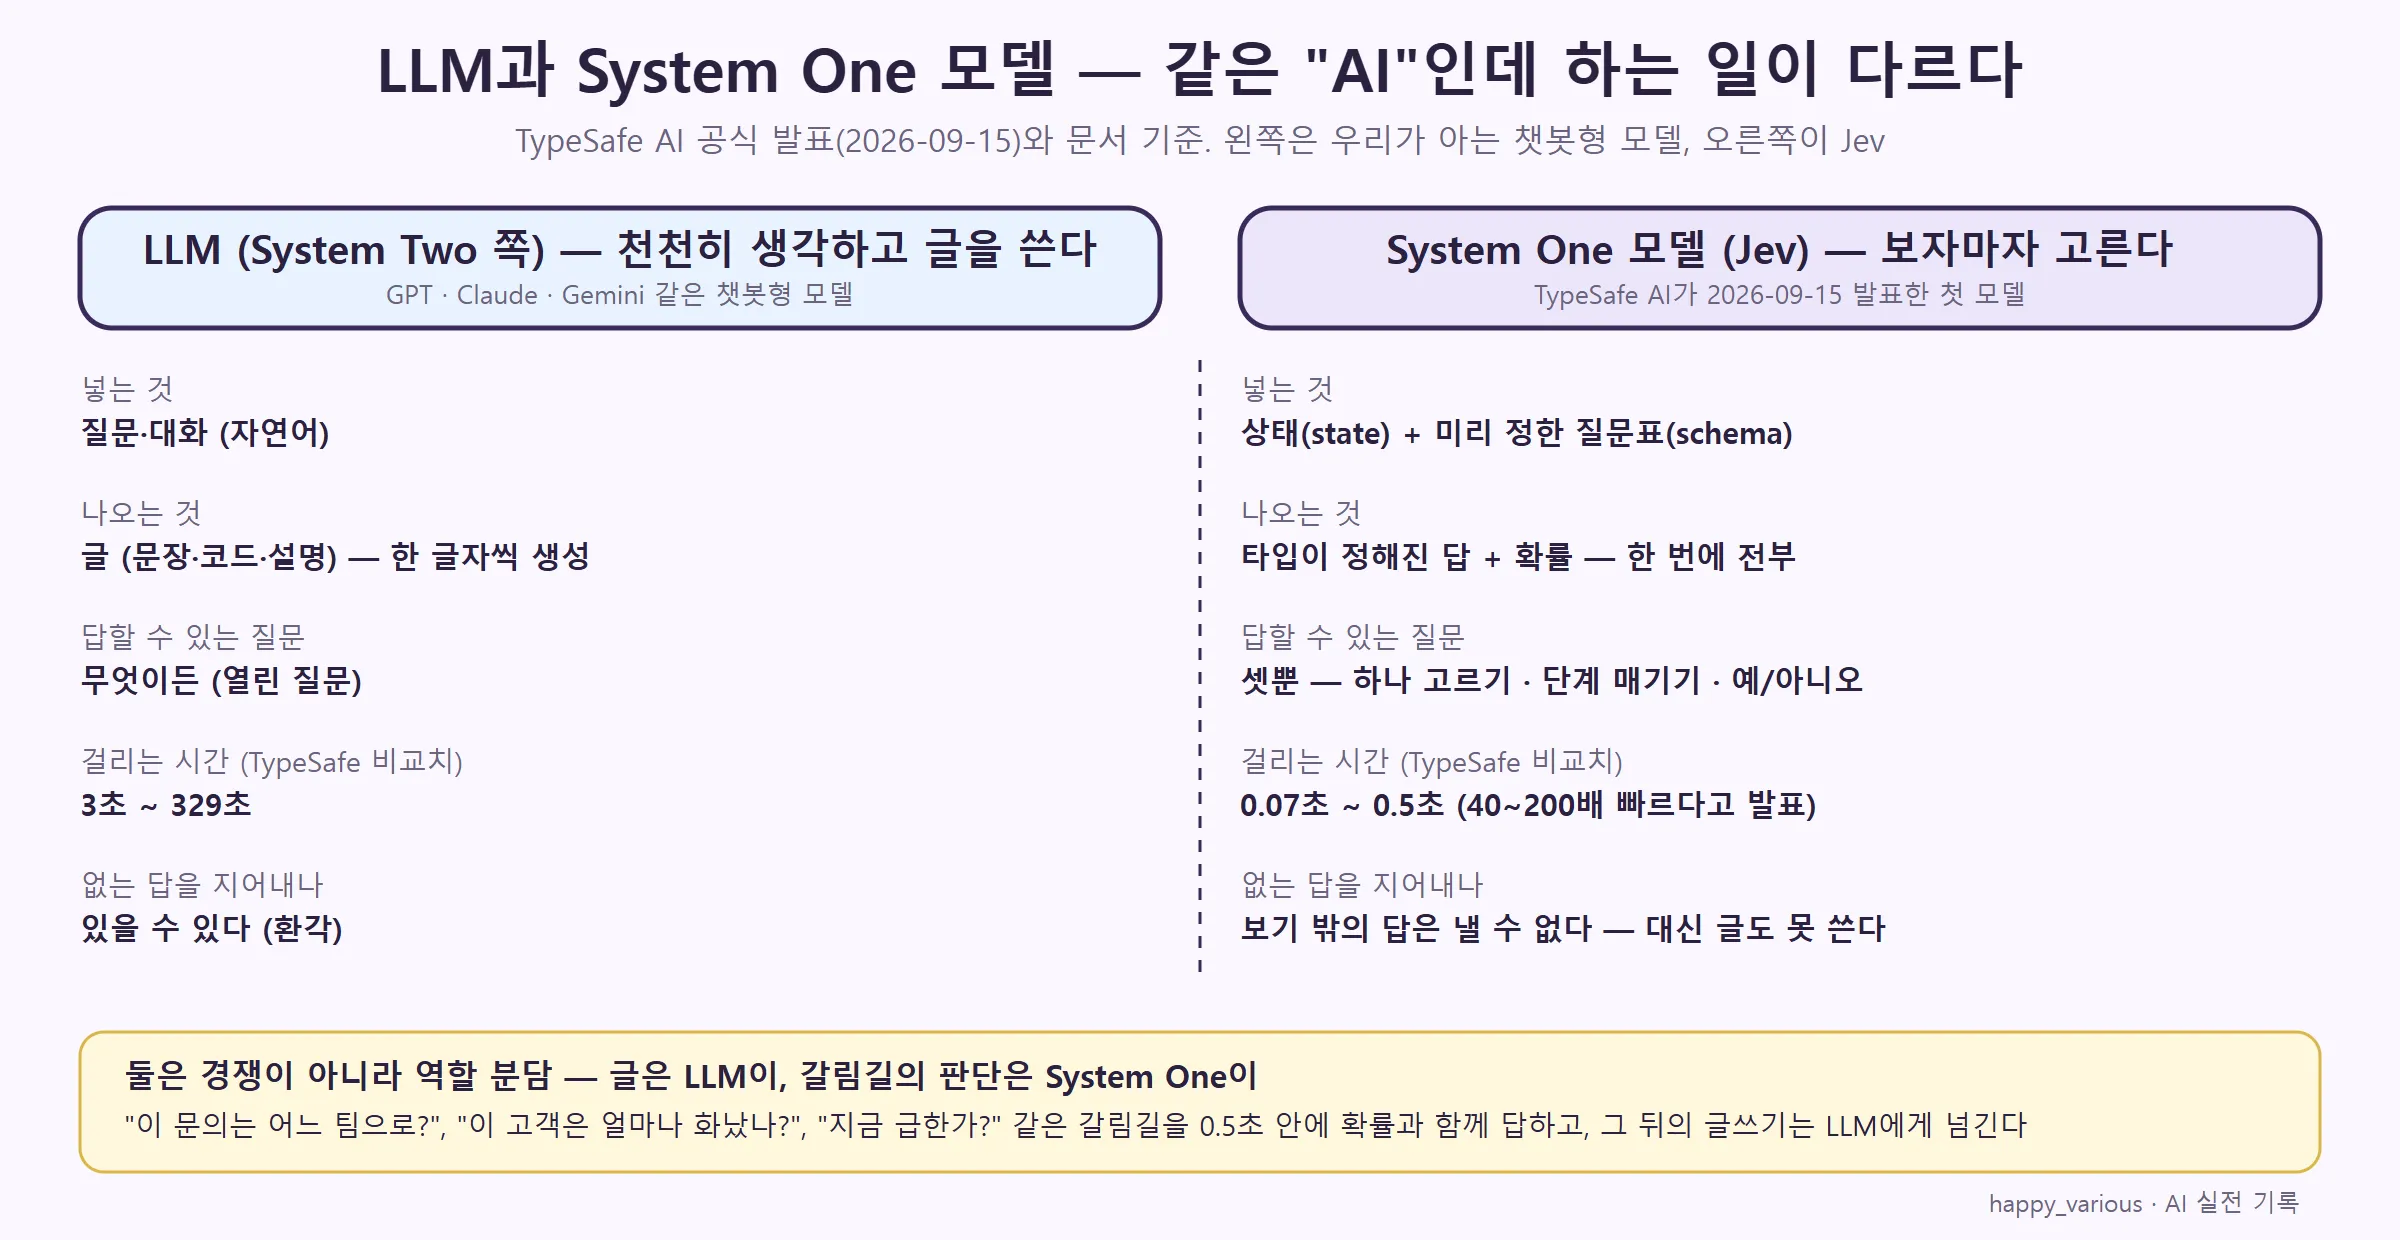
우리가 쓰는 챗봇형 AI(GPT·Claude·Gemini)는 전부 편지를 쓰는 쪽입니다. 한 글자씩 생각하며 글을 만들죠. 2026년 9월 15일, TypeSafe AI라는 회사가 표정을 읽는 쪽의 AI를 내놨습니다. 이름은 Jev, 부류 이름은 System One 모델. 글을 전혀 쓰지 않고, 보기 중에서 고르고, 단계를 매기고, 예/아니오를 확률로 답하는 것만 합니다. 대신 0.5초 안에요. 이 글은 그 부류가 뭔지, 왜 필요한지, 뭘 못 하는지를 공식 문서 기준으로 정리한 3부작의 1편입니다.
결론 요약
- System One 모델 = TypeSafe의 정의로 “소프트웨어가 바로 쓸 수 있는 빠르고 구조화된 결정을 내리도록 만든 새 부류의 모델.” Jev가 그 첫 번째
- 넣는 것은 상태 + 미리 정한 질문표, 나오는 것은 타입이 정해진 답 + 확률. 글은 한 글자도 안 씁니다
- 질문은 셋뿐 — 하나 고르기(Choice), 단계 매기기(Score), 예/아니오(Noul)
- 발표 기준 0.07~0.5초(챗봇형 모델 비교치 3~329초), 입력 100만 토큰당 $0.042, 출력은 무료
- 못 하는 것도 분명합니다. 글쓰기, 계산, 날짜 비교, 애매한 질문. “환각이 없다”는 “보기 밖의 답을 못 낸다”는 뜻이지 “안 틀린다”가 아닙니다
🧠 1. System One 모델이란 — 카너먼에서 따온 이름
TypeSafe의 발표문은 카너먼의 『생각에 관한 생각』을 직접 인용합니다. 빠르고 직관적인 System 1과 느리고 숙고하는 System 2의 구분에서 이름을 땄다고요. 그리고 System One 모델을 이렇게 정의합니다.
“소프트웨어가 바로 쓸 수 있는, 빠르고 구조화된 결정을 내리도록 만들어진 새로운 부류의 프런티어 모델”
핵심은 “소프트웨어가 바로 쓸 수 있는”입니다. 챗봇의 답은 사람이 읽는 글이라, 프로그램이 쓰려면 글에서 값을 다시 파내야 해요. “이 문의는 기술팀으로 보내야 할 것 같습니다”라는 문장에서 ‘기술팀’을 뽑아내는 식이죠. System One 모델은 처음부터 기술팀이라는 값과 0.78이라는 확률을 돌려줍니다. 공식 문서의 표현대로 “글 생성도 없고, 파싱도 없습니다.”
🔀 2. 넣는 것과 나오는 것 — 질문표가 먼저다
챗봇은 질문을 던지면 뭐든 답합니다. Jev는 다릅니다. 먼저 질문표(schema)를 정하고, 답은 그 안에서만 나옵니다. 객관식 시험과 같아요. 보기 ①②③ 중에서만 고르니 ④가 나올 수 없습니다.
넣는 것은 두 가지예요.
- 상태(state) — 판단할 재료. 고객 문의 한 통, 문서 한 장, 주문 내역 같은 것. 문자열이든 JSON이든 됩니다. 단, 글자만 받습니다(이미지·음성 불가)
- 질문표(questions) — “이 문의는 어느 팀?”, “고객이 얼마나 화났나?”, “급한가?” 같은 질문 여러 개를 한 번에 보냅니다. 문서 표현으로 “독립적인 질문들을 함께” 평가해요
나오는 것은 질문마다 답 + 확률 + 확신도입니다. “기술팀 0.78, 결제팀 0.15, 영업팀 0.07”처럼 보기마다 확률이 붙고, 그게 한쪽에 얼마나 몰렸는지가 확신도(confidence)로 따로 옵니다. 이 확신도가 2편의 주인공이에요.
🃏 3. 질문은 딱 셋 — Choice · Score · Noul
공식 문서가 “세 가지 질문 유형(primitives)“이라고 부르는 것입니다.
| 유형 | 묻는 것 | 돌아오는 것 | 예시 | 한도 |
|---|---|---|---|---|
| Choice (하나 고르기) | 정해진 보기 중 하나 | 고른 보기 + 보기별 확률 + 확신도 | “어느 팀이 맡아야 하나: 결제·기술·영업” | 보기 최대 255개 |
| Score (단계 매기기) | 순서가 있는 단계 중 어디 | 가중 평균 점수 + 단계별 확률 + 확신도 | “얼마나 화났나: 차분함·짜증·격분” | 단계 2~10개 |
| Noul (예/아니오) | 문장이 참인가 | 0~1 확률 하나 | “급하다고 말하고 있나” | — |
문서의 조언이 재미있습니다. Score의 단계는 “매우 심각” 같은 정도 표현이 아니라 구체적 상황으로 적으라고요(“깨졌지만 우회 방법 있음”, “막혔고 우회 없음”). Noul은 “화났고 그리고 환불 요구하나?”처럼 두 조건을 한 질문에 넣지 말고 둘로 나누라고 합니다. 질문을 잘게 쪼갤수록 답이 정확해지는 구조예요.
⚡ 4. 왜 빠르고 싼가 — 한 글자씩이 아니라 한 번에
챗봇형 LLM은 답을 한 글자(토큰)씩 만듭니다. 문장이 길수록 오래 걸리고 비쌉니다. Jev는 발표문 표현으로 “한 번의 병렬 처리(single parallel pass)“로 모든 답을 동시에 냅니다. 애초에 글을 안 만드니까요.
발표문의 수치입니다(TypeSafe 자체 비교).
- 응답 시간 70ms~500ms — 비교 대상 프런티어 모델은 3초~329초, 그래서 40~200배 빠르다고 주장
- 요금 입력 100만 토큰당 $0.042, 출력은 무료 — 문서 표현으로 “너무 싸서 계량하지 않음(too cheap to meter)”. 글을 안 만드니 출력 요금이 붙을 게 없는 구조
- 비교 대상은 GPT-5.6 Terra, GPT-6 Astra, Fable 5.1
수치는 회사 발표이니 그대로 믿기보다 구조를 보면 됩니다. 글을 안 쓰는 모델은 글 길이만큼의 시간과 돈이 원리적으로 안 듭니다. 그게 System One이 빠른 이유예요.
🎯 5. “보정된 확률”이 진짜 차이 — 90%라고 하면 90% 맞아야
Jev가 확률을 돌려주는 것 자체는 새롭지 않습니다. 새로운 건 그 확률이 보정(calibrated)돼 있다는 주장이에요. TypeSafe 문서의 정의는 이렇습니다.
“0.2의 확률을 받은 결과는 약 20%의 빈도로 일어나야 하고, 0.8의 확률을 받은 결과는 약 80%의 빈도로 일어나야 한다.”
이걸 위해 RLCD(Reinforcement Learning for Calibrated Decisions)라는 학습법을 새로 만들었다고 합니다. 챗봇형 모델의 학습(RLHF)은 “사람이 선호하는 답”을 향해 조정되기 때문에, 문서 표현으로 “자신만만하게 들리는 환각”이 생길 수 있다는 게 그들의 진단이에요. 반면 결정 모델은 확률을 실제 맞은 빈도에 맞춰 조정합니다.
왜 이게 중요할까요. 확률이 믿을 만해야 프로그램이 그 숫자로 갈림길을 만들 수 있기 때문입니다. “0.9 넘으면 자동, 그 아래면 사람에게” 같은 규칙은 0.9가 진짜 90%일 때만 의미가 있어요.
⚠️ 6. 못 하는 것 — 문서가 스스로 적어둔 약점
TypeSafe는 문서에 “Jev 1.13의 들쭉날쭉함(jaggedness)“이라는 페이지를 따로 두고 약점을 적어뒀습니다. 비개발자에게 중요한 것만 옮깁니다.
- 글을 못 씁니다. 발표문 그대로 “글 생성을 포기했다.” 요약·번역·답장 작성은 LLM의 일
- 계산기가 아닙니다. 글자 수 세기, 단어 등장 횟수, 긴 목록의 항목 수가 불안정하고, 색상값 같은 숫자의 가까움도 못 잽니다
- 날짜를 글자로 읽습니다. 순서 비교, 기간 계산, “분기”나 “정산 기간” 같은 경계 판단이 약합니다
- 적힌 그대로 답합니다. 문서 표현으로 “당신이 쓴 질문에 답하지, 당신이 의도한 질문에 답하지 않는다.” 이중 부정, 여러 단계 추론, 암묵적 조건이 약합니다
- 관계없는 재료가 많으면 정확도가 떨어집니다. 상태에 결정과 무관한 내용이 늘수록 방해가 됩니다
- 상태 안의 지시문을 의심하지 않습니다. 입력을 “적대적으로 보지 않는다”고 명시돼 있어요. 누가 문의 글에 “이건 급한 거야”라고 써 넣으면 영향을 받을 수 있습니다
- 언어는 영어가 기본. 한국어를 포함한 다른 언어도 지원하지만 “같은 수준은 아니다”라고 문서가 밝힙니다
그래서 “환각이 없다”는 말을 정확히 읽어야 합니다. 보기 밖의 답이나 형식이 깨진 답은 나올 수 없다는 뜻이지, 고른 답이 항상 옳다는 뜻이 아닙니다. 틀릴 수 있고, 틀릴 때 확률이 낮게 나오도록 만든 것뿐이에요.
🧩 7. 그래서 어디에 쓰나 — 글은 LLM이, 갈림길은 System One이
TypeSafe 문서의 원칙 한 줄이 이 모델의 자리를 정확히 말해줍니다.
“코드가 결정론적인 일을 처리하고 흐름을 소유한다. 모델은 시스템에 ‘프로그래밍 가능한 상식’이 필요한 곳에만 나타난다.”
즉 Jev는 자율 에이전트가 아니라, 프로그램 흐름 속의 갈림길 하나입니다. 문서의 사용처 지도에서 몇 개만 옮기면 — 고객 문의를 팀별로 분류하고 급한 것을 먼저 올리기, 검색 결과의 순위 다시 매기기, LLM의 입력·출력·도구 호출마다 안전 검사 넣기(문서 표현으로 “훨씬 낮은 비용으로”), 어떤 LLM에 보낼지 고르는 라우터 만들기, 채용 서류를 기준에 맞춰 점수 매기기.
공통점이 보이시죠. 전부 “고르기·매기기·판정하기”이고, 글을 만드는 일은 하나도 없습니다. 글이 필요한 단계는 그 뒤에서 LLM이 맡습니다. 둘은 경쟁이 아니라 역할 분담이에요. 코딩 에이전트 문서도 같은 말을 합니다 — “Jev는 코딩 에이전트의 LLM을 대체하지 않는다. 에이전트가 만드는 앱 안에서 구조화된 결정을 맡는다.”
🎯 시작 코스 — 개념만 잡고 싶다면
- 내 업무에서 “어느 것 / 몇 점 / 예·아니오”로 끝나는 판단을 세 개만 적어 봅니다. 문의 분류, 우선순위, 규정 위반 여부 같은 것
- 각 판단에 보기나 단계를 구체적 상황으로 적어 봅니다. “심각함”이 아니라 “막혔고 우회 없음”처럼
- 그 판단이 틀렸을 때의 비용을 생각해 봅니다. 클수록 확신도 문턱을 높여야 합니다 — 이게 2편의 내용
- 판단 뒤에 글이 필요한지 봅니다. 필요하면 그 부분은 LLM 몫으로 남겨 둡니다
표정을 읽는 사람과 편지를 쓰는 사람이 다르듯, 고르는 AI와 쓰는 AI가 다릅니다. Jev는 앞의 것만 하기로 한 모델이고, 그래서 0.5초면 됩니다.
다음 편: Jev 사용법 — 상태와 질문표를 보내면 확신도가 돌아온다 · 3편: LLM 게이트웨이에 판정 창구를 더 낸 기록
기준: 2026-09-22. 정의·인용·수치는 TypeSafe AI 공식 발표문 “Introducing System One Models & Jev”(2026-09-15)와 공식 문서(docs.typesafe.ai — 소개, System One 개념, 질문 유형 Choice·Score·Noul, 확신도, AI 입문서, 모델 페이지, Jev 1.13 들쭉날쭉함, 코딩 에이전트, 사용처 지도)를 이날 직접 확인했습니다. 발표 당시 얼리액세스였고, 모델 문서 페이지는 이날 기준 jev-1.13.0을 정식 제공으로 표기합니다. 속도·비용 비교는 TypeSafe 자체 수치입니다. 삽화는 GPT 이미지 생성, 도식은 직접 제작했습니다.