이 글에는 제휴 링크가 없고 OpenAI·앤트로픽과 아무 관계가 없습니다. 제가 직접 만든 중계기의 개발 기록을 바탕으로 썼습니다. 삽화는 GPT 이미지 생성, 도식은 직접 제작했습니다.
부를 때마다 새로 켤까, 켜 둔 채 쓸까 — 콜택시와 정류장에서 기다리는 셔틀버스 (LLM 중계기 개발기)
역에서 집까지 가는 방법이 두 가지 있다고 해 볼게요. 하나는 콜택시예요. 부르면 나만을 위한 차가 오고, 내리면 떠납니다. 깔끔하지만 부를 때마다 차가 올 때까지 기다려야 하죠.
다른 하나는 정류장에 시동을 켜 둔 채 기다리는 셔틀버스예요. 가서 타기만 하면 바로 출발합니다. 대신 버스는 손님이 없어도 그 자리를 차지하고, 앞 손님이 두고 내린 물건이 남아 있을 수도 있어요. 막차가 끝나면 누군가 차를 정리해야 하고요.
제가 만든 LLM 중계기도 AI를 부를 때마다 이 둘 중 하나를 골라야 했습니다.
이 글은 LLM 중계기 개발기의 6편입니다. 지난 5편 「AI마다 다른 플러그를 같은 어댑터로」에서는 연결 방식이 제각각인 AI를 어댑터라는 같은 약속으로 묶는 이야기를 했어요. 이번에는 그 어댑터 뒤에서 AI 프로그램을 언제 켜고 언제 끄는지를 다룹니다.
결론 요약
- 두 방식 — 요청마다 AI 프로그램을 새로 켜는 콜택시 방식은 깔끔하지만 매번 시동 시간이 들고, 켜 둔 채 다시 쓰는 셔틀 방식은 빠르지만 메모리와 정리 규칙이 필요합니다
- Codex — 큰 셔틀 한 대(앱 서버)를 켜 두고, 요청이 올 때마다 그 안에 새 대화방을 엽니다
- Claude — 켜는 비용이 커서 ‘어떤 프로그램이 · 어떤 모델을 · 어떤 생각 강도로’ 부르는지마다 전용 세션을 켜 두고 다시 씁니다. 최대 6개까지, 5분 동안 안 쓰면 정리해요
🚕 1. 명령어 도구 AI는 ‘켜야’ 대답한다
인터넷 주소로 부르는 AI(API)는 서비스 쪽 서버에서 늘 돌아가고 있어요. 내 컴퓨터에서 따로 켜고 끌 것이 없죠.
Codex와 Claude의 명령어 도구(CLI)는 다릅니다. 내 컴퓨터에서 실행되는 프로그램이에요. 중계기가 이 AI에게 질문을 전하려면 먼저 그 프로그램을 실행해야 합니다. 개발자들은 실행 중인 프로그램 하나를 프로세스(process)라고 불러요.
프로그램을 켤 때는 이런 준비가 필요해요.
- 프로그램을 띄우고
- 이 컴퓨터의 로그인 상태를 확인하고
- 대화할 준비를 마치기
이 준비가 끝나야 첫 글자가 나옵니다. 준비 시간은 컴퓨터마다 다르고, 처음 실행이 느린 환경에서는 답을 만드는 시간보다 준비 시간이 훨씬 길기도 했어요.
🚌 2. 콜택시 방식과 셔틀 방식
콜택시 방식 — 요청마다 새로 켜기 요청이 오면 프로그램을 켜고, 답을 받고, 끕니다. 요청 하나에 차 한 대예요.
- 좋은 점 — 요청끼리 완전히 나뉩니다. 앞 요청의 기억이 남을 곳이 없고, 끝나면 꺼지니 따로 정리할 것도 없어요
- 아쉬운 점 — 요청마다 시동 시간을 냅니다. 열 번 부르면 열 번 켜요
셔틀 방식 — 켜 둔 채 다시 쓰기 한 번 켜 둔 프로그램에 다음 요청, 그다음 요청을 이어서 태웁니다.
- 좋은 점 — 시동은 처음 한 번만이에요. 두 번째 요청부터는 바로 출발합니다
- 아쉬운 점 — 켜 둔 프로그램이 메모리를 계속 차지하고, 앞 대화의 기억이 남을 수 있어요. 언제 정리할지도 정해야 하고요
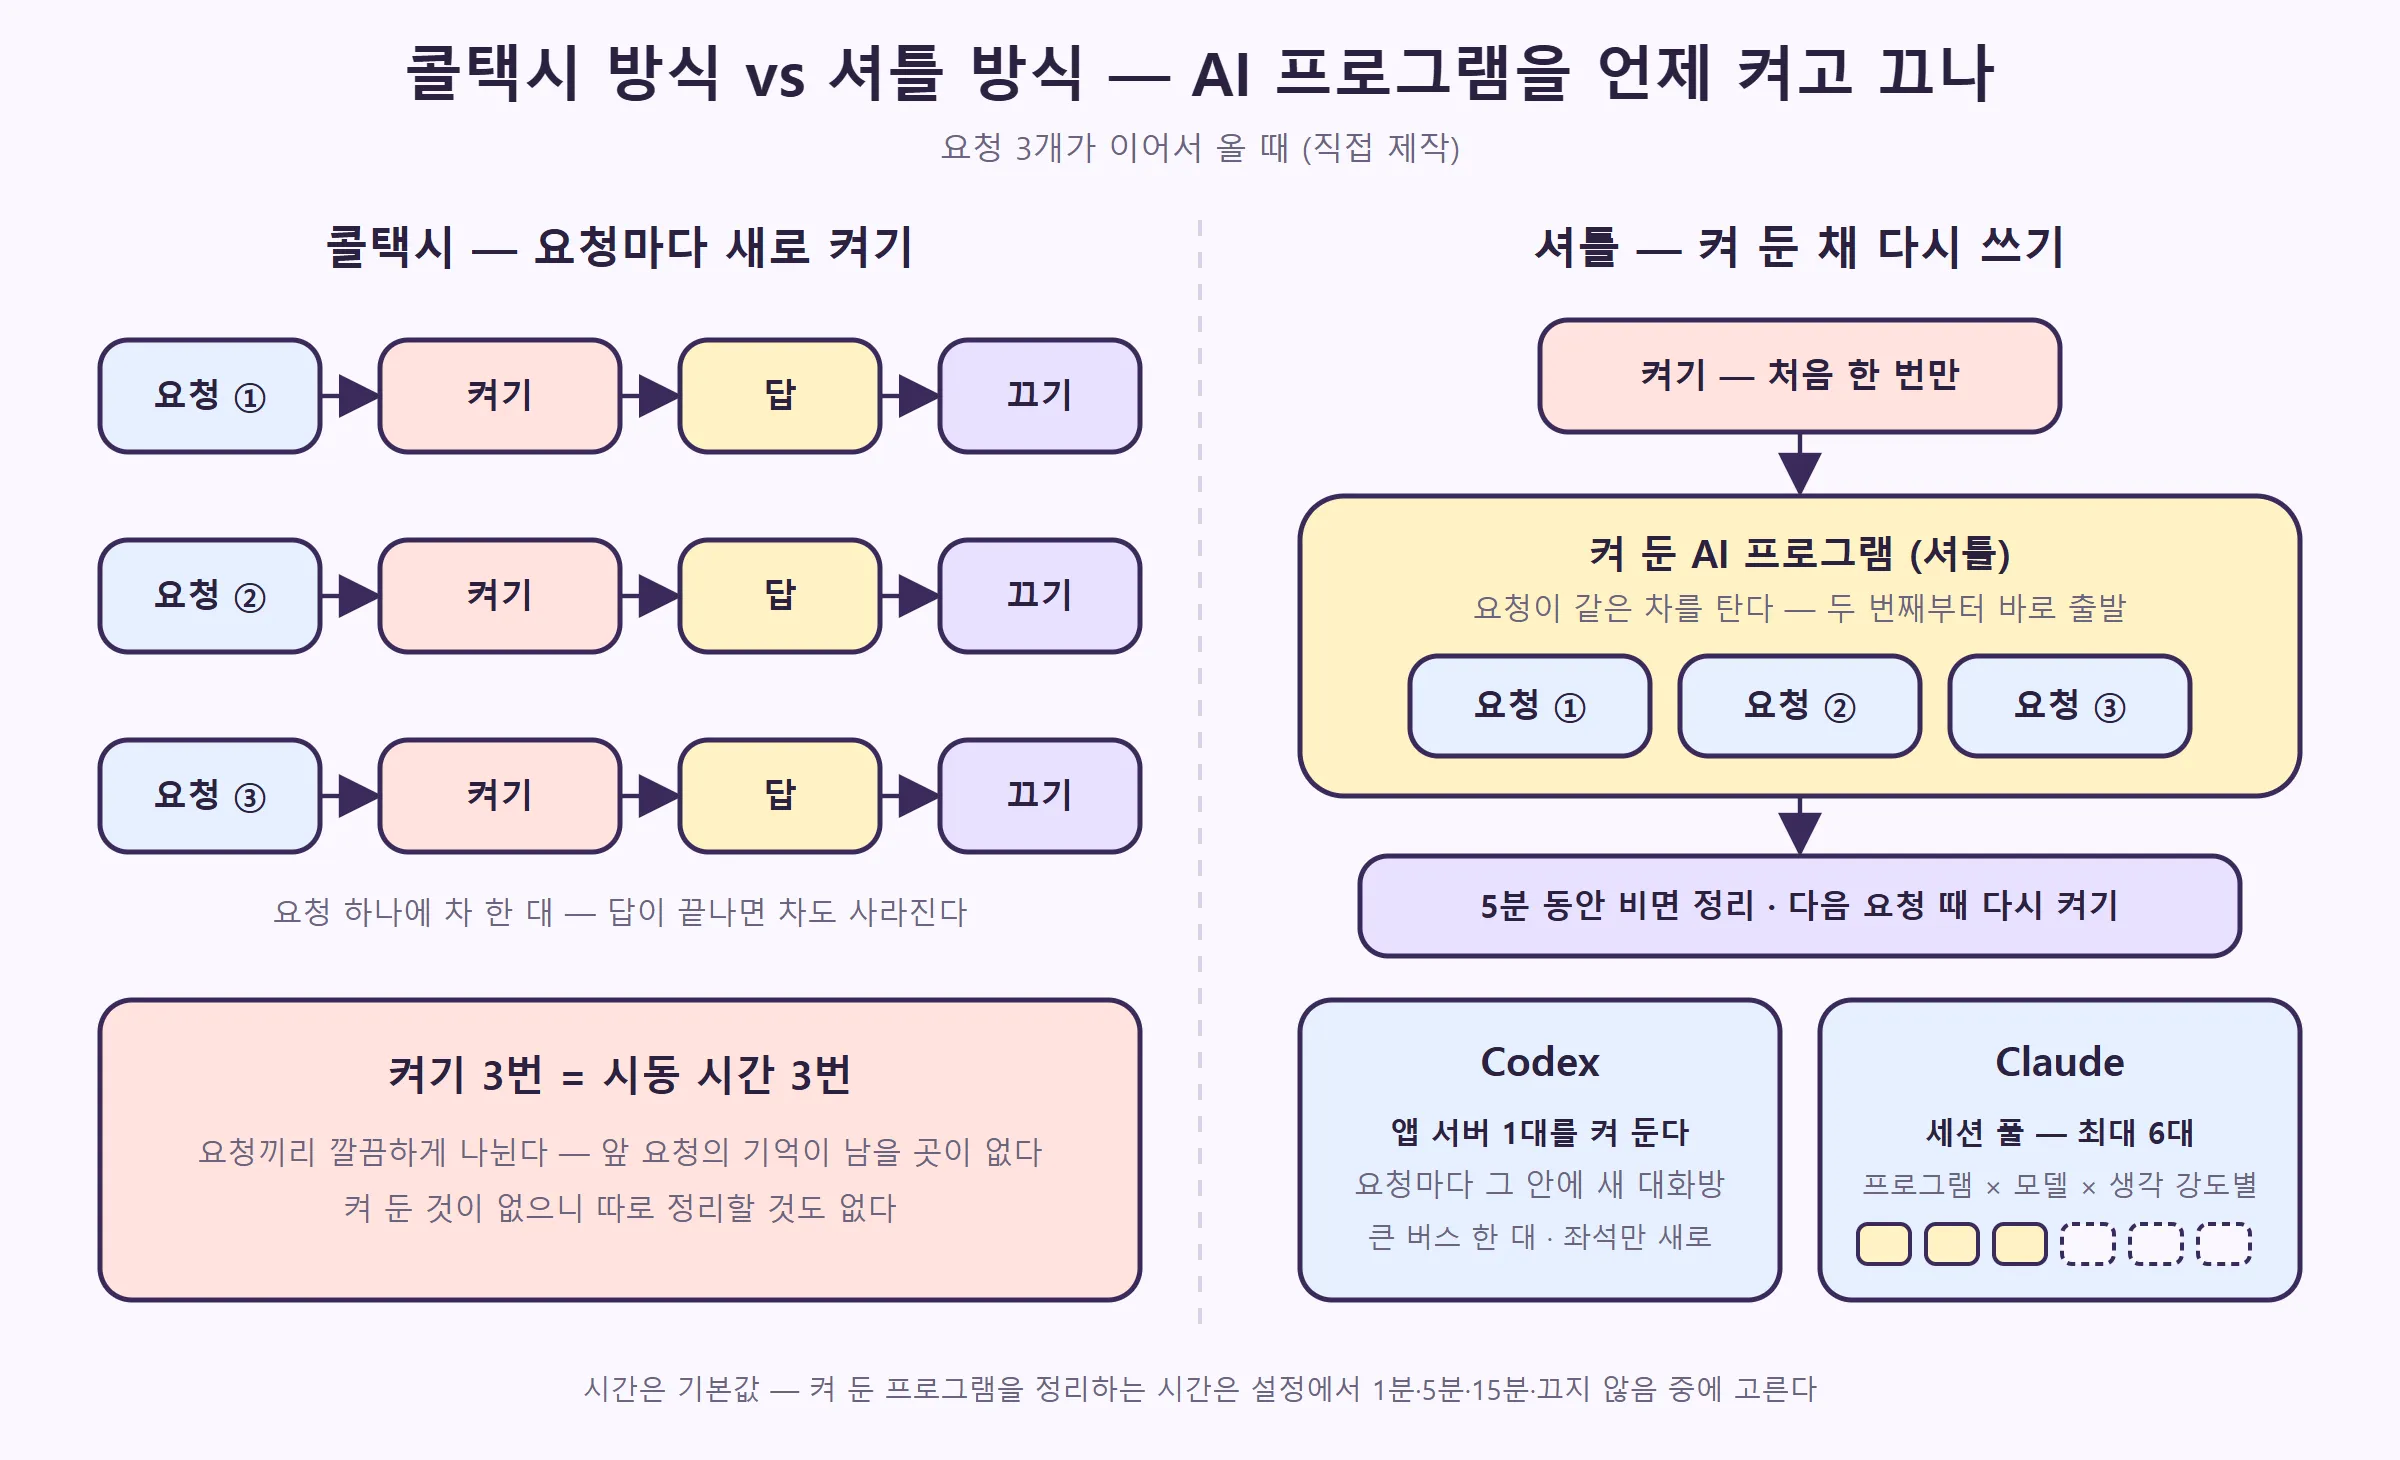
한 줄씩 나란히 놓으면 이렇습니다.
| 비교 | 콜택시 (새로 켜기) | 셔틀 (켜 둔 채 쓰기) |
|---|---|---|
| 속도 | 요청마다 시동 시간이 든다 | 처음 한 번만 들고, 그다음은 빠르다 |
| 기억 섞임 위험 | 없다 — 매번 새 차 | 있다 — 누구를 같은 차에 태울지 규칙이 필요하다 |
| 메모리 | 답하는 동안만 쓴다 | 켜 둔 만큼 계속 쓴다 |
| 정리 | 필요 없다 — 끝나면 꺼진다 | 필요하다 — 오래 빈 차는 돌려보낸다 |
중계기는 Codex와 Claude 모두 셔틀 쪽을 골랐어요. 다만 셔틀의 모양은 둘이 다릅니다.
🔥 3. 워밍업 — 미리 데워 둔 엔진
셔틀 방식에서 자주 나오는 말이 워밍업(warm-up)이에요. 추운 날 엔진을 미리 데워 두면 손님이 타자마자 출발할 수 있죠.
중계기는 Claude를 연결할 때 가장 가벼운 모델로 프로그램을 한 번 켜서 “ok라고만 답해” 같은 짧은 질문을 던져 봐요. 연결이 잘 됐는지 확인하는 김에 엔진을 데워 두는 거예요. 나머지 모델은 그 모델로 첫 요청이 올 때 켜집니다. 중계기 화면에는 이 상태가 ‘워밍업 중’, ‘준비 완료’처럼 표시돼요.
이렇게 데워 둔 세션은 아직 주인이 없는 상태예요. 처음 요청을 보낸 프로그램이 그 세션을 그대로 가져가고, 그때부터 그 프로그램 전용이 됩니다. 아직 아무 대화도 오가지 않은 차라서 누가 먼저 타도 문제가 없어요.
셔틀 방식에는 든든한 전제가 하나 있어요. 중계기는 요청마다 지금까지의 대화 전체를 AI에 다시 건넵니다. 쓰는 쪽 프로그램이 대화를 통째로 보내 주는 게 ‘OpenAI 호환’ 방식의 보통 사용법이거든요. 그래서 켜 둔 프로그램을 정리해도 대화 내용은 잃지 않아요. 잃는 건 다시 켜는 시간뿐입니다. 켜 둔 세션은 결국 빨리 가기 위한 준비물이에요.
🚍 4. Codex — 큰 셔틀 한 대, 손님마다 새 대화방
Codex 명령어 도구에는 앱 서버(app server)라는 실행 방식이 있어요. 한 번 켜 두면 계속 떠 있으면서 여러 대화를 받아 주는 방식이에요. 중계기는 이 앱 서버를 하나 켜 두고 계속 씁니다.
그리고 요청이 올 때마다 그 안에 새 대화방(thread)을 하나 엽니다. 대화방은 버스 안의 좌석 같은 거예요.
- 손님이 늘어도 버스는 늘지 않아요. 대화방은 앱 서버 안의 가벼운 칸이라 프로그램이 새로 뜨지 않거든요
- 이미 켜져 있는 앱 서버에 “새 대화방 하나 열어 줘”라고 한 번 부탁하면 끝이에요
- 비싼 시동은 앱 서버를 켤 때 한 번만 냅니다
사실 Codex는 한 바퀴를 돌았어요. 처음엔 요청마다 새 대화방을 열었고, 첫날 오후에는 모델마다 대화방을 하나씩 열어 두고 같이 쓰는 쪽으로 바꿨습니다. 그러다 8월 업데이트부터 다시 요청마다 새 대화방이 기본이 됐어요. 같이 쓰는 대화방에는 앞 손님의 이야기가 남거든요. 예전 방식은 설정 하나로 되돌릴 수 있게 남겨 두었습니다.
🚐 5. Claude — 프로그램별 전용 미니 셔틀, 최대 6대
Claude 쪽은 사정이 달라요. 중계기에서 Claude 세션 하나는 켜 둔 프로그램 하나이고, 그 안에서는 대화가 하나만 이어집니다. 그래서 큰 버스에 좌석만 늘리는 대신 작은 셔틀을 여러 대 굴려요.
처음엔 Claude도 콜택시였어요. 요청마다 프로그램을 새로 켰는데, 켜는 비용이 커서 첫날 오후에 켜 둔 채 쓰는 방식을 기본으로 바꿨습니다.
지금의 규칙은 이렇습니다.
- 어떤 차에 태울지 — ‘어떤 프로그램이 · 어떤 모델을 · 어떤 생각 강도로’ 부르는지가 같으면 같은 셔틀을 다시 탑니다. 셋 중 하나라도 다르면 다른 셔틀이에요. 생각 강도는 AI가 답하기 전에 얼마나 깊이 생각할지 고르는 설정이에요
- 최대 몇 대 — 한꺼번에 6대까지예요. 7번째가 필요하면 쉬고 있는 셔틀 중 가장 오래 안 쓴 것부터 돌려보냅니다. 손님을 태우고 달리는 셔틀은 건드리지 않아요
- 오래 쉰 차는 새 차로 — 같은 프로그램이라도 5분 넘게 쉬었다가 오면 묵은 셔틀 대신 새 셔틀을 내줍니다. 처음엔 90초였는데, 가끔 쓰는 프로그램이 올 때마다 엔진을 다시 데우지 않도록 5분으로 늘렸어요
- 아무도 안 오면 차고로 — Codex든 Claude든 5분 동안 요청이 하나도 없으면 켜 둔 프로그램을 모두 꺼서 메모리를 돌려줍니다. 이 시간은 설정 화면에서 1분·5분·15분·끄지 않음 중에 고를 수 있어요
상한을 둔 이유는 메모리예요. 셔틀 한 대가 곧 실행 중인 프로그램 하나라서, 수를 정하지 않으면 프로그램이 끝없이 늘 수 있습니다. 설계 메모에는 세션 하나를 대략 150~300MB로 어림해 두었어요.
셔틀만 있는 것도 아니에요. 쓰는 쪽 프로그램이 “이번 요청은 기억 없이 따로 처리해 줘”라는 표시를 붙이면, Claude는 그 요청만 콜택시처럼 새로 켜서 처리하고 끝냅니다. 시동 시간은 그 요청이 부담하고, 다른 셔틀에는 영향이 없어요.
그런데 왜 굳이 ‘프로그램별로’ 셔틀을 나눴을까요? 켜 둔 채 쓰기 시작하자 새 문제가 생겼거든요. 서로 다른 프로그램의 대화가 한 셔틀 안에서 섞일 수 있었어요. 이 사고는 3부의 14편에서 따로 다룹니다.
정리
① AI 명령어 도구는 내 컴퓨터에서 켜야 대답하는 프로그램이라, 요청마다 새로 켤지 켜 둔 채 쓸지를 정해야 해요 ② 새로 켜기는 깔끔하지만 매번 시동 시간이 들고, 켜 둔 채 쓰기는 빠르지만 메모리·기억 섞임·정리 규칙을 챙겨야 해요 ③ 중계기는 Codex는 앱 서버 하나에 요청마다 새 대화방, Claude는 프로그램별 세션을 최대 6개까지 켜 두고 5분 쉬면 정리해요 — 다음 편은 “AI가 엉뚱한 메모를 읽고 왔다”입니다
2026년 10월 1일 기준입니다. 제가 만든 중계기의 개발 기록을 바탕으로 썼고, 특정 기업·서비스의 공식 입장이 아닙니다.