이 글에는 제휴 링크가 없고 앤트로픽과 아무 관계가 없습니다. 성능·가격 수치는 앤트로픽 공식 발표(2026-09-28)와 공식 문서 기준이며 독립 검증 전입니다. 삽화는 GPT 이미지 생성, 차트는 직접 제작했습니다.
Claude Sonnet 5.5 출시 — 가격은 그대로, 30% 빨라졌다. Sonnet 5·Opus 5.5와 벤치마크로 비교
자동차 신형이 나왔는데 가격표가 작년과 똑같다고 해 볼게요. 그런데 보닛을 열어 보니 엔진은 윗급 모델에 들어가던 것과 거의 같은 물건이에요. 그러면 고민이 생깁니다. “윗급을 살 이유가 남았나?”
2026년 9월 28일 앤트로픽이 내놓은 Claude Sonnet 5.5가 그런 모양이에요. 사흘 전 Opus 5.5 출시 글에서 윗급 모델 이야기를 했는데, 이번에는 그 아랫급이 가격은 그대로 둔 채 성능을 끌어올렸습니다. 회사의 첫 문장은 이렇습니다. “Sonnet 5보다 확실히 나아졌고, 30% 이상 빠르며, 대부분의 일에서 비용이 최대 30% 적게 든다.”
⚠️ 이 글의 성능·가격 수치는 2026-09-28 앤트로픽 공식 발표와 공식 문서를 옮긴 것입니다. 회사가 직접 잰 값이라 독립 검증 전이고, 측정 설정이 다른 항목은 따로 표시했습니다.
결론 요약
- 무엇 — Claude 5.5 계열의 두 번째 모델. API 이름은
claude-sonnet-5-5이고, Claude 앱과 API, AWS·구글 클라우드·마이크로소프트 애저에서 쓸 수 있습니다. 가볍고 많이 쓰는 용도의 Haiku 5.5는 “앞으로 몇 주 안에” 나온다고 예고했어요 - 이전 버전(Sonnet 5) 대비 — 가격은 그대로(100만 토큰당 입력 $2, 출력 $10), 답을 내는 속도는 30% 이상 빨라졌고, 공식 표의 8개 지표가 모두 올랐습니다. 터미널 코딩 지표는 10.3%에서 70.6%로 뛰었어요
- Opus 5.5 대비 — 값은 절반인데, 터미널 코딩 지표는 Sonnet 5.5가 앞서고 실무 지표(GDPval-AA)는 2점 차까지 따라붙었어요. 다만 나머지 6개는 Opus 5.5가 높고, 앤트로픽 스스로 “길게 판단해야 하는 복잡한 일은 Opus 5.5가 여전히 확실히 낫다”고 적었습니다
🧭 1. 어떤 자리의 모델인가
앤트로픽은 두 모델의 역할을 이렇게 나눴어요.
- Opus 5.5 — 신중한 판단이 필요한 복잡한 일
- Sonnet 5.5 — 범위가 정해진 일상 업무, 버그 고치기, 깔끔한 문서·슬라이드·스프레드시트 만들기. “디자인 감각도 좋다”고 덧붙였어요
공식 문서의 모델 비교표에서는 Sonnet 5.5를 속도와 지능의 가장 좋은 조합이라고 소개합니다. 응답 속도 칸에는 Opus 5.5가 ‘보통’, Sonnet 5.5가 ‘빠름’으로 적혀 있어요.
💰 2. 가격과 스펙 — 이전 버전과 같은 값
| 항목 | Sonnet 5 | Sonnet 5.5 | Opus 5.5 |
|---|---|---|---|
| 입력 토큰 (100만 개당) | $2 | $2 | $4 |
| 출력 토큰 (100만 개당) | $10 | $10 | $20 |
| 캐시 읽기 (100만 개당) | $0.20 | $0.20 | $0.20 |
| 캐시 쓰기, 5분 (100만 개당) | $2.50 | $2.50 | $5 |
| 한 번에 읽는 분량 (컨텍스트) | — | 100만 토큰 | 100만 토큰 |
| 한 번에 쓰는 최대 분량 | — | 12만 8천 토큰 | 12만 8천 토큰 |
| 기본 생각 강도 (API) | — | high | medium |
몇 가지를 짚어 둘게요.
- 가격 동결 — Sonnet 5의 $2/$10은 원래 8월 말까지의 출시 기념 가격이었고, 9월 1일부터 $3/$15로 오를 예정이었어요. 앤트로픽은 이 인상을 취소하고 $2/$10을 정식 가격으로 바꿨습니다. Sonnet 5.5도 같은 값이에요
- 일괄 처리 — 급하지 않은 요청을 모아 보내는 배치 API는 절반 값(입력 $1, 출력 $5)입니다
- 생각 강도 기본값 — Claude 앱과 Claude Code에서는 Medium, API(Claude Platform)에서는 High가 기본이에요
- 속도와 일당 비용 — “Sonnet 5보다 30% 이상 빠르게 답을 내는, 지금까지 가장 빠른 Sonnet”이고, 회사 측정으로는 같은 일을 맡겼을 때 비용이 최대 30% 적게 들었다고 합니다. 토큰 단가는 그대로이니, 같은 일을 더 적은 토큰으로 끝낸다는 뜻이에요
📊 3. 성능 지표 — 공식 표 그대로
앤트로픽 발표문에 실린 표입니다. 퍼센트로 된 6개 지표를 먼저 그림으로 보면 이렇습니다.
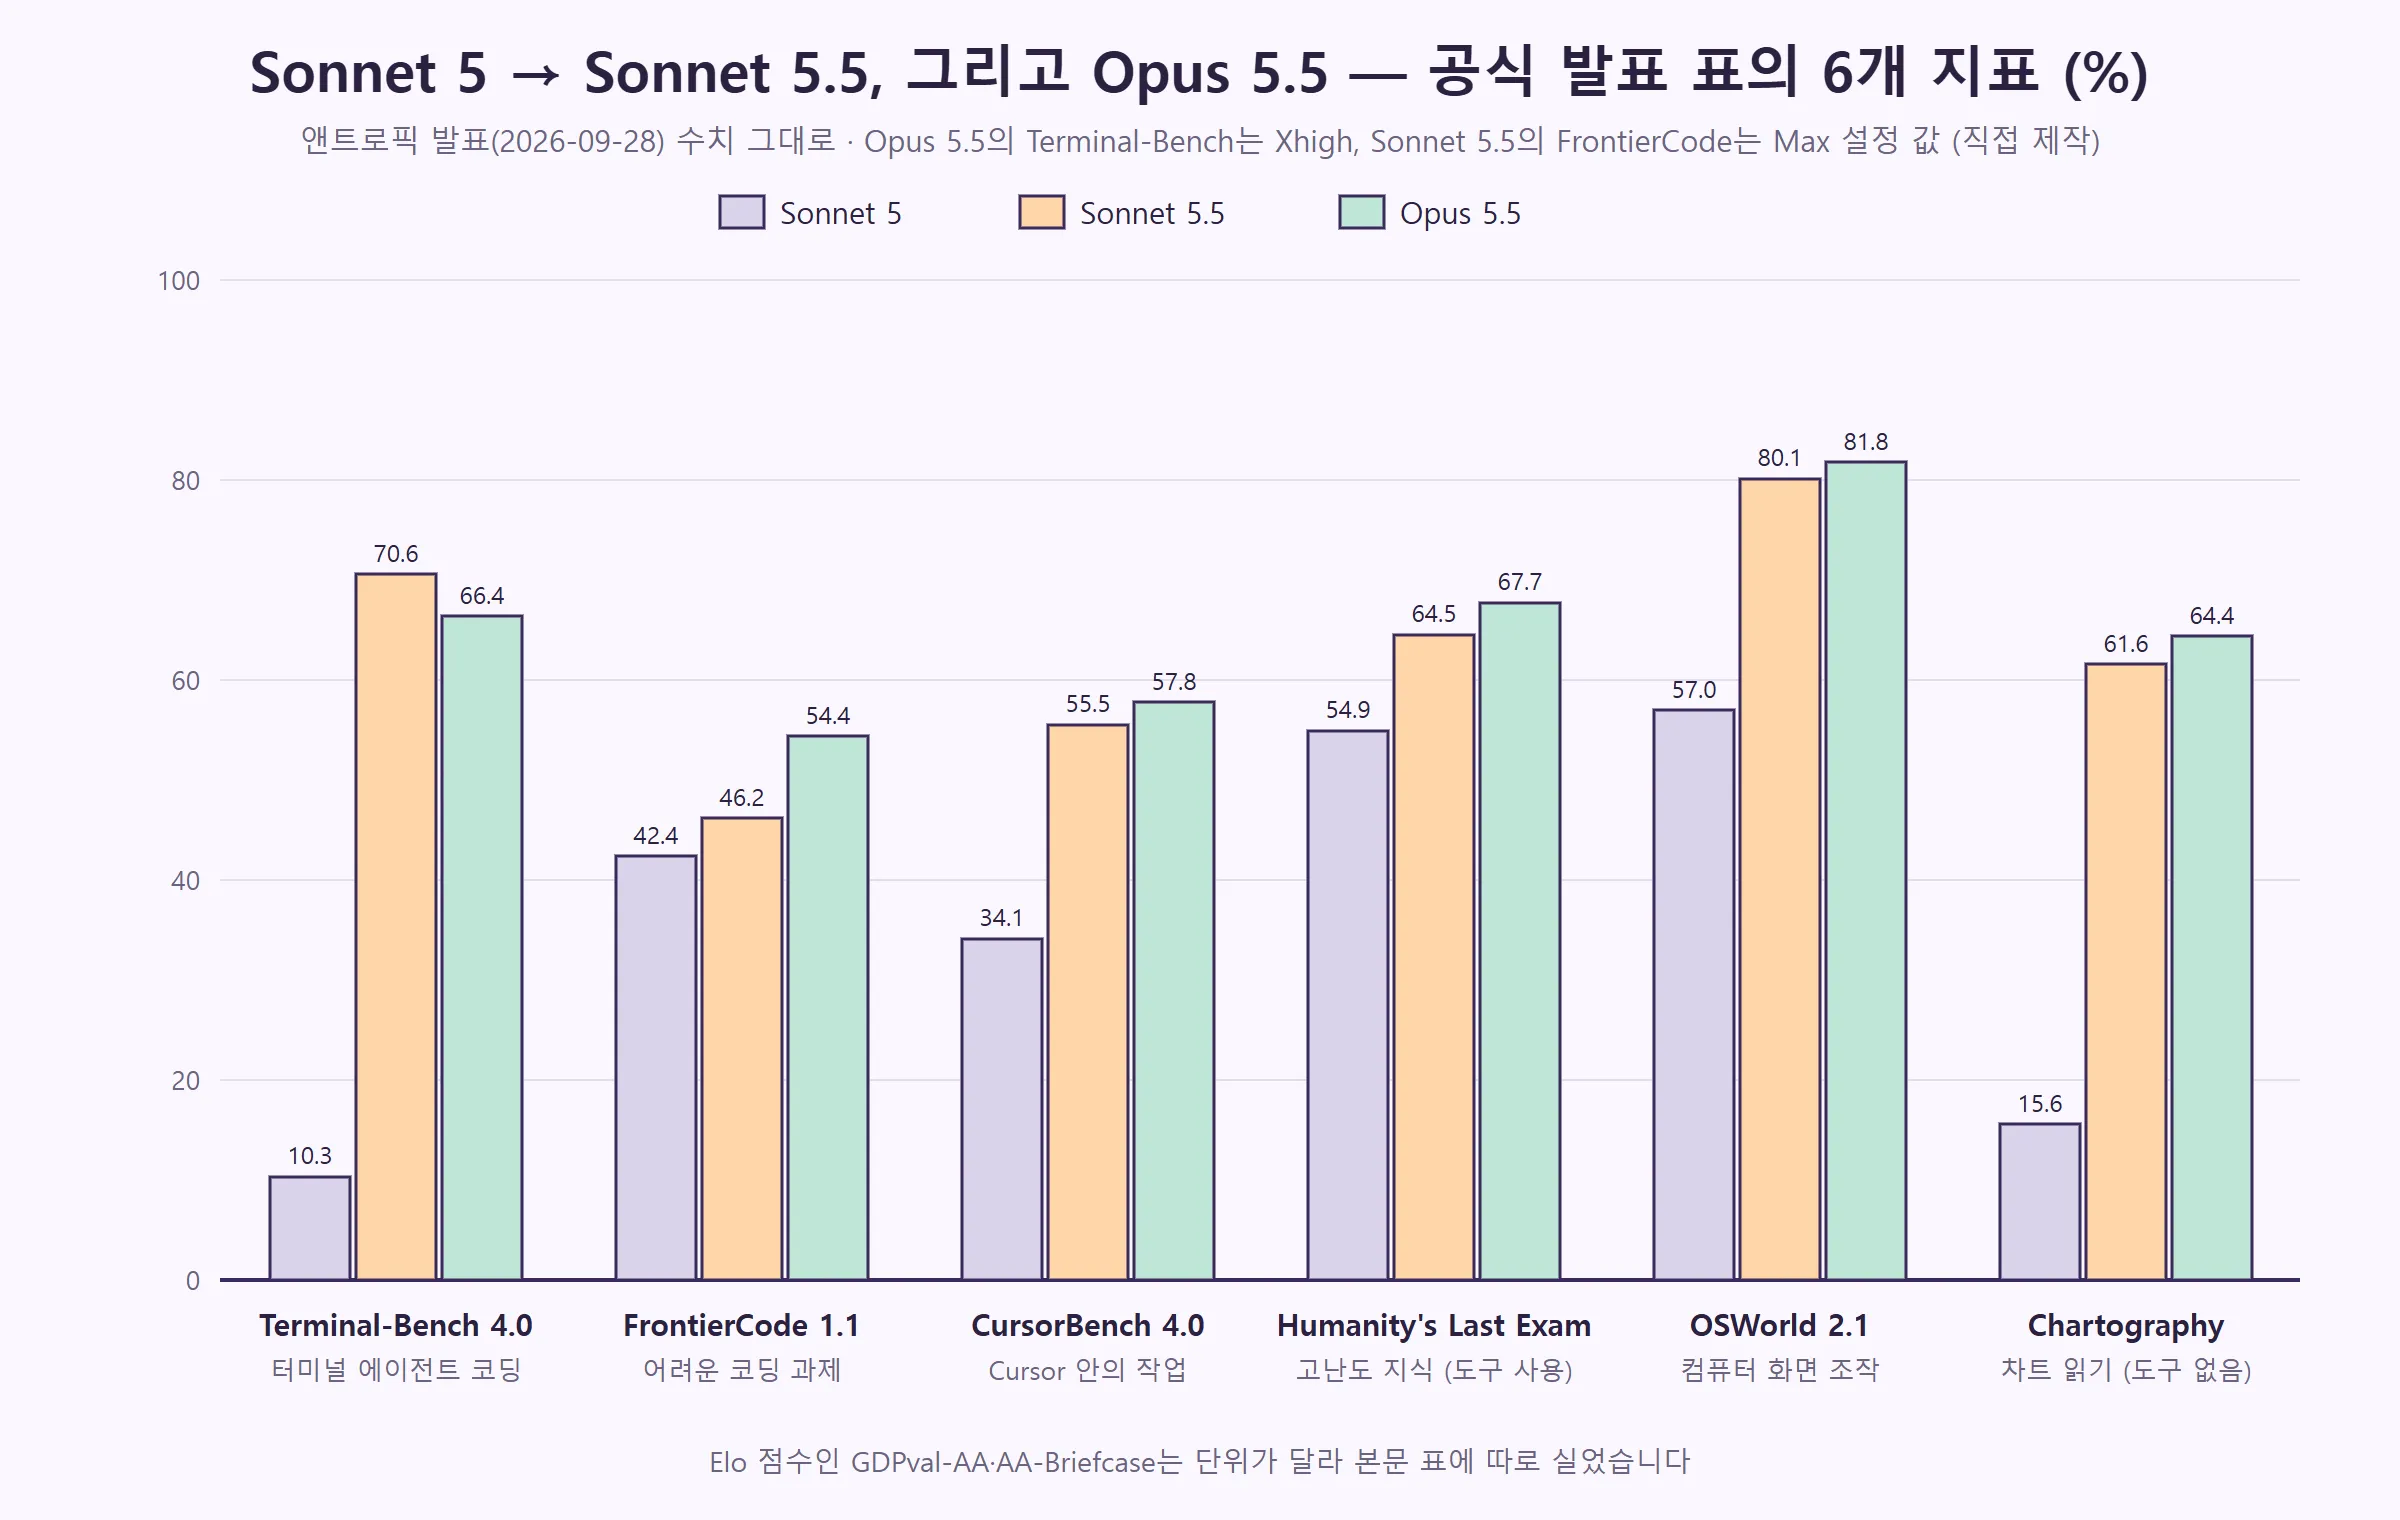
전체 표예요. 칸이 비어 있는 곳은 발표문에도 값이 없는 곳입니다.
| 벤치마크 | 무엇을 재나 | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | 터미널에서 일하는 에이전트 코딩 | 70.6% | 10.3% | 66.4% ¹ | — |
| FrontierCode 1.1 (Main) | 사람이 손대지 않고 합칠 수 있는 코드 수정 | 46.2% ² | 42.4% | 54.4% | 49.3% |
| CursorBench 4.0 | 코딩 도구 Cursor 안의 작업 | 55.5% | 34.1% | 57.8% | — |
| GDPval-AA v2.1 ³ | 여러 직업의 실무 (Elo 점수) | 1844 | 1449 | 1846 | 1487 ⁴ |
| AA-Briefcase v1.1 ³ | 실무 과제 (Elo 점수, Artificial Analysis 측정) | 1811 | 1359 | 1822 | 1483 ⁴ |
| Humanity’s Last Exam | 고난도 지식 문제 (도구 사용) | 64.5% | 54.9% | 67.7% | — |
| OSWorld 2.1 (partial) | 컴퓨터 화면 조작 | 80.1% | 57.0% | 81.8% | — |
| Chartography | 차트 읽기 (도구 없음) | 61.6% | 15.6% | 64.4% | 53.6% ⁴ |
표 아래 각주가 중요해서 옮겨 둡니다.
- ¹ Opus 5.5의 Terminal-Bench 값은 생각 강도를 Xhigh로 올렸을 때의 최고점이에요
- ² Sonnet 5.5는 FrontierCode에서 Max 설정이 Xhigh보다 오히려 점수가 낮았대요. Max에서는 여러 하위 에이전트로 코드 검토를 쪼개 돌리는 일이 잦았고, 그 바람에 시간 초과가 나거나 과제 범위 밖까지 고친 경우가 있었다고 합니다. 이 지표는 범위 밖 수정을 감점하거든요
- ³ 두 실무 지표는 출시 전 버전으로 잰 값인데, 그 버전에 정해진 형식으로 답하는 기능을 약하게 만드는 버그가 있었고 지금은 고쳤다고 해요. 회사는 “영향이 있더라도 작고, 실제보다 낮게 나왔을 것”이라고 봅니다
- ⁴ GPT-6 Sol의 일부 점수는 OpenAI가 최근 고친 이미지 이해 버그가 반영되기 전 값일 수 있대요
🔁 4. 이전 버전 Sonnet 5와 무엇이 달라졌나
8개 지표가 모두 올랐는데, 오른 폭이 고르지 않아요.
| 지표 | Sonnet 5 → Sonnet 5.5 | 차이 |
|---|---|---|
| Terminal-Bench 4.0 | 10.3% → 70.6% | +60.3 |
| Chartography | 15.6% → 61.6% | +46.0 |
| OSWorld 2.1 | 57.0% → 80.1% | +23.1 |
| CursorBench 4.0 | 34.1% → 55.5% | +21.4 |
| Humanity’s Last Exam | 54.9% → 64.5% | +9.6 |
| FrontierCode 1.1 | 42.4% → 46.2% | +3.8 |
| GDPval-AA v2.1 (Elo) | 1449 → 1844 | +395 |
| AA-Briefcase v1.1 (Elo) | 1359 → 1811 | +452 |
터미널에서 스스로 일하는 코딩과 차트 읽기가 크게 뛰었고, 컴퓨터 화면 조작과 두 실무 지표도 많이 올랐어요. 발표문에는 이런 문장도 있습니다. Sonnet 가운데 처음으로 화면만 보고 포켓몬 레드를 깼고, 글을 더 분명하게 쓰고, 도구를 쓸 때 거치는 단계와 토큰이 줄었다고요.
⚖️ 5. Opus 5.5와 비교 — 반값 모델은 어디까지 왔나
| Opus 5.5 | Sonnet 5.5 | ||
|---|---|---|---|
| 입력 / 출력 (100만 토큰당) | $4 / $20 | $2 / $10 | Sonnet 5.5가 절반 |
| Terminal-Bench 4.0 | 66.4% (Xhigh) | 70.6% | Sonnet 5.5 +4.2 |
| GDPval-AA v2.1 (Elo) | 1846 | 1844 | 2점 차 |
| AA-Briefcase v1.1 (Elo) | 1822 | 1811 | Opus 5.5 +11 |
| OSWorld 2.1 | 81.8% | 80.1% | Opus 5.5 +1.7 |
| CursorBench 4.0 | 57.8% | 55.5% | Opus 5.5 +2.3 |
| Chartography | 64.4% | 61.6% | Opus 5.5 +2.8 |
| Humanity’s Last Exam | 67.7% | 64.5% | Opus 5.5 +3.2 |
| FrontierCode 1.1 | 54.4% | 46.2% (Max) | Opus 5.5 +8.2 |
같은 일을 시켰을 때의 비용을 단순하게 계산해 보면, 입력 100만 토큰과 출력 20만 토큰짜리 일이 Opus 5.5는 $8($4 + 0.2 × $20), Sonnet 5.5는 $4($2 + 0.2 × $10)예요. 실제로는 모델마다 같은 일에 쓰는 토큰 수가 달라서 이 계산은 단가 비교일 뿐입니다.
숫자만 보면 “이제 Opus 5.5는 필요 없나?” 싶지만, 앤트로픽은 발표문에 이렇게 선을 그었어요.
“벤치마크 점수는 모델 능력의 한 면만 보여 줍니다. 우리 자체 시험과 외부 시험 모두에서, 오래 판단을 이어 가야 하는 복잡하고 열린 일에서는 Opus 5.5가 여전히 확실히 더 강합니다.”
FrontierCode처럼 범위를 지키며 정확히 고치는 일에서 차이가 가장 큰 것도 같은 이야기로 읽혀요.
🛡️ 6. 안전 조치 — 처음으로 윗급 수준을 단 Sonnet
성능이 오르면서 안전 조치도 한 단계 올렸습니다.
- 사이버보안 — 해킹 쪽 능력이 Opus 5와 비슷한 수준이라, 이전에는 최상위 모델에만 붙이던 제한을 달고 나왔어요. 평소처럼 내 코드의 버그를 찾고 고치는 건 되지만, 위험도가 높은 사이버보안 작업은 눈에 보이게 Sonnet 5로 넘어가서 처리됩니다
- 생각 빼내기 방지 — 모델의 생각 과정을 빼내 다른 모델 학습에 쓰는 시도를 막는 분류기를 단 첫 Sonnet이에요
- 생각 기록의 주인 — ‘보존된 생각’ 기능을 넓혀서, Claude의 생각 기록을 그 기록을 만든 계정에서 떼어 쓸 수 없게 했대요
- 생명과학 쪽 안전 조치는 Sonnet 5와 같은 수준이라고 밝혔어요
🎯 7. 그래서 누구에게 무슨 뜻인가
- Claude 앱을 쓰는 사람 — 앱에서는 생각 강도 Medium이 기본이에요. 문서 정리, 슬라이드·표 만들기, 일상 질문은 Sonnet 5.5로 충분히 빠르고, 오래 고민해야 하는 기획·분석은 Opus 5.5를 고르는 식으로 나눠 쓰면 됩니다
- Claude Code로 코딩하는 사람 — Claude Code도 기본은 Medium이에요. 버그 고치기처럼 범위가 분명한 일은 Sonnet 5.5, 여러 파일을 오래 손보는 큰 작업은 Opus 5.5가 회사 설명과 맞는 선택입니다
- API로 서비스를 만드는 사람 — 모델 이름만
claude-sonnet-5-5로 바꾸면 되고, 단가가 Sonnet 5와 같아서 비용 계산을 다시 할 필요가 없어요. 100만 토큰 컨텍스트도 추가 요금 없이 같은 단가입니다
한 줄 정리
Sonnet 5.5는 같은 값에 30% 빨라진 Sonnet이고, 코딩·화면 조작·실무 지표에서 Opus 5.5 바로 아래까지 올라왔어요. 다만 길게 판단해야 하는 일은 회사 스스로 Opus 5.5를 권합니다.
윗급 모델 이야기는 Opus 5.5 출시 글에, Opus 5.5에 실제로 일을 맡겨 본 기록은 실사용 후기에 있어요.
2026년 10월 1일 기준입니다. 성능·가격은 앤트로픽 공식 발표(2026-09-28)와 공식 문서(모델 비교표·가격표)에서 옮겼고, 독립 검증 전 수치입니다. 가격은 바뀔 수 있으니 쓰기 전에 공식 가격표를 확인하세요.