이 글에는 제휴 링크가 없고 OpenAI·앤트로픽·NVIDIA·LM Studio와 아무 관계가 없습니다. 제가 직접 만든 중계기의 개발 기록을 바탕으로 썼습니다. 삽화는 GPT 이미지 생성, 도식은 직접 제작했습니다.
중계기에 톨게이트가 필요한 이유 — 차선 수가 다른 고속도로 요금소 (LLM 중계기 개발기)
명절 귀성길의 고속도로 요금소를 떠올려 볼게요. 이 요금소를 지나면 길이 여러 갈래로 나뉜다고 해 봅시다. 어떤 길은 4차선, 어떤 길은 3차선, 어떤 길은 1차선뿐이에요.
요금소가 차를 오는 대로 다 들여보내면 어떻게 될까요? 넓은 길은 버텨도 1차선 길 입구는 금세 꽉 막히고, 그 뒤로 늘어선 차들은 언제 움직일지 모른 채 서 있게 됩니다.
그래서 이런 요금소에는 안내원이 필요해요. 길마다 지금 몇 대가 달리는지 보고, 자리가 난 길로만 차를 들여보내고, 나머지는 대기 차로에 줄을 세워요. 대기 차로마저 꽉 차면 “지금은 들어가기 어렵다”고 바로 알려 줘서, 운전자가 기다릴지 다른 길로 갈지 정할 수 있게 하죠.
제가 만든 LLM 중계기 한가운데에도 이런 요금소가 있어요. 2편에서 ‘교통정리’라고 짧게 소개한 칸이에요.
이 글은 LLM 중계기 개발기의 10편이자, 3부 ‘교통정리 — 중앙 조율’의 첫 편입니다. 지난 9편 「모델마다 다른 스펙을 카드로」에서는 모델마다 다른 스펙을 프로그램이 읽을 수 있게 정리한 이야기를 했어요. 3부에서는 여러 프로그램의 질문이 한꺼번에 몰릴 때 중계기가 차례를 어떻게 정하는지를 다룹니다.
결론 요약
- 그냥 통과시키면 막힌다 — AI마다 한꺼번에 받을 수 있는 질문 수가 정해져 있어서, 들어오는 대로 다 넘기면 AI 쪽이 “너무 많다(429)“며 거절하거나 모두 함께 느려집니다
- 그래서 차선과 줄 — 중계기의 교통정리 칸이 AI별·모델별 차선(Codex 3, Claude 3, NVIDIA 4, LM Studio 1)과 길이·시간 제한이 있는 대기 줄을 관리하고, 전체로도 동시에 10건, 줄 선 것까지 16건까지만 받아요
- 매달아 두지 않고, 사람 먼저 — 줄이 꽉 차거나 너무 오래 기다리면 이유와 다시 올 시간을 담아 “지금 붐빈다”고 바로 돌려보내고, 자리가 나면 사람이 기다리는 요청부터 들여보냅니다
🚗 1. 그냥 통과시키면 왜 막힐까
가장 단순한 중계기는 받은 질문을 그대로 AI에 넘기기만 하는 거예요. 그런데 AI 앞에서는 이 방식이 금방 막힙니다. 이유는 두 가지예요.
첫째, AI마다 한꺼번에 받을 수 있는 수가 정해져 있어요.
- 인터넷 너머의 AI 서비스는 흔히 열쇠(API 키)마다 ‘1분에 몇 번’, ‘동시에 몇 건’ 같은 한도를 둬요. 한도를 넘으면 429라는 번호와 함께 거절합니다. HTTP 429는 ‘요청이 너무 많다’는 뜻의 번호예요
- 내 컴퓨터에서 돌리는 AI도 비슷해요. 그래픽카드 하나로 LM Studio를 돌리는 컴퓨터에서 질문 4개를 동시에 보내 보니, 한 건 한 건이 약 2.8배 느려지고 전체 처리량은 약 1.4배 느는 데 그쳤어요. 같은 그래픽카드를 나눠 쓰니 동시에 보내도 사실상 한 줄로 처리되는 셈이에요
- Codex와 Claude는 6편에서 본 것처럼 내 컴퓨터에 켜 두고 쓰는 프로그램이에요. Claude는 켜 둔 세션 하나에서 대화가 하나씩만 이어지고요. 중계기는 이 둘에게 같은 모델로는 한 번에 한 차례씩만 대화를 보내도록 해 두었어요
둘째, AI의 답은 오래 걸려요. 짧으면 몇 초, 길면 몇 분이에요. 큰 코드 검토를 맡기면 5분으로도 빠듯해서 NVIDIA의 시간 상한을 10분으로 늘린 적도 있어요. 차 한 대가 요금소를 지나 한참 달려야 길을 비워 주는 셈이라, 오는 대로 들여보내면 길이 금세 가득 찹니다.
그러니 중계기가 할 일은 ‘전달’에서 끝나지 않아요. 지금 보낼지, 줄을 세울지, 돌려보낼지까지 정해야 하죠. 개발자들은 이런 일을 흔히 입장 제어(admission control)라고 불러요.
📢 2. 숫자를 알려 주기만 하던 이틀
처음부터 요금소가 있었던 건 아니에요. 첫날의 중계기는 질문을 받는 대로 AI에 넘겼어요. Codex와 Claude 어댑터가 자기 세션 앞에서 한 번에 하나씩 차례를 지켰을 뿐, 중계기 전체를 내려다보며 차례를 정하는 칸은 없었습니다.
둘째 날 아침(7월 14일, v0.1.22), 중계기는 AI마다 “동시에 몇 건까지 받을 수 있는지”를 숫자로 알려 주기 시작했어요. 중계기를 쓰던 도구가 이 숫자를 읽고, 한 AI에 질문을 몇 개씩 동시에 보낼지 정하게 하려는 거였죠. LM Studio는 위의 측정 결과대로 1, Codex와 Claude는 1이었어요.
그런데 그날 오후에 고친 기록이 하나 있어요. 한 AI 서버에 대해 알려 준 숫자가, 그 서버가 실제로 받아 주는 수보다 컸던 거예요. 중계기를 쓰던 도구는 알려 준 숫자만큼 질문을 한꺼번에 던졌고, 서버는 넘친 질문을 429로 거절했어요. 중계기의 숫자를 믿은 탓에 도구가 스스로 거절을 부른 셈이에요.
다행히 그 서버는 거절하면서 ‘받을 수 있는 수 중에 지금 몇 건이 차 있는지’를 적어 보내고 있었어요. 그 값을 실제 한도로 삼아 숫자를 낮췄습니다(v0.1.25).
여기서 알 수 있는 게 두 가지예요.
- 숫자는 짐작이 아니라 잰 값이어야 한다 — 상대가 거절하면서 직접 알려 주는 한도가 가장 정확한 측정값이었어요
- 알려 주기만 해서는 지켜지지 않는다 — 쓰는 쪽이 숫자를 잘못 읽거나, 숫자 자체가 틀리면 막을 방법이 없어요
다음 날 아침(7월 15일) 나온 v0.1.31부터는 중계기 한가운데에 교통정리 칸(코디네이터)이 들어왔어요. 이제 중계기는 숫자를 알려 주기만 하지 않고 직접 지켜요. 어느 프로그램이 몇 건을 보내든, 차선에 들어가는 수는 중계기가 정합니다. 이 칸 하나에 프로그램 약 950줄과, 그 동작을 확인하는 검사 약 620줄이 함께 들어왔어요.
🛣️ 3. 차선 — AI마다, 모델마다 다르게
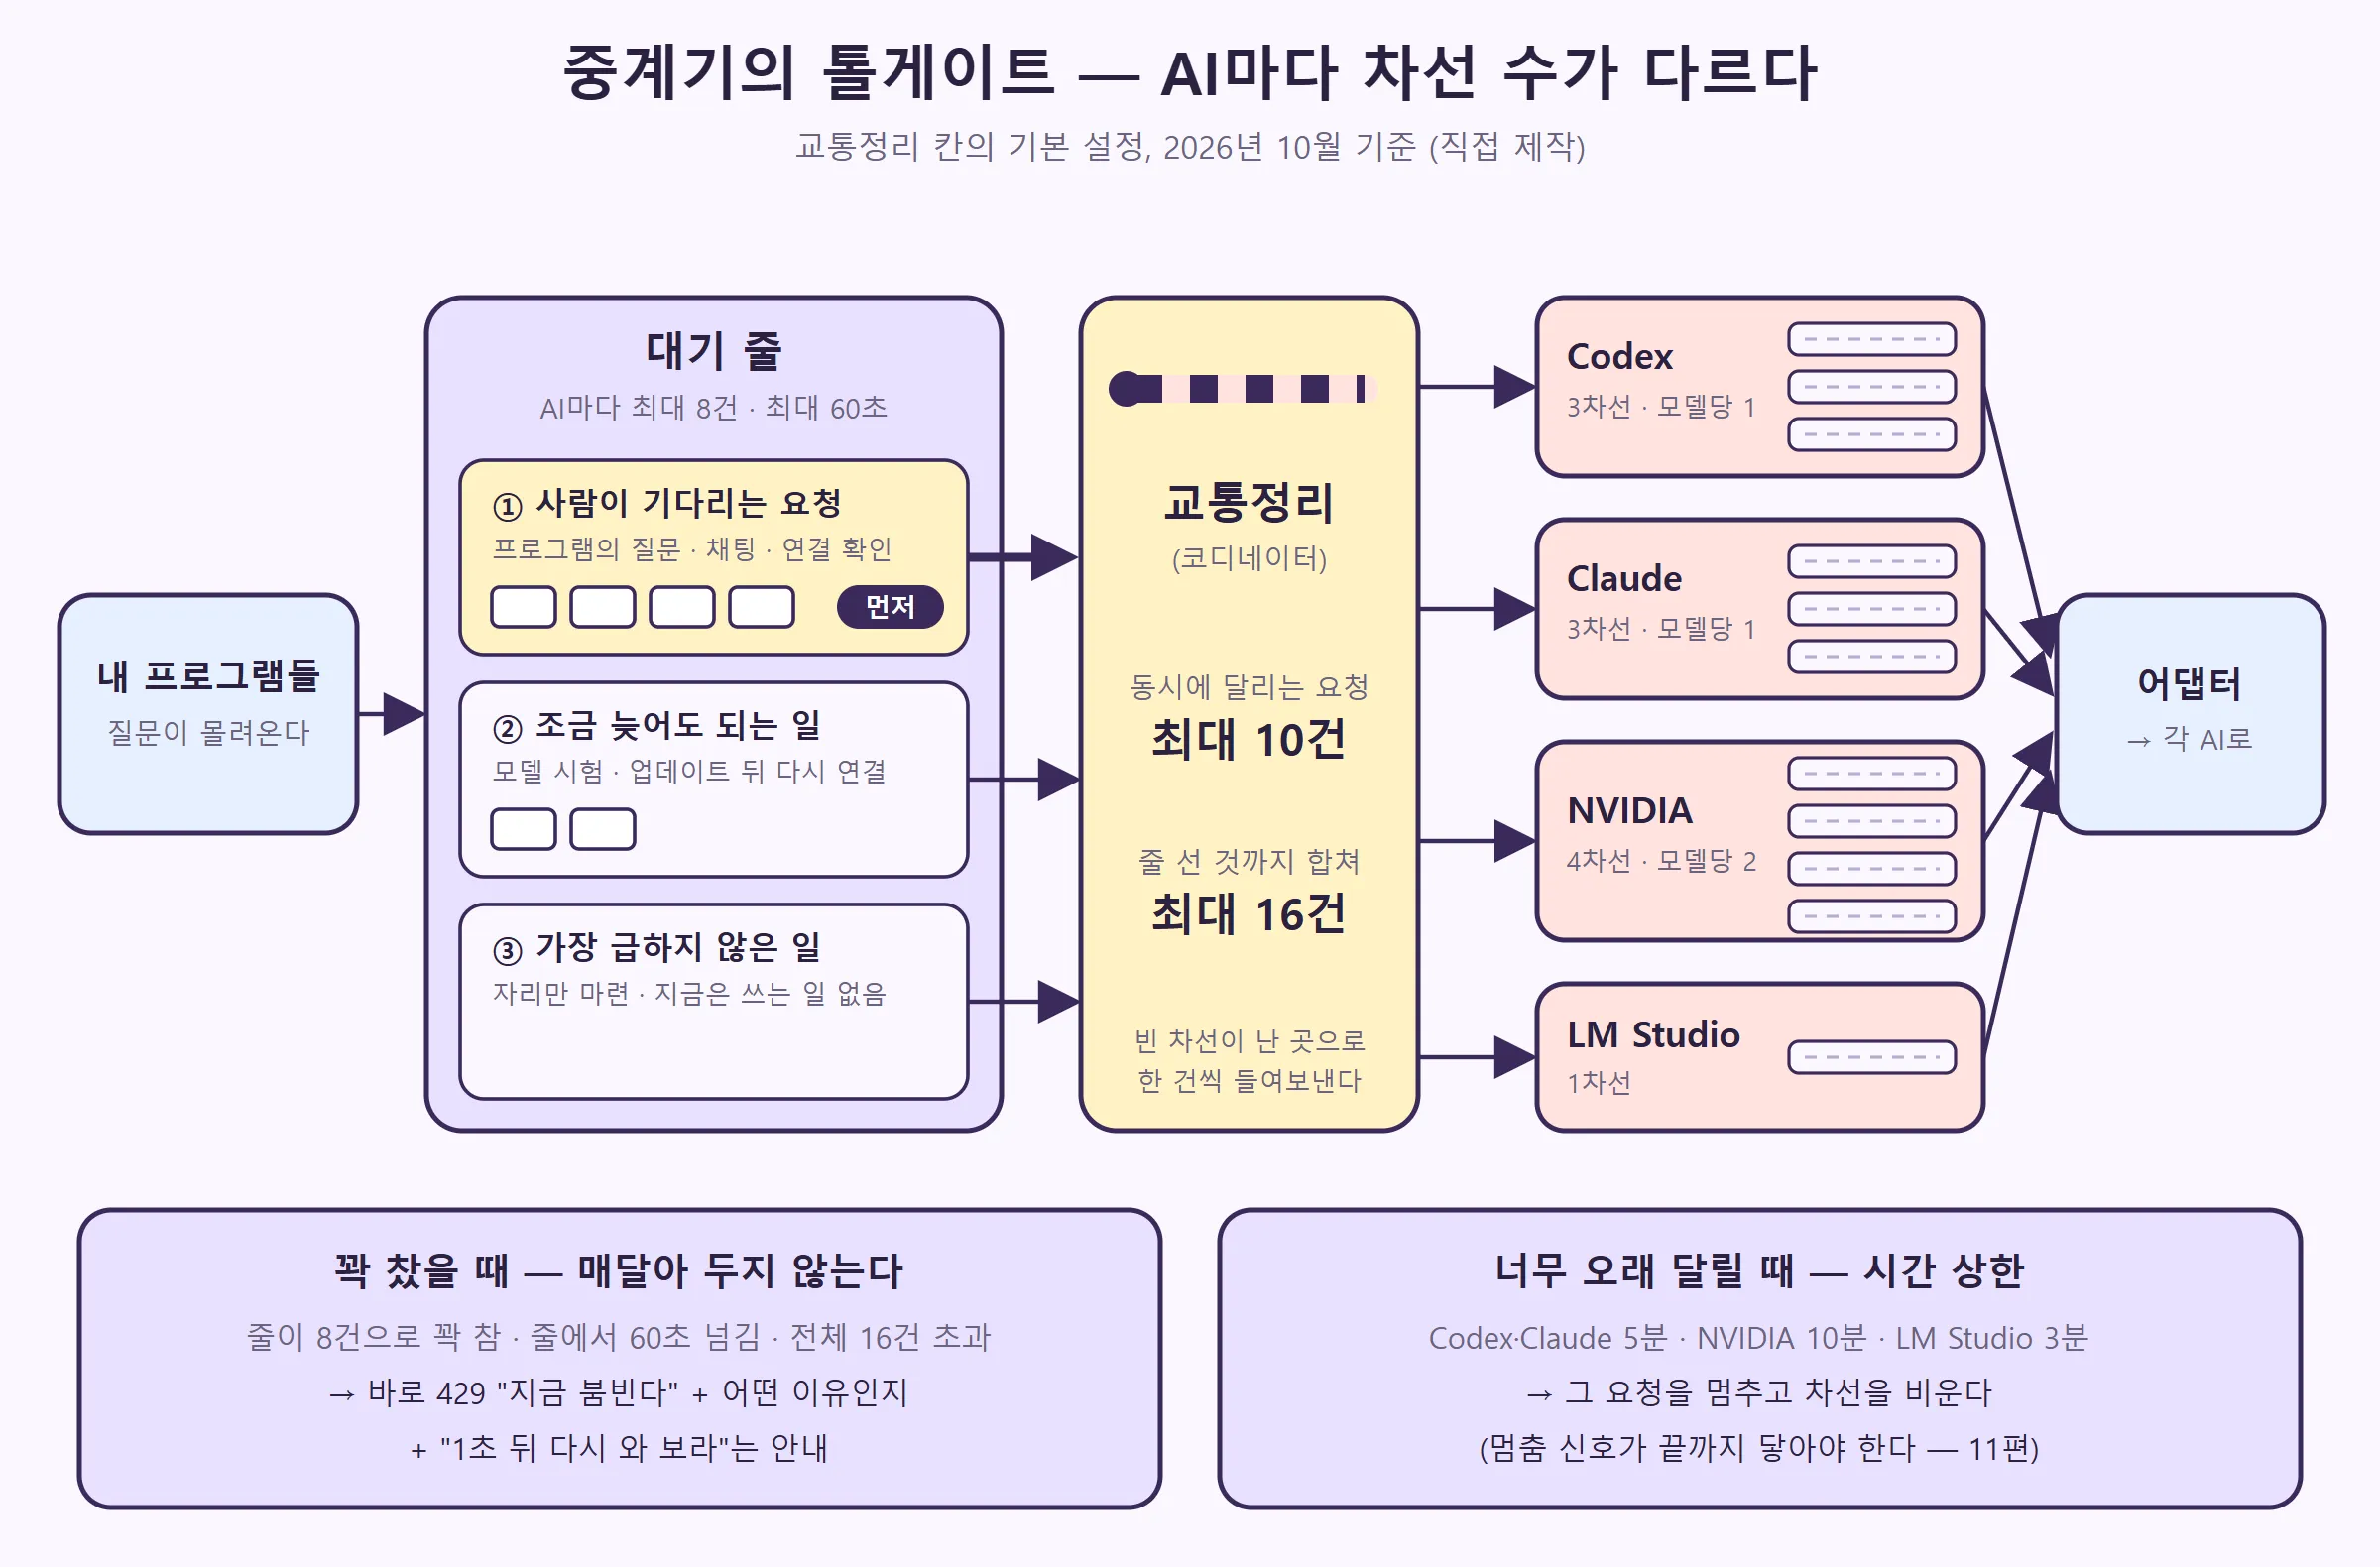
교통정리 칸은 AI마다 차선 수를 따로 정해 둬요. 지금 기본 설정은 이래요.
| AI | 전체 차선 | 같은 모델에는 | 정한 이유 |
|---|---|---|---|
| Codex | 3 | 1 | 같은 모델은 한 차례씩, 다른 모델끼리는 동시에 |
| Claude | 3 | 1 | Codex와 같음 |
| NVIDIA | 4 | 2 | 모델마다 열쇠를 따로 넣을 수 있고, 한도도 열쇠마다 따로라서 모델별로 나눔 |
| LM Studio | 1 | — | 그래픽카드 하나를 나눠 써서, 동시에 보내도 얻는 게 적음 |
표에서 중요한 칸은 ‘같은 모델에는’이에요. Codex 차선이 3개라는 건 ‘서로 다른 모델 세 개가 동시에 달릴 수 있다’는 뜻이에요. 같은 모델로 질문 두 개가 오면 하나는 달리고 하나는 줄을 서요. AI라는 큰 도로 안에 모델별 작은 차선이 또 있는 셈이죠.
차선 수는 쓰면서 고쳐 가요. NVIDIA는 처음 붙인 날(7월 18일) 모델 구분 없이 동시 2건이었는데, 이틀 뒤 4건, 모델당 2건으로 늘렸어요. 큰 요청을 적게 보내는 쓰임이라, ‘1분에 몇 번’이라는 횟수 한도보다 동시에 달릴 차선 수가 먼저 막혔거든요. 앞에서 말한 시간 상한을 10분으로 늘린 것도 이때예요.
차선과 별개로 요금소 전체의 상한도 있어요.
- 동시에 달리는 요청: 최대 10건
- 달리는 요청과 줄 선 요청을 합쳐서: 최대 16건
위 표의 네 AI만 더해도 차선이 11개라 10을 넘죠. 여러 AI가 한꺼번에 바쁠 때를 위한 마지막 울타리가 전체 상한이에요.
새 AI를 붙이면서 이 차선 설정 한 줄을 빠뜨리면 어떻게 될까요? 그 사고는 13편에서 이야기할게요.
🎫 4. 줄에도 길이와 시간 제한이 있다
빈 차선이 없으면 질문은 줄을 서요. 다만 이 줄은 끝없이 길어지지 않아요.
- 줄 길이 — AI마다 기본 8건까지
- 줄 선 시간 — 기본 60초까지
- 달리는 시간 — 차선에 들어간 뒤에도 상한이 있어요. 기본 설정에서 Codex·Claude는 5분, NVIDIA는 10분, LM Studio는 3분이에요. 넘기면 중계기가 그 요청을 멈추고 차선을 비워요
2편에서 본 기록 한 줄의 ‘줄 선 시간’이 바로 이 줄에서 기다린 시간이에요.
꽉 차면 매달아 두지 않는다
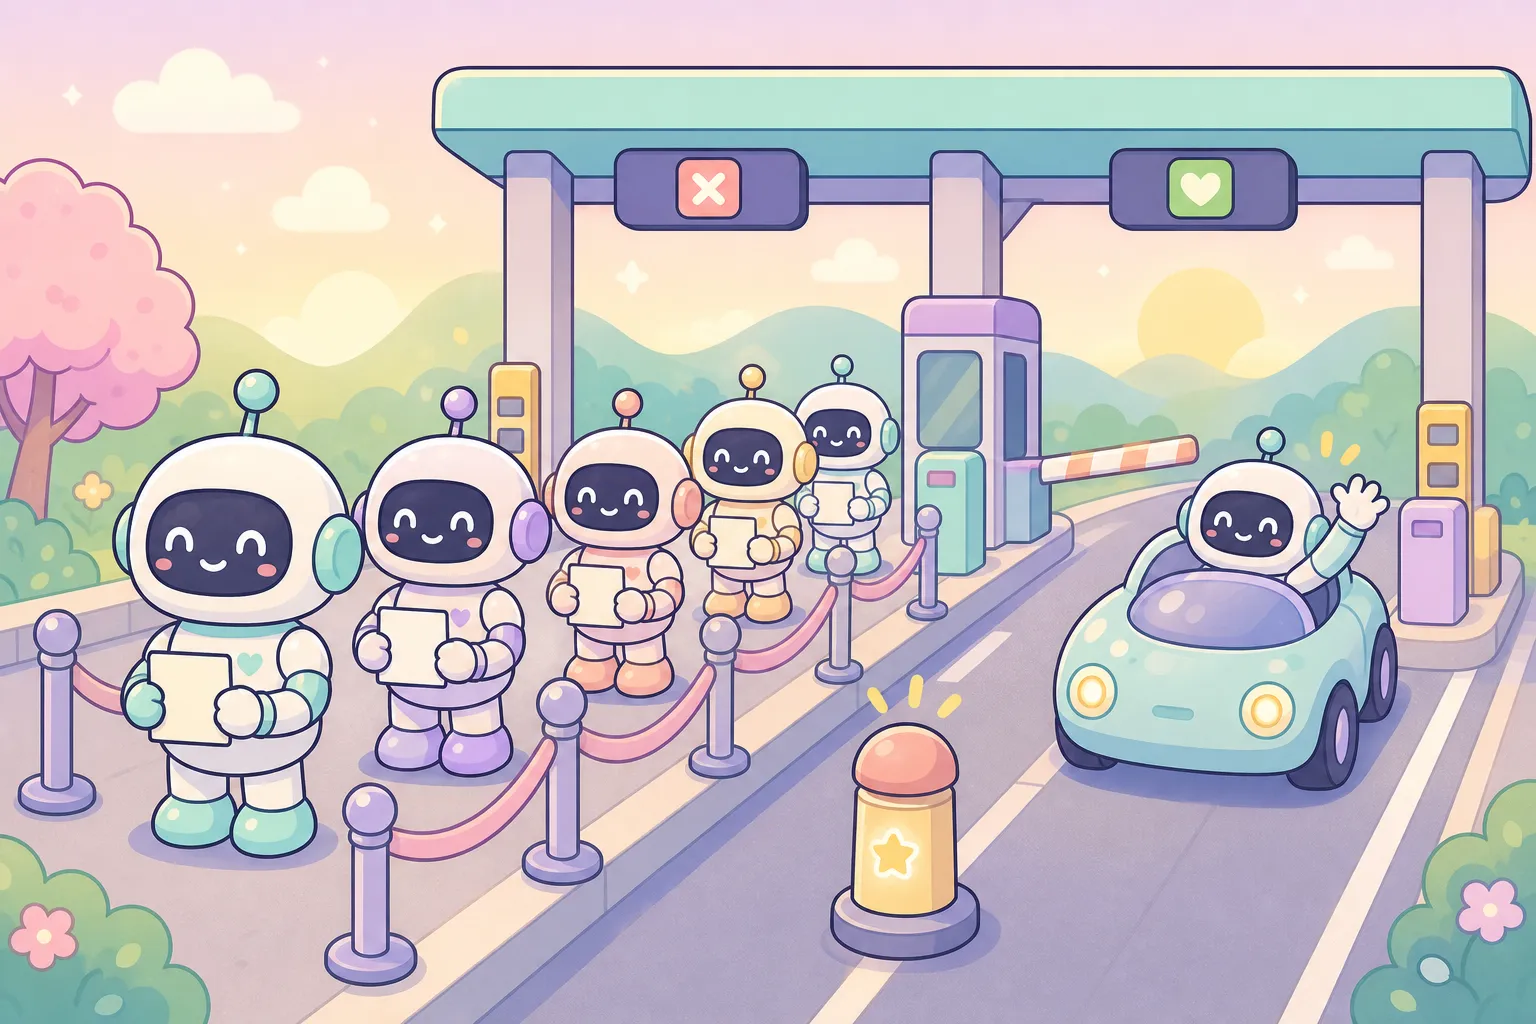
줄이 꽉 찼거나, 줄에서 60초를 넘겼거나, 요금소 안이 16건으로 가득 차면, 중계기는 질문을 붙잡고 있지 않고 바로 돌려보내요. 돌려보내는 답에는 세 가지가 담겨요.
| 담기는 것 | 내용 |
|---|---|
| 번호 | 429 — “지금은 너무 많다” |
| 이유 이름 | 그 AI의 줄이 꽉 참(provider_queue_full), 줄에서 기다리다 시간 초과(provider_queue_timeout), 중계기 전체가 꽉 참(gateway_overloaded) 중 하나 |
| 다시 올 시간 | “이만큼 기다렸다가 다시 와 보라”는 안내. 기본은 1초 |
왜 기다리게 두지 않고 돌려보낼까요? 대답 없이 매달려 있는 요청이 가장 곤란하기 때문이에요. 쓰는 쪽 프로그램은 그게 곧 올 답인지, 영영 안 올 답인지 알 수 없어요. 분명하게 “붐빈다”는 답을 받으면 잠깐 기다렸다 다시 보낼지, 다른 AI로 돌릴지 바로 정할 수 있죠.
교통정리 칸이 들어온 날 함께 만든 부하 시험도 이 원칙을 확인해요. 가짜 AI를 붙여 놓고 질문 20건, 50건을 한꺼번에 쏟아부었을 때 결과는 ‘답’ 아니면 ‘분명한 429’ 둘 중 하나여야 하고, 다 끝난 뒤에는 요금소 안이 텅 비어 있어야 통과예요.
그런데 질문을 보낸 쪽이 답을 기다리다 먼저 연결을 끊으면 어떻게 될까요? ‘멈추라’는 신호가 AI 쪽까지 제대로 닿지 않으면 그 요청은 차선에 계속 서 있고, 차선 하나가 통째로 막혀요. 11편에서 다룹니다.
🚑 5. 자리가 나면 누구부터 — 사람이 기다리는 요청 먼저
줄에도 순서가 있어요. 교통정리 칸은 요청을 세 등급으로 나눠요.
- ① 먼저 — 사람이 화면 앞에서 답을 기다리는 요청이에요. 프로그램이 API로 보낸 질문, 관리 화면의 채팅, AI 연결 확인이 여기 들어가요
- ② 보통 — 관리 화면의 모델 시험 호출, 업데이트 뒤 다시 연결하기처럼 조금 늦어도 되는 일이에요
- ③ 나중 — 가장 급하지 않은 일을 위한 자리예요. 지금 기본 설정에서 이 등급을 쓰는 일은 없어요
자리가 하나 나면 교통정리 칸은 ① 줄부터 봐요. 손님을 태운 차가 점검 차량보다 먼저 지나가는 셈이에요.
같은 등급끼리는 공평하게 돌아가요.
- AI끼리는 한 곳씩 번갈아 들여보내요
- 같은 AI 안에서는 지금 덜 붐비는 모델의 차선부터 채워요. 한 모델 앞에 긴 줄이 생겨도 다른 모델이 계속 뒤로 밀리지 않게요
- 같은 모델의 줄 안에서는 먼저 온 순서를 지켜요
정리
① AI마다 한꺼번에 받을 수 있는 수가 정해져 있어서, 들어오는 대로 넘기기만 하는 중계기는 금방 막히거나 거절당해요 ② 그래서 중계기의 교통정리 칸이 AI별·모델별 차선, 길이와 시간이 정해진 줄, 전체 상한(동시 10건·줄 포함 16건)을 지켜요 ③ 꽉 차면 매달아 두지 않고 이유와 다시 올 시간을 담아 돌려보내고, 자리가 나면 사람이 기다리는 요청부터 들여보내요 — 다음 편은 “전화를 끊었는데 상담원은 계속 대기 중”입니다
중계기 안의 칸 구성은 2편에 있어요.
2026년 10월 1일 기준입니다. 제가 만든 중계기의 개발 기록을 바탕으로 썼고, 특정 기업·서비스의 공식 입장이 아닙니다. 차선 수와 시간 같은 숫자는 기본 설정값이라 이후 버전에서 바뀔 수 있어요.