이 글에는 제휴 링크가 없고 글에 나오는 AI 서비스들(OpenAI·앤트로픽·구글·NVIDIA)과 아무 관계가 없습니다. 제가 직접 만든 중계기의 개발 기록을 바탕으로 썼습니다. 삽화는 GPT 이미지 생성, 도식은 직접 제작했습니다.
모델마다 다른 스펙을 카드로 — 가전제품 에너지 라벨처럼 고르기 (LLM 중계기 개발기)
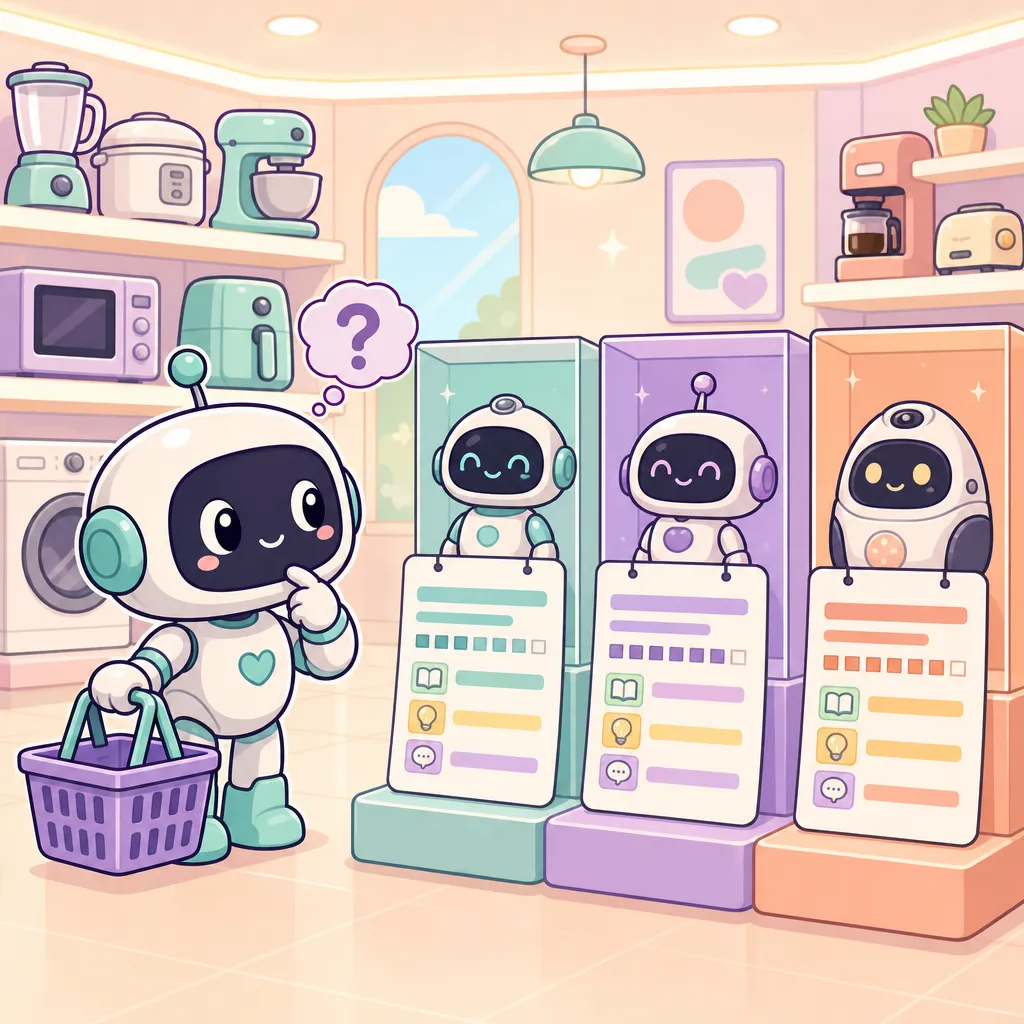
가전 매장에서 냉장고를 고른다고 해 볼게요. 겉모습은 다 비슷한 하얀 상자라 눈으로는 차이를 알기 어렵습니다. 그래서 옆면에 붙은 라벨을 봐요. 용량, 효율 등급, 한 달 전기 사용량 같은 숫자가 정해진 자리에 정해진 모양으로 적혀 있으니, 세 대를 나란히 세워 두고 줄마다 비교하면 금방 고를 수 있습니다.
라벨이 없다면 어떨까요? 점원에게 하나하나 물어야 하고, 물어볼 사람이 없으면 제일 무난한 것을 고르게 되겠죠. 우리 집 부엌에 들어갈지 확신이 없으니까요.
이 글은 LLM 중계기 개발기의 9편입니다. 지난 편에서는 로그인을 해 뒀는데도 어딘가 남아 있던 옛 열쇠가 먼저 쓰여 문이 막힌 이야기를 했어요. 이번 편으로 2부 ‘여러 AI를 한 줄로’를 마무리합니다.
결론 요약
- 문제 — 중계기 메뉴판에는 모델 이름만 있었어요. 쓰는 쪽 프로그램은 모델마다 한 번에 얼마나 읽는지, ‘끝났다’는 표시를 믿어도 되는지, 생각하느라 답 분량을 얼마나 쓰는지 알 수 없었습니다
- 해법 — 모델마다 스펙 카드를 만들어 프로그램이 읽는 창구로 내놓았어요. 읽을 수 있는 분량, 권장 방식, 끝난 이유 신뢰도, 생각 여유분, 대화 기억 방식이 같은 자리에 적힙니다
- 배운 것 — 카드는 읽는 쪽과 약속한 양식이어야 하고, 모르는 칸은 추측으로 채우지 않고 비워 둬야 해요. 첫 카드는 양식이 어긋나서 빈칸으로만 보였습니다
🏷️ 1. 메뉴판에는 이름만 있었다
5편에서 본 것처럼, 중계기를 쓰는 프로그램 쪽에는 메뉴판 한 장이 보입니다. claude/opus, claude/haiku, codex/gpt-5.5처럼 ‘AI 이름/모델 이름’이 줄줄이 적힌 목록이에요. 연결한 AI가 늘수록 메뉴판도 길어졌어요.
그런데 메뉴판은 이름표일 뿐이었습니다. 프로그램이 정말 알고 싶은 건 이름 뒤에 있었어요.
- 얼마나 큰 요청까지 받나 — 한 번에 읽을 수 있는 분량이 모델마다 크게 다릅니다. 긴 문서를 통째로 넣어도 되는지, 잘라서 나눠 보내야 하는지 알아야 해요
- ‘다 했다’는 표시를 믿어도 되나 — 답이 끝나면 왜 멈췄는지를 적은 끝난 이유가 붙어 옵니다(3편). 그런데 AI가 이 칸을 직접 채워 주지 않아서 중계기가 대신 적어 넣는 경우도 있어요
- 생각하느라 답 분량을 쓰나 — 답하기 전에 속으로 생각하는 생각형 모델은 그 생각도 답에 허락된 분량에서 같이 씁니다. 분량을 넉넉히 줬다고 생각했는데 생각하다 다 써 버리면, 정작 답이 비어서 돌아올 수 있어요
사람이라면 설명서를 찾아보거나 몇 번 써 보고 감을 잡겠죠. 하지만 프로그램에는 감이 없습니다. 모르면 가장 조심스러운 쪽, 말하자면 제일 작은 냉장고를 고를 수밖에 없어요.
✂️ 2. 스펙 카드가 생긴 날 — 잘게만 썰어 보내던 도구
이 문제가 실제로 터진 건 첫 버전을 만든 지 꼭 일주일 뒤인 7월 20일이었습니다.
중계기를 쓰던 다른 도구 가운데 긴 글을 AI에게 읽히는 도구가 있었어요. 이 도구는 모델이 한 번에 얼마나 읽을 수 있는지 알면 글을 크게 몇 덩어리로 나눠 보내고, 모르면 잘게 쪼개 하나씩 차례로 보내도록 만들어져 있었습니다. 모를 때 조심하는 건 옳은 선택이에요. 너무 크게 보냈다가 넘치면 실패하니까요.
문제는 중계기를 거치면 이 도구가 언제나 모르는 상태였다는 점이에요. 중계기에는 모델의 스펙을 알려 주는 창구가 아예 없었거든요. 그래서 한 번에 아주 긴 글을 읽을 수 있는 모델에게도 글을 잘게 썰어 하나씩 보냈고, AI를 직접 부를 때보다 주고받는 횟수가 크게 늘었습니다. 그날 문제가 된 건 NVIDIA의 클라우드 모델들이었는데, 공개 스펙상 100만 토큰 안팎을 한 번에 읽는 모델도 있었어요. 토큰은 AI가 글을 세는 단위예요.
그래서 그날 새벽, 중계기에 창구를 하나 더 열었습니다. 모델마다의 스펙을 프로그램이 읽을 수 있게 내놓는 스펙 카드 창구예요. 이름은 모델 특성(model traits)이라고 붙였어요. 5편에서 본 어댑터의 네 가지 약속 가운데 특성 약속이 바로 이 카드를 채우는 일입니다.
첫 카드에는 이런 줄이 있었어요.
- 한 번에 읽을 수 있는 분량, 답으로 내놓을 수 있는 최대 분량
- 권장 방식 — “크게 몇 번에 나눠 보내도 된다”
- 같은 모델에 동시에 몇 건까지 보내도 되는지
값은 그날 문제가 된 NVIDIA 모델들부터 공개 스펙을 보고 채웠어요. 이제 도구가 이 카드를 읽고 크게 몇 덩어리로 보내기만 하면 되는 일이었습니다. 그랬어야 했는데요.
🃏 3. 빈칸만 보인 스펙 카드
그런데 몇 시간 뒤의 기록에는 도구가 카드를 읽고 세운 나눠 보내기 계획이 깨졌다고 적혀 있어요. 도구 눈에는 카드가 빈칸으로만 보였던 거예요. 모델마다 카드는 분명히 있는데, 칸은 전부 비어 있는(undefined) 상태였습니다. 값이 없다는 뜻이에요.
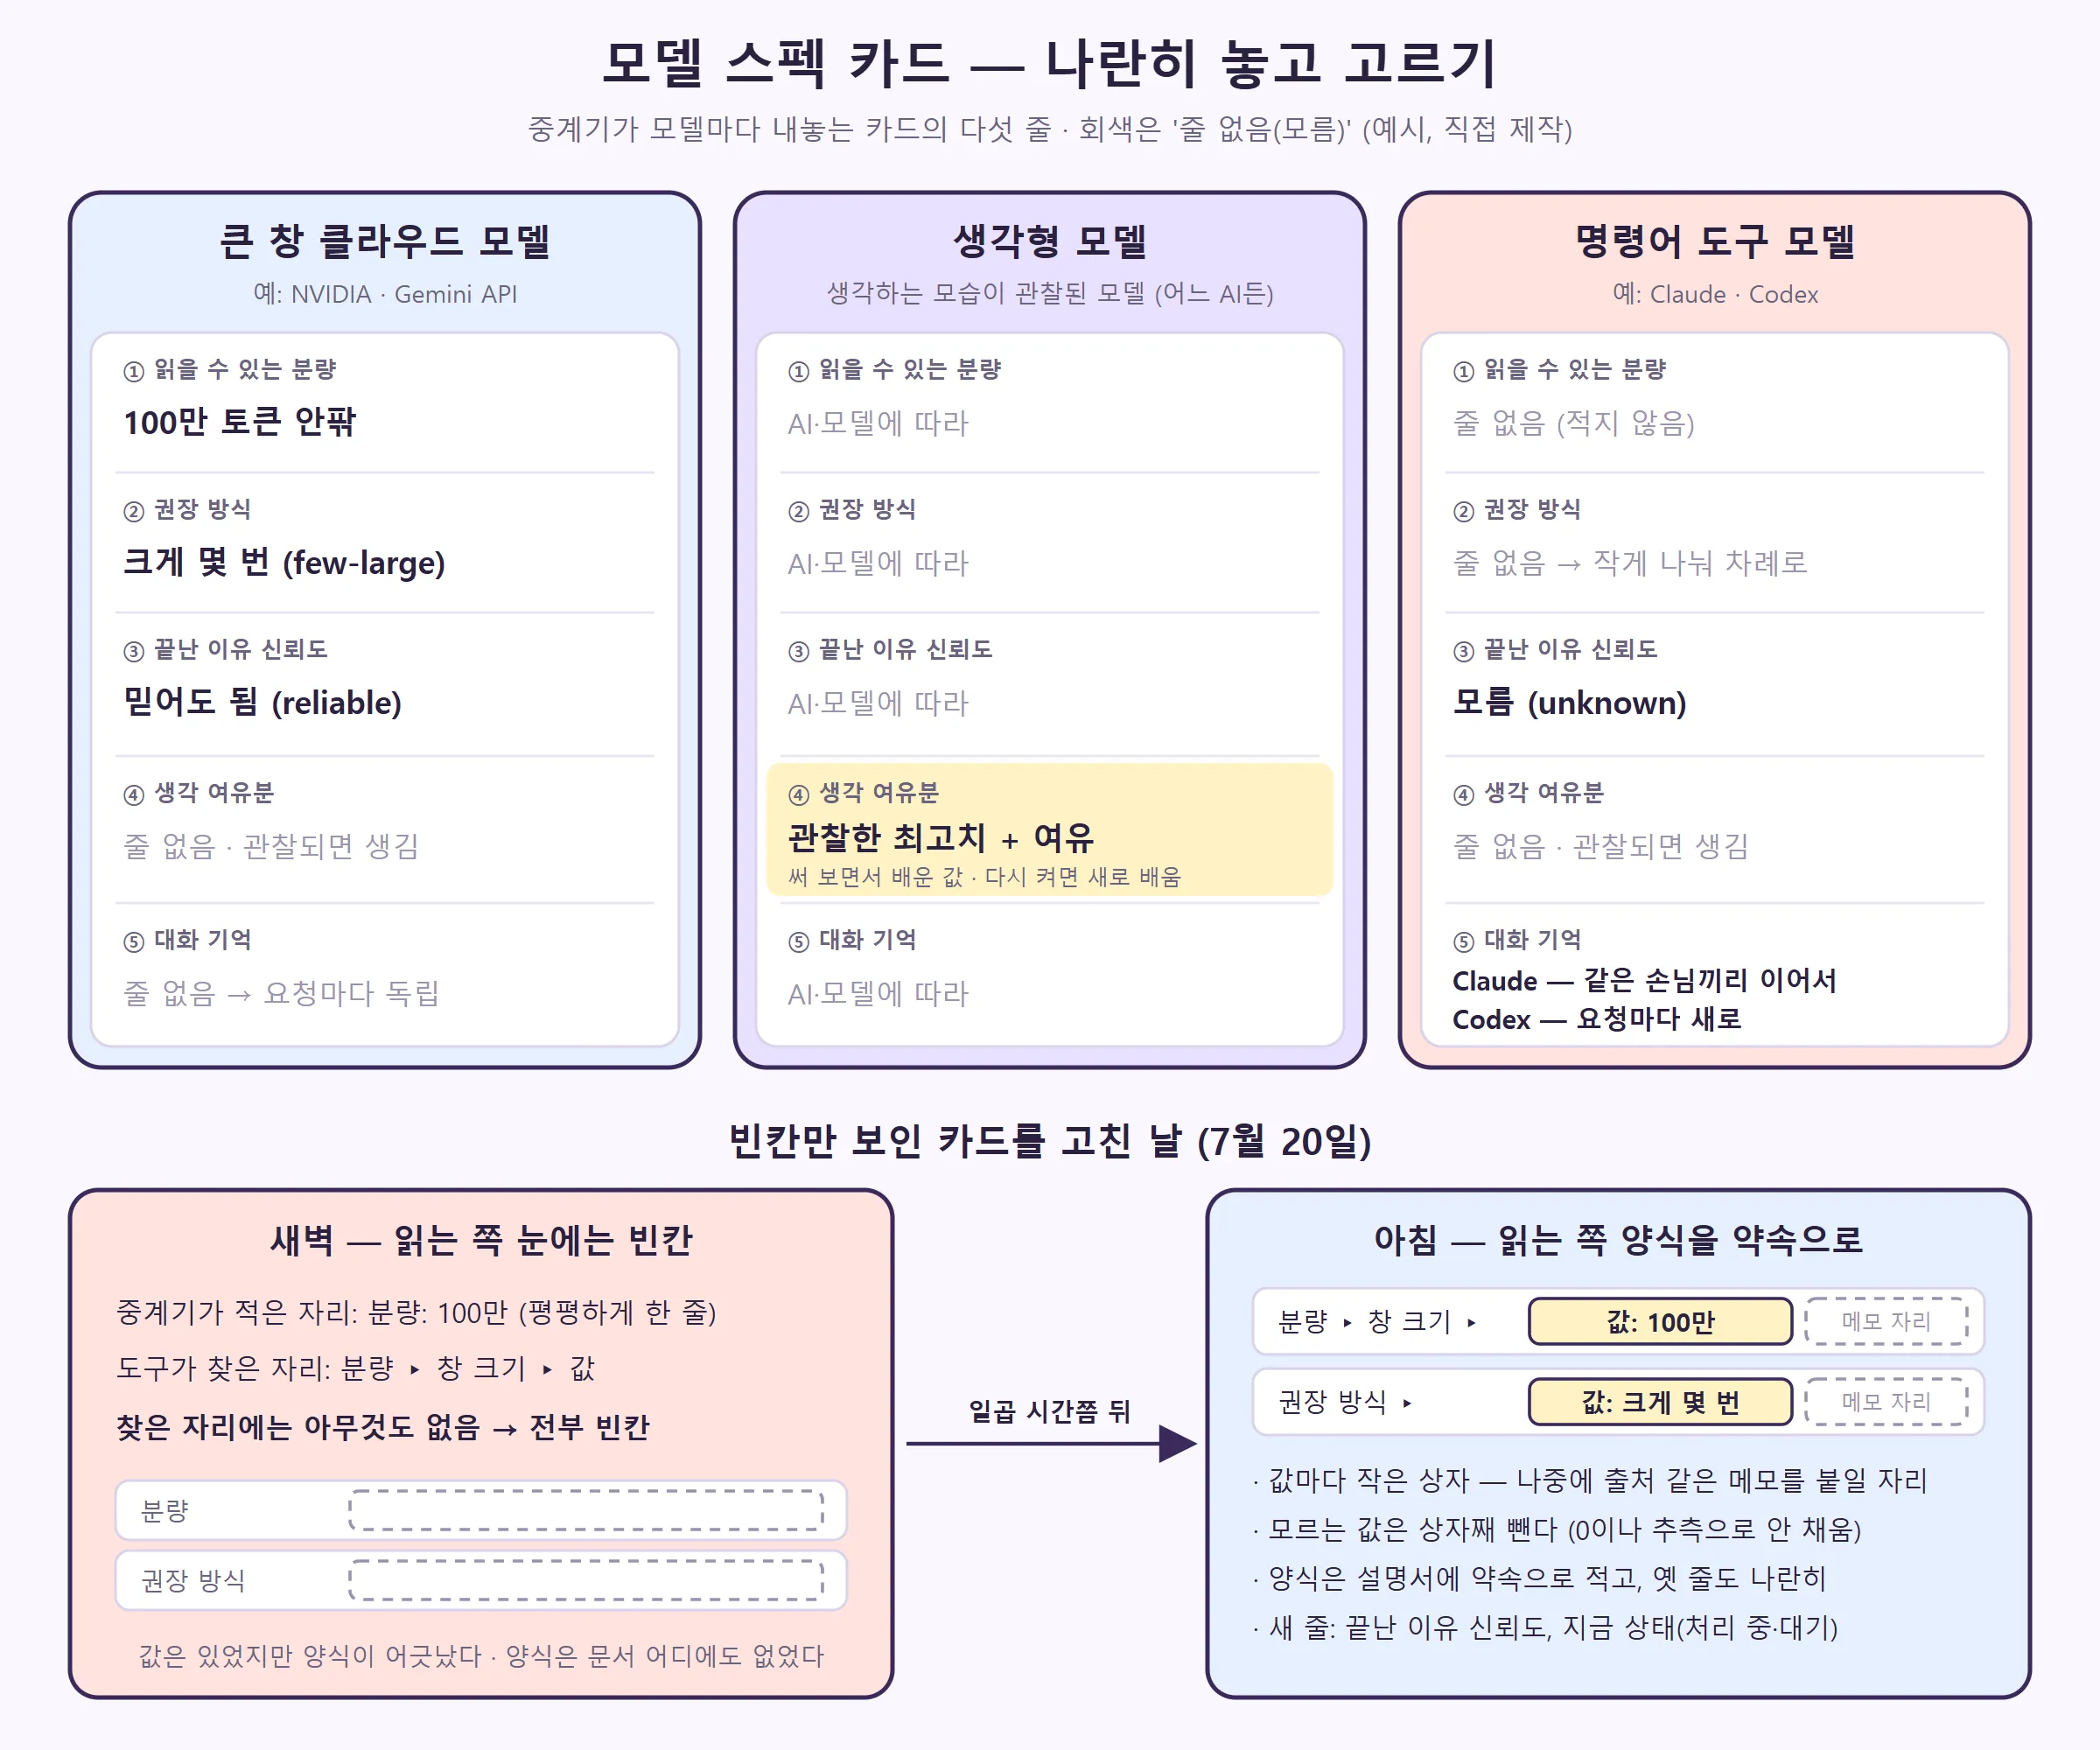
원인은 양식이었어요. 중계기는 값을 한 줄에 하나씩 평평하게 적었습니다. ‘읽을 수 있는 분량: 100만’처럼요. 그런데 그 도구는 처음부터 다른 양식을 기대하고 있었어요. ‘분량’ 칸 안에 ‘창 크기’ 칸이 있고, 그 안의 ‘값’ 상자에 숫자가 들어 있는, 칸 속에 칸이 있는 모양이었죠. 도구는 자기가 아는 자리만 찾아봤고, 거기엔 아무것도 없었습니다.
라벨로 치면 이런 상황이에요. 손님은 늘 라벨 왼쪽 위에서 용량을 찾는데, 매장은 그 숫자를 오른쪽 아래에 찍어 둔 거죠. 숫자는 적혀 있지만 손님 눈에는 빈칸입니다.
더 근본적인 원인도 있었어요. 카드 양식이 어디에도 문서로 적혀 있지 않았다는 점입니다. 중계기는 중계기대로, 도구는 도구대로 각자 생각하는 양식이 있었던 거예요.
같은 날 아침, 카드를 내놓은 지 일곱 시간쯤 뒤에 이렇게 고쳤습니다.
- 읽는 쪽 양식을 약속으로 삼았다 — 도구가 기대하던 ‘칸 속의 칸’ 모양으로 카드를 다시 짰어요. 그리고 중계기 설명서에 카드 양식을 설명하는 절을 새로 만들어 약속으로 적어 두었습니다
- 값마다 작은 상자 — 모든 값을 ‘값’ 상자에 담았어요. 상자로 담아 두면 나중에 값 옆에 ‘어디서 온 값인지’ 같은 메모를 함께 붙일 수 있습니다. 지금은 값만 들어 있지만, 자리를 미리 만들어 둔 셈이에요
- 모르는 값은 상자째 뺀다 — 모르는 칸에 0이나 추측값을 넣지 않고 그 칸을 아예 싣지 않아요. 읽는 쪽은 “칸이 없으면 모르는 것”으로 알면 됩니다
- 옛 양식도 나란히 — 평평한 양식을 이미 읽고 있는 프로그램이 있을 수 있어서, 예전 줄도 함께 남겼어요. 지금도 남아 있습니다
이때 카드에 줄이 둘 더 생겼어요. 끝난 이유를 믿어도 되는지, 그리고 지금 몇 건을 처리하고 몇 건이 줄 서 있는지 같은 지금 상태예요. 지금 상태는 매장의 ‘재고 있음’ 표시처럼 시시각각 바뀌는 실측값이라 상자 없이 그대로 적습니다.
📋 4. 카드에 적힌 다섯 줄
지금 카드에는 줄이 꽤 많아요. 그중 모델을 고를 때 가장 중요한 다섯 줄을 풀어 볼게요.
① 한 번에 읽을 수 있는 분량(window_tokens) 모델이 질문과 자료를 합쳐 한 번에 읽을 수 있는 양이에요. 흔히 컨텍스트 창이라고 부르죠. 쓰는 쪽은 이 값을 보고 문서를 통째로 넣을지, 몇 덩어리로 나눌지 정합니다. 다만 같은 글자 수라도 언어나 내용에 따라 토큰 수가 달라지니, 이 값은 출발점으로만 쓰고 “분량이 넘쳤다”는 오류에도 대비하라고 설명서에 적어 뒀어요.
② 권장 방식(strategy) ‘크게 몇 번(few-large)‘이라고 적힌 모델은 문서를 쪼개지 않거나 큰 덩어리로 보내도 된다는 뜻이에요. 이 줄이 없는 모델이라면 쓰는 쪽은 조심스럽게 작게 나눠 차례로 보내면 됩니다. 2절의 도구가 원래 하던 바로 그 방식이죠. 달라진 건, 이제 그게 몰라서가 아니라 카드를 보고 고른 방식이라는 점이에요.
③ 끝난 이유 신뢰도(finish_reason reliability) 값은 둘 중 하나예요. 믿어도 됨(reliable)은 AI가 보낸 끝난 이유를 중계기가 그대로 전달하는 경우입니다. NVIDIA나 구글 Gemini API처럼 웹 주소로 부르는 AI가 여기에 해당해요. 어댑터가 따로 밝히지 않은 AI는 전부 모름(unknown)으로 적힙니다. 명령어 도구로 부르는 Claude·Codex·Gemini가 지금 이쪽이에요. ‘모름’은 나쁘다는 뜻이 아니라, 쓰는 쪽이 “잘렸을 수도 있다”는 가능성을 염두에 두고 한 번 더 확인하라는 뜻입니다.
④ 생각 여유분(headroom_tokens)과 관찰한 최고치(observed_peak_tokens) 생각형 모델의 카드에만 생기는 줄이에요. 중계기는 모델들이 실제로 생각에 쓴 분량을 지켜보다가, 생각하는 모습이 보인 모델에 “이 모델은 생각에 답 분량을 함께 쓴다”는 표시를 달고 지금까지 본 가장 큰 생각 분량을 적어 둡니다. 생각 여유분은 그 최고치에 조금 더 얹은 값이에요. 쓰는 쪽은 “원하는 답 분량 + 생각 여유분”으로 계획하면 됩니다. 이 값은 미리 적어 둔 표가 아니라 써 보면서 배운 값이라, 중계기를 다시 켜면 처음부터 다시 배워요. 생각 분량을 왜 배워야 했는지는 4부 15편 “생각만 하다 답을 못 한 AI”에서 자세히 다룰게요.
⑤ 대화 기억 방식(session) 명령어 도구로 부르는 AI는 켜 둔 채 쓰기도 해서(6편), 앞의 대화를 기억하는 방식이 모델마다 달라요. Codex는 요청마다 새로(per-request) 시작하고, Claude는 같은 손님끼리 이어서(per-client) 기억합니다. 같은 프로그램이 보낸 요청은 한 대화로 이어 붙는다는 뜻이에요. 이 줄이 없는 모델은 요청마다 독립입니다. 7편에서 본 ‘빈 책상’, 그러니까 AI를 빈 전용 폴더에서 띄운다는 사실도 이 줄 옆에 함께 적혀 있어요.
이 밖에도 동시에 몇 건까지 받는지, 그림이나 영상을 만들 수 있는지 같은 줄이 있어요. 동시에 몇 건까지 받는지는 3부에서 이어 갈게요.
✏️ 5. 아는 만큼만 적는다
카드를 만들면서 지킨 규칙은 결국 하나로 모입니다. 모르면 비워 둔다는 것이에요.
- 읽을 수 있는 분량을 모르는 모델은 그 줄을 싣지 않아요. 기본 설정에서 Claude·Codex 같은 명령어 도구 모델의 카드에는 이 줄이 없습니다
- 끝난 이유는 확인된 AI만 ‘믿어도 됨’이고 나머지는 ‘모름’이에요. 코드에 남긴 메모를 그대로 옮기면 “과장 금지”예요
- 생각 여유분은 실제로 본 뒤에야 적어요. 보기 전에는 줄 자체가 없습니다
왜 이렇게까지 할까요? 틀린 값은 빈칸보다 위험하기 때문이에요. 읽을 수 있는 분량을 실제보다 크게 적으면, 쓰는 쪽은 그 말을 믿고 큰 덩어리를 보냈다가 실패합니다. 빈칸이면 적어도 조심스럽게 움직이죠. 냉장고 라벨로 치면 용량을 부풀려 적는 것보다 “확인 중”이라고 적는 편이 손님에게 낫습니다.
카드는 그 뒤로도 중계기와 함께 자랐어요.
- 8월 11일 — 생각 여유분과 관찰한 최고치
- 8월 19일 — 대화 기억 방식
- 9월 하순 — 빠른 판정, 그림, 영상을 할 수 있는지
그리고 중계기가 바뀌어도 쓰는 쪽은 알 길이 없던 문제를 풀려고, 9월 24일부터는 중계기가 할 수 있는 일을 알려 주는 명세에 카드 양식의 판 번호도 함께 싣고 있어요. 지금은 2판입니다. 7월 20일의 빈칸 카드처럼 양식이 어긋나는 일을, 깨지고 나서가 아니라 미리 알아챌 수 있게 하려는 장치예요.
정리
① 메뉴판의 이름만으로는 프로그램이 모델을 고를 수 없어서, 모델마다 읽을 수 있는 분량·권장 방식·끝난 이유 신뢰도·생각 여유분·대화 기억 방식을 적은 스펙 카드를 내놓았어요 ② 첫 카드는 읽는 쪽이 기대한 양식과 달라 빈칸으로만 보였고, 같은 날 아침 읽는 쪽 양식을 약속으로 삼아 설명서에 적고 값마다 상자를 두는 모양으로 고쳤어요 ③ 모르는 칸은 추측으로 채우지 않고 비워 둡니다. 틀린 값은 빈칸보다 위험하니까요
이번 편으로 2부 ‘여러 AI를 한 줄로’를 마칩니다. 다음 10편부터는 3부 ‘교통정리’가 시작돼요. 첫 이야기는 “중계기에 톨게이트가 필요한 이유”입니다. 여러 프로그램이 한꺼번에 몰려올 때 누구를 먼저, 몇 대씩 들여보낼지 정한 이야기예요.
2026년 10월 1일 기준입니다. 제가 만든 중계기의 개발 기록을 바탕으로 썼고, 특정 기업·서비스의 공식 입장이 아닙니다.