이 글에는 제휴 링크가 없고 OpenAI·앤트로픽·구글·NVIDIA·fal과 아무 관계가 없습니다. 제가 직접 만든 중계기의 개발 기록을 바탕으로 썼습니다. 삽화는 GPT 이미지 생성, 도식은 직접 제작했습니다.
1분에 몇 번까지 부를 수 있나 — 은행 창구 번호표처럼 간격을 두는 페이서 (LLM 중계기 개발기)
창구가 하나뿐인 작은 은행을 떠올려 볼게요. 이 창구는 사정이 있어서 한 시간에 손님을 여섯 명까지만 받는다고 해 봅시다(가상의 예예요). 문이 열리는 9시 정각에 손님 여덟 명이 한꺼번에 창구로 몰려가면 어떻게 될까요? 여섯 명까지는 받아도, 일곱째와 여덟째 손님은 “이번 시간 몫은 끝났어요. 10시에 다시 오세요”라는 말을 듣고 돌아서야 해요. 헛걸음이죠.
눈치 빠른 안내원이 있다면 다르게 합니다. 번호표를 나눠 주면서 “10분 간격으로 한 분씩 불러 드릴게요”라고 말해요. 손님들은 의자에 앉아 기다리다 자기 차례에 창구로 가고, 창구는 한 번도 손님을 돌려보내지 않아요. 마지막 손님이 끝나는 시각은 크게 다르지 않은데, 헛걸음이 사라집니다.
제가 만든 LLM 중계기에도 이 안내원 같은 부품이 있어요. 이름은 페이서(pacer)예요. 마라톤에서 일정한 속도로 앞에서 달려 주는 페이스메이커처럼, 요청을 보내는 속도를 고르게 맞춰 준다는 뜻이에요.
이 글은 LLM 중계기 개발기의 12편입니다. 지난 11편 「전화를 끊었는데 상담원은 계속 대기 중」에서는 ‘그만’ 신호를 끝까지 전해야 차선이 막히지 않는다는 이야기를 했어요. 10편의 차선이 ‘동시에 몇 건’을 지키는 장치였다면, 오늘은 ‘1분에 몇 번’을 지키는 장치 이야기입니다.
결론 요약
- 한도는 하나가 아니다 — AI 서비스에는 ‘동시에 몇 건’ 말고도 1분에 몇 번(RPM)과 1분에 토큰 몇 개(TPM) 한도가 있어요. 넘으면 429라는 거절 번호와 함께 “이만큼 뒤에 다시 오라”는 안내(Retry-After)가 옵니다
- 거절당하기 전에 간격을 둔다 — 중계기의 페이서는 최근 1분의 기록을 보면서 요청 시작 시각을 고르게 띄워요. 거절당하고 다시 보내는 대신, 처음부터 거절당하지 않을 시각에 보냅니다
- ‘잠깐 붐빔’과 ‘다 씀’은 다르다 — 같은 429라도 몇 초면 풀리는 것과 내일까지 안 풀리는 것이 있어요. 중계기는 둘을 나눠, 다시 올 시간을 다르게 알려 줍니다
⏱️ 1. ‘동시에 몇 건’과 ‘1분에 몇 번’은 다른 한도
10편에서 본 차선은 동시에 달릴 수 있는 요청 수였어요. 그런데 인터넷 너머의 AI 서비스는 흔히 이것 말고도 시간당 한도를 둬요. 자주 보는 두 가지가 이거예요.
| 이름 | 풀어 쓰면 | 은행으로 치면 |
|---|---|---|
| RPM (Requests Per Minute) | 1분에 보낼 수 있는 요청 수 | 한 시간에 받는 손님 수 |
| TPM (Tokens Per Minute) | 1분에 주고받을 수 있는 글의 양 | 한 시간에 처리하는 서류 장수 |
토큰은 AI가 글을 세는 단위예요(9편에서 잠깐 나왔어요). 내가 보낸 질문도, AI가 쓴 답도 모두 토큰으로 셉니다.
‘동시에 몇 건’과 ‘1분에 몇 번’은 서로 다른 데서 막혀요.
- 답이 빨리 오는 짧은 요청은 차선 하나로도 1분에 수십 번을 보낼 수 있어요. 동시 한도는 넉넉한데 1분 횟수 한도에 먼저 걸리죠
- 답이 몇 분씩 걸리는 큰 요청은 반대예요. 1분 횟수를 채울 틈도 없이 차선이 먼저 꽉 차요
10편에서 NVIDIA의 차선을 늘린 이유가 두 번째였어요. 중계기 기록에는 NVIDIA 클라우드 API의 한도가 열쇠 하나당 1분에 40번으로 적혀 있어요. 1.5초에 한 번꼴이죠. 그런데 큰 코드 검토처럼 답 하나에 몇 분씩 걸리는 요청을 몇 건씩 동시에 보내는 쓰임에서는, 1분에 40번에 닿기 전에 차선이 먼저 찼어요.
두 한도의 비율은 일을 나누는 방법도 바꿔요. 횟수는 귀하고 토큰은 넉넉한 서비스라면, 긴 문서를 잘게 쪼개 여러 번 보내기보다 크게 몇 번에 나눠 보내는 편이 유리해요. 9편의 스펙 카드에 있던 ‘크게 몇 번(few-large)‘이라는 권장 방식이 이런 서비스와 잘 맞아요.
🚫 2. 넘으면 429, 그리고 ‘다시 올 시간’
한도를 넘은 요청에 AI 서비스는 보통 429로 답해요. 8편과 10편에서 본 ‘너무 많이, 너무 자주 왔다’는 번호예요. 친절한 서비스는 여기에 한 가지를 더 붙여 줘요. Retry-After, 우리말로 하면 “이만큼 뒤에 다시 와 보세요”라는 안내예요.
중계기는 이 안내를 버리지 않고 읽어요.
- 초로 오든 시각으로 오든 — “30초 뒤”처럼 초로 올 때도, “몇 시 몇 분 이후”처럼 시각으로 올 때도 기다릴 시간으로 바꿔요
- 안내가 본문에만 있을 때 — 따로 적힌 칸이 없으면 오류 문장 안에서 “retry after 몇 초” 같은 문구를 찾아봐요
- 자세히 알려 주는 곳 — 구글의 Gemini API는 거절할 때 ‘어떤 한도에 걸렸는지’와 ‘얼마나 기다리면 되는지’를 본문에 함께 적어 보내요. 중계기는 둘 다 읽어요(5절에서 이어서 볼게요)
그리고 이 안내를 쓰는 쪽 프로그램에 그대로 전해요. 중계기가 돌려주는 429에는 언제나 다시 올 시간이 두 군데에 들어 있어요. 응답의 머리말(헤더)에 Retry-After로 한 번, 본문에 retry_after_ms(1000분의 1초 단위)로 한 번이에요. AI 서비스가 아무 안내도 주지 않았다면 중계기가 기본값을 채워요. 기본은 1초이고, Gemini API의 1분 한도처럼 10초로 따로 정해 둔 곳도 있어요.
중계기를 쓰는 프로그램을 만들 때 참고하라고 중계기가 내어 주는 개발 안내서에도 같은 규칙을 적어 뒀어요. ‘안정성 규칙’ 칸에 “429가 오면 다시 올 시간만큼 기다린 뒤 재시도하고, 기다리는 중이라고 화면에 표시하라”는 줄이 있어요. API 문서에는 하나가 더 붙어요. 기다릴 시간에 조금씩 다른 여유를 더하라는 거예요. 개발자들은 이걸 지터(jitter)라고 불러요. 여러 프로그램이 모두 똑같이 “정확히 1초 뒤”를 지키면, 1초 뒤에 또 한꺼번에 몰리니까요.
페이서를 모든 AI에 붙이지는 않는다
NVIDIA에는 페이서가 없어요. 1절에서 본 쓰임에서는 1분 한도보다 차선이 먼저 막혔고, 혹시 한도를 넘으면 NVIDIA가 보내는 429와 다시 올 시간을 그대로 전해서 다시 보낼지는 쓰는 쪽이 정해요. 페이서는 1분 횟수가 정말 귀한 AI를 위해 만든 부품이에요.
이 대목에는 작은 고백이 하나 있어요. 7월 21일부터 8월 8일까지, 중계기 개발 문서에는 ‘NVIDIA에도 열쇠당 1분 40번짜리 페이서가 있다’고 적혀 있었어요. 8월 8일 NVIDIA 연결을 다시 정리하던 날 코드와 맞춰 보니, 그런 페이서는 만든 적이 없었어요. 문서를 사실대로 고쳐서, 한도를 넘으면 NVIDIA의 429와 다시 올 시간이 그대로 전달된다고 적었어요. 문서와 코드가 다르면 믿을 건 코드예요.
🎫 3. 거절당하기 전에 간격을 두는 페이서
페이서가 하는 일은 두 가지예요. 최근 1분의 장부를 지키고, 요청과 요청 사이에 간격을 둬요.
최근 1분 장부 — 미끄러지는 창
페이서는 요청을 보낼 때마다 보낸 시각을 장부에 적어요. 새 요청이 오면 지금부터 거꾸로 1분 안에 적힌 기록만 세고, 1분이 지난 기록은 지워요.
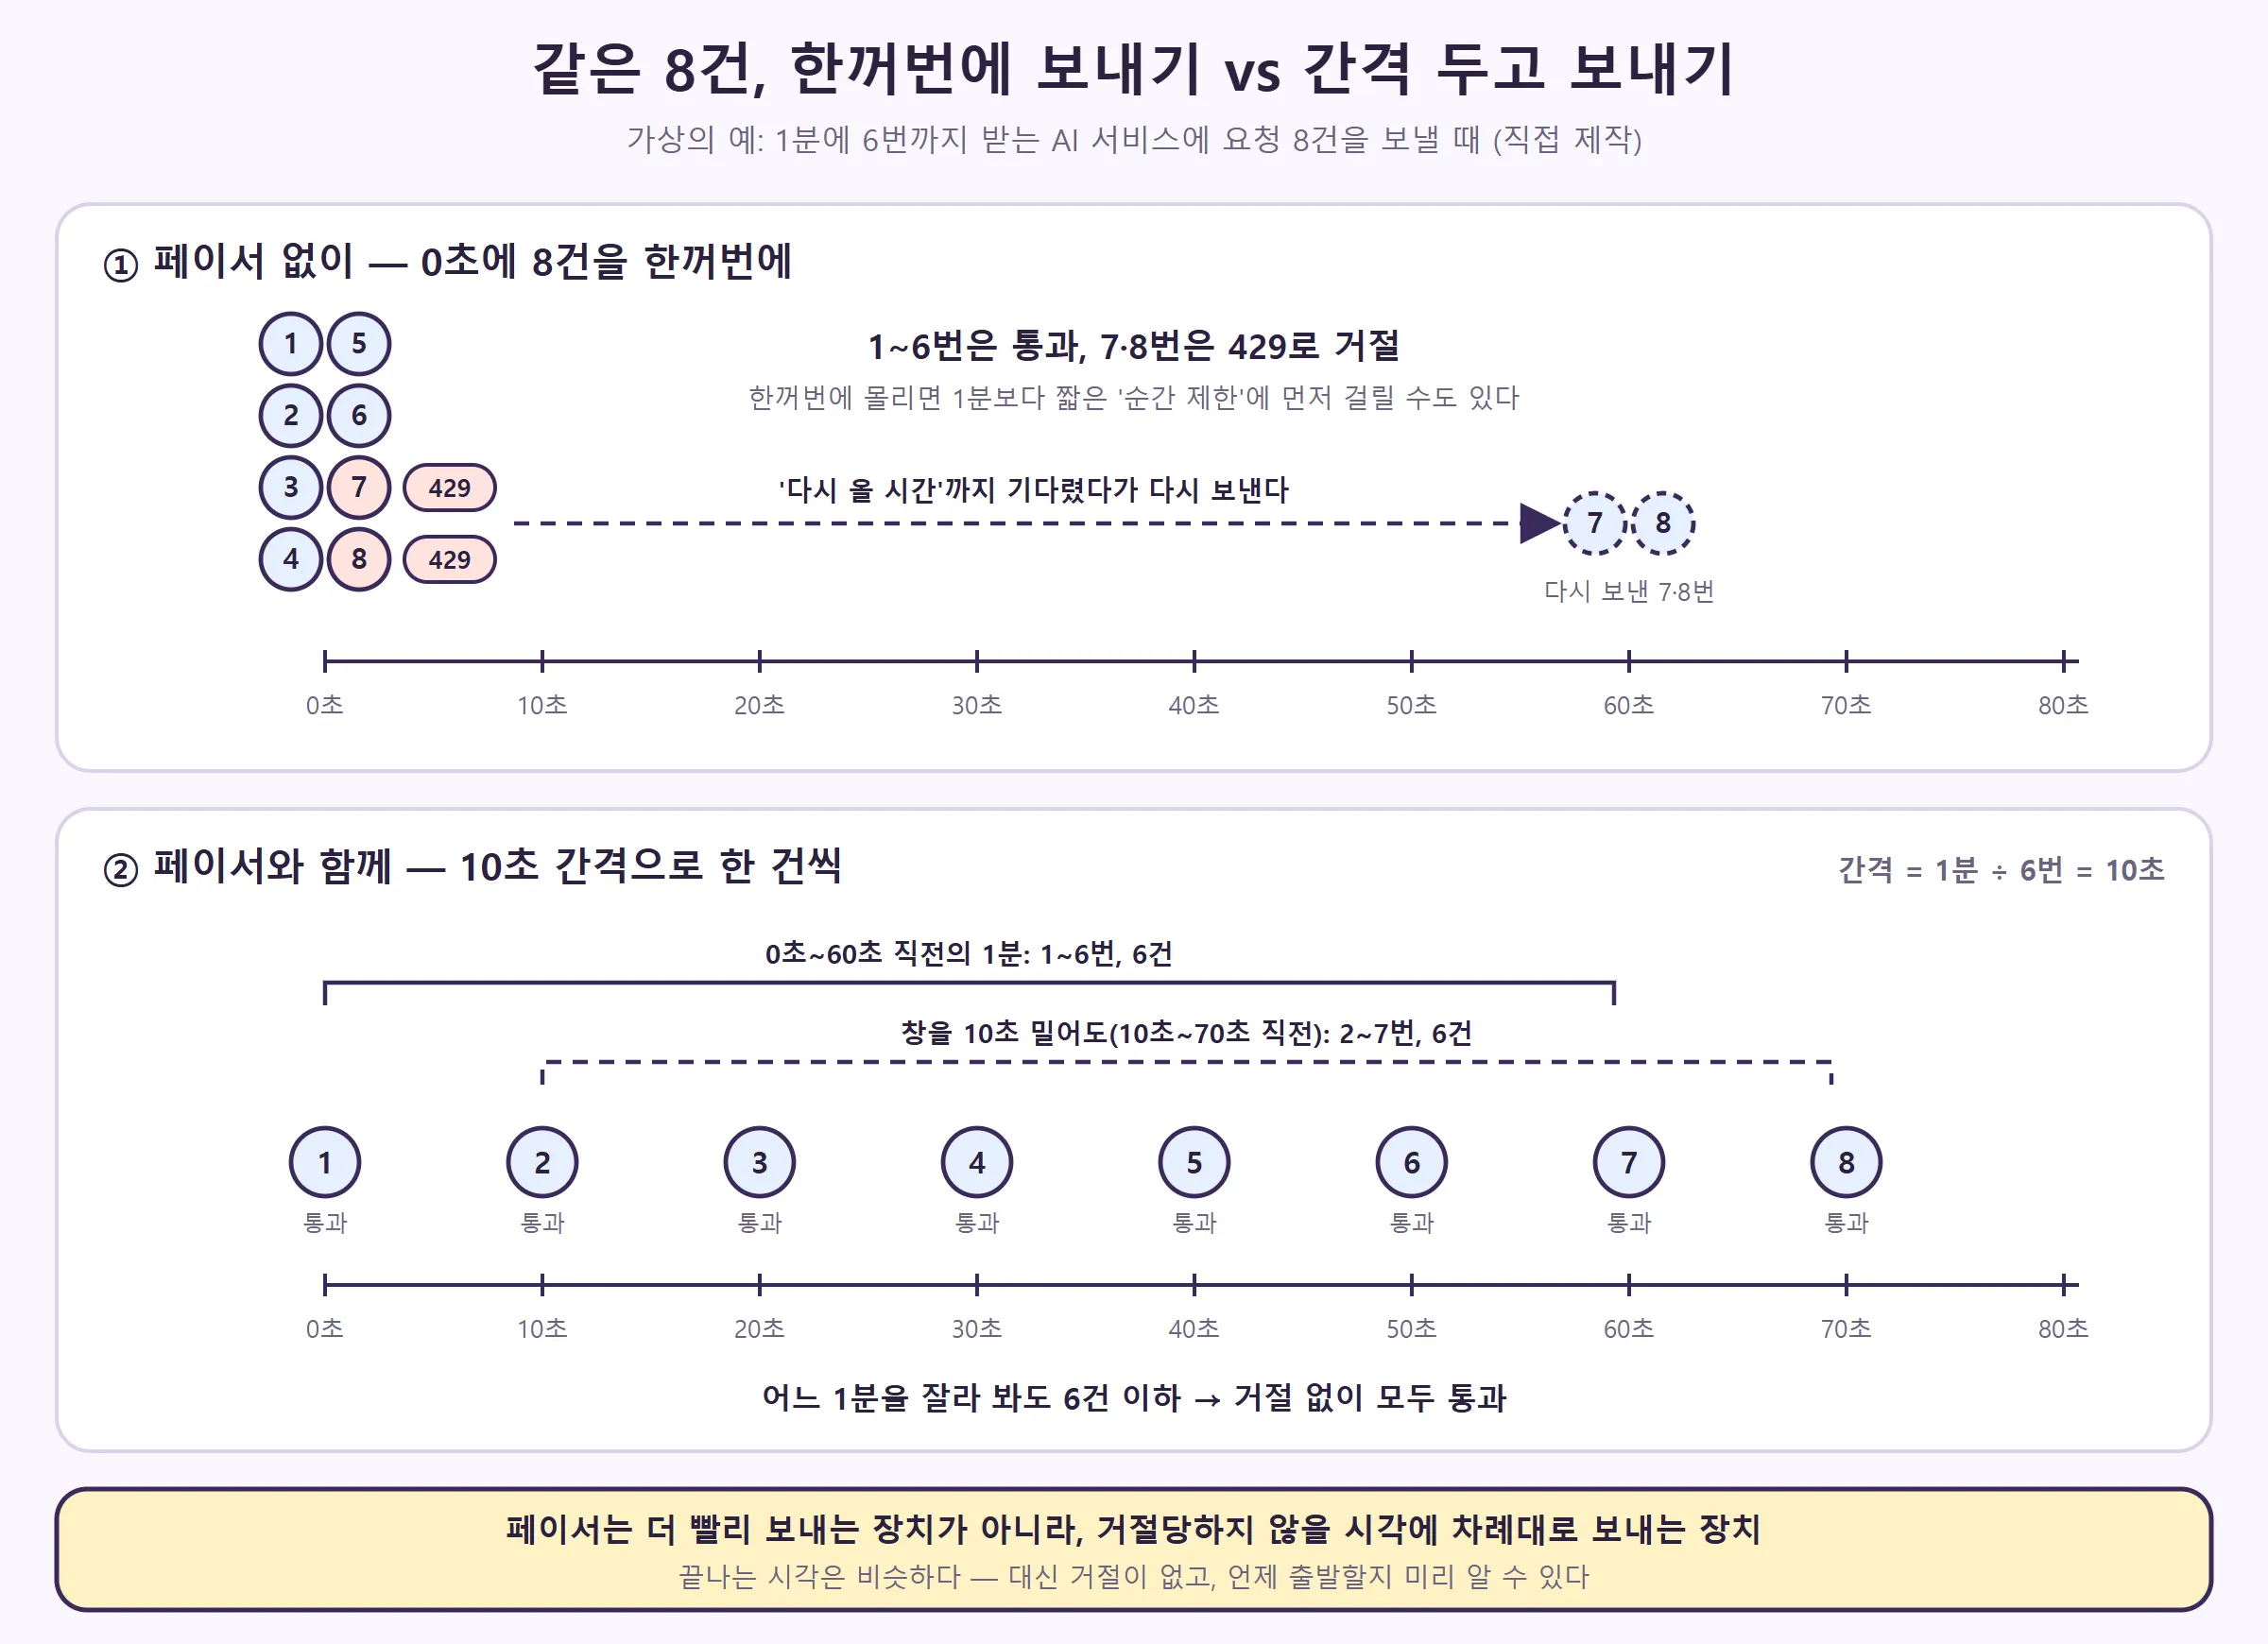
여기서 ‘1분’은 시계의 정각에 맞춘 1분이 아니에요. 매 순간 ‘방금 전 1분’을 다시 잡아요. 창틀을 시간 위로 조금씩 밀면서 들여다보는 것 같아서 흔히 미끄러지는 창(sliding window)이라고 불러요. 정각마다 장부를 비우는 방식이라면 0분 59초에 한도만큼 보내고 1분 00초에 또 한도만큼 보내서, 1초 사이에 한도의 두 배가 나갈 수 있어요. 미끄러지는 창에서는 어느 1분을 잘라 봐도 한도를 넘지 않아요.
균등 간격 — 첫 줄도 몰려 나가지 않게
7월 13일 이 부품을 처음 만들었을 때는 장부만 봤어요. 최근 1분에 여유가 있으면 바로 통과시키는 방식이었죠. 그런데 여기에 빈틈이 있었어요. 한동안 조용하다가 요청이 몰리면, 장부가 비어 있으니 한도만큼이 한꺼번에 나가요. 서비스 쪽에 1분보다 짧은 ‘순간 제한’이 따로 있다면 거기에 걸릴 수 있어요.
그래서 이틀 뒤인 7월 15일, 10편의 교통정리 칸이 처음 들어온 v0.1.31에서 페이서에 균등 간격을 더했어요. 요청과 요청의 출발 사이를 ‘1분 ÷ 한도’만큼 띄우는 거예요. 예를 들어 1분에 6번까지인 서비스라면 10초, 1분에 12번이라면 5초 간격이에요.
셋 중 가장 늦은 시각에 출발
요청 하나를 보내기 전에 페이서는 세 가지를 확인해요.
- ① 직전 요청이 출발한 뒤 간격만큼 지났나
- ② 최근 1분 장부의 요청 수가 한도보다 적은가 — 꽉 찼다면 가장 오래된 기록이 1분 밖으로 빠지는 시각까지 기다려요
- ③ 최근 1분 장부의 토큰 합에 이번 요청의 몫을 더해도 한도 안인가 — 4절에서 자세히 볼게요
셋 중 가장 늦은 시각까지 기다렸다가 출발해요. 기다리는 요청들은 온 순서대로 한 줄로 서요.
도식에서 보듯 페이서가 일을 더 빨리 끝내 주지는 않아요. 마지막 요청이 출발하는 시각은 비슷하거나 오히려 조금 늦어요. 대신 거절이 없고, 언제 출발할지 미리 알 수 있어요. 쓰는 쪽 프로그램이 실패를 받아 들고 다시 보낼 궁리를 할 필요가 없죠.
기다리는 중임을 보여 주고, 취소하면 흔적 없이
- 기다리는 중이라고 말한다 — 기다리는 동안 중계기는 기록에 “다음 요청까지 약 몇 초, 대기 몇 건”을 남겨요. 관리 화면에서 시험 호출을 눌렀는데 페이서 때문에 기다려야 하면 ”⏳ 대기 중… 다음 요청까지 N초”를 1초마다 새로 보여 줘요. 아무 표시 없이 멈춰 있으면 사람은 고장 난 줄 알거든요
- 취소되면 장부에 남기지 않는다 — 줄에서 기다리던 요청이 11편의 ‘그만’ 신호로 취소되면 바로 줄에서 빠지고, 장부에는 아무것도 적지 않아요. 보내지도 않은 요청이 1분 몫을 차지하면 안 되니까요
📒 4. 토큰 장부 — 미리 잡아 두고, 끝나면 고쳐 적는다
횟수는 보내는 순간 셀 수 있어요. 토큰은 그렇지 않아요. 질문의 길이는 보낼 때 알지만, 답이 얼마나 길지는 답이 끝나야 알거든요.
그래서 페이서의 토큰 장부는 호텔 체크인 때의 카드 가승인처럼 움직여요. 들어갈 때 넉넉히 잡아 두고, 나갈 때 실제 금액으로 바꾸는 방식이에요.
- 보내기 전에 넉넉히 잡아 둔다 — 질문 길이로 어림한 토큰에, 이번 답에 허락한 최대 길이를 더해 장부에 미리 적어요. 어림은 글자 4개를 1토큰으로 쳐요. 영어 기준의 대략적인 셈이라, 한국어처럼 토큰을 더 먹는 글에서는 빗나갈 수 있어요. 이 이야기는 19편에서 따로 다룰게요
- 끝나면 고쳐 적는다 — 답이 끝나면 질문과 실제로 받은 답의 길이로 다시 어림해, 그 요청의 칸만 고쳐요. 여러 요청이 동시에 오가도 서로의 칸을 건드리지 않아요
- 답을 못 받은 요청은 횟수만 — 서비스가 받아 주지 않은 요청은 1분 횟수로는 한 번으로 치지만, 토큰은 0으로 적어요
- 혼자서도 한도를 넘는 요청은 줄 세우지 않는다 — 한 건이 1분 토큰 한도보다 크면 아무리 기다려도 들어갈 수 없어요. 이런 요청은 줄에 세우지 않고 바로 “한도를 넘는다”며 돌려보내요. 10편에서 봤듯 대답 없이 끝없이 기다리는 요청이 가장 곤란하니까요
예를 들어 1분에 토큰 10만 개까지인 서비스에, 질문과 답 상한을 합쳐 2만5천 토큰짜리 요청을 보낸다고 해 볼게요. 1분 횟수 한도가 아무리 넉넉해도 네 건이면 토큰 장부가 차요. 다섯째 요청은 첫째 요청의 기록이 1분 밖으로 빠질 때까지 기다려요. 앞선 답이 상한보다 짧게 끝나 장부를 고쳐 적으면, 그만큼 더 일찍 들어갈 수도 있고요.
1분을 기다리지 않는 시험
페이서를 시험하려고 진짜 1분씩 기다리면 시험 한 번에 몇 분이 걸려요. 그래서 페이서는 시계를 갈아 끼울 수 있게 만들었어요. 시험에서는 ‘기다린다’가 실제로 기다리는 대신 가짜 시계의 바늘만 앞으로 돌려요. 몇 분짜리 상황을 순식간에 확인할 수 있죠. 확인하는 건 이런 것들이에요.
- 연달아 넣은 요청이 정확히 같은 간격으로 출발하는지
- 어느 1분을 잘라 봐도 한도보다 많이 들어가지 않는지
- 횟수에 여유가 있어도 토큰 장부가 차면 기다리는지
- 혼자서 한도를 넘는 요청은 기다리지 않고 바로 거절되는지
- 기다리다 취소된 요청은 장부에 아무것도 남기지 않는지
- 동시에 고쳐 적은 두 요청의 토큰이 서로 섞이지 않는지
🌙 5. ‘잠깐 붐빔’과 ‘오늘 몫을 다 씀’은 다르다
같은 429라도 성격이 둘이에요. 8편에서 한 줄로 말했던 차이를 조금 더 들여다볼게요.
| 잠깐 붐빔 | 다 씀 | |
|---|---|---|
| 걸린 한도 | 1분 한도 | 하루 한도, 계정 사용 한도, 선불 잔액 |
| 기다리면 | 몇 초~1분이면 풀려요 | 금방 다시 해도 안 풀려요 |
| 중계기의 이름표 | provider_rate_limited | insufficient_quota |
| 다시 올 시간 | 짧게 | 길게 |
은행으로 치면 앞은 “번호표 뽑고 잠시만 기다리세요”, 뒤는 “오늘 창구 업무는 끝났습니다. 내일 오세요”예요. 둘을 섞어서 알리면 곤란해져요. 다 쓴 걸 잠깐 붐빈 것처럼 알리면, 쓰는 쪽은 1초마다 닫힌 창구를 두드리게 되니까요.
9월 말에 붙인 구글의 Gemini API가 이 차이를 잘 보여 줘요. 무료 등급에는 모델마다 1분 한도와 하루 한도가 따로 있어요. 거절할 때 구글은 본문에 어떤 한도에 걸렸는지 이름을 적어 보내는데, 중계기는 그 이름에 ‘분당’(PerMinute)이 들어 있는지 ‘일일’(PerDay)이 들어 있는지를 봐요.
- 1분 한도에 걸렸으면 잠깐 붐빔이에요. 구글이 알려 준 시간만큼(안내가 없으면 10초) 뒤에 다시 오라고 전해요
- 하루 한도에 걸렸으면 다 쓴 거예요. 그 모델만 ‘지금은 쓸 수 없음’으로 표시하고, 다시 올 시간을 미국 서부 시간 자정으로 잡아요. 한국 시간으로는 서머타임 여부에 따라 오후 4시나 5시쯤이에요. 같은 Gemini라도 다른 모델은 계속 쓸 수 있어요
모델별 무료 한도는 구글의 AI Studio 화면에서 확인하는 값이라, 중계기에는 추정값만 적어 두고 ‘오늘 얼마나 남았나’를 어림하는 데만 써요. 진짜 기준은 구글이 보내는 429예요. 10편에서 ‘상대가 거절하면서 직접 알려 주는 한도가 가장 정확한 측정값’이라고 했던 것과 같은 원칙이에요.
‘다 씀’은 다른 곳에도 있어요.
- Codex·Claude 계정의 사용 한도를 다 쓰면 연결은 그대로 두고, 다시 올 시간을 기본 10분으로 길게 알려 줘요
- 영상을 만드는 서비스 fal의 선불 잔액이 바닥나면, 연결 고장이 아니라 ‘다 씀’으로 분류해 10분 뒤에 다시 오라는 안내와 충전 안내를 함께 돌려줘요
9월 말 버전(v0.1.105)부터는 모델 이름 대신 ‘빠른 채팅용’ 같은 역할 이름으로 부를 수도 있어요. 이렇게 부르면 중계기가 다 쓴 모델을 후보에서 빼고, 다음 요청을 곧장 다른 모델로 보내요. 다 쓴 모델은 다시 올 시간이 지나면 후보로 돌아오고요. 후보가 모두 다 썼다면 그중 가장 빨리 풀리는 시각을 알려 줘서, 쓰는 쪽이 그때까지 속도를 늦출 수 있게 해요.
정리
① AI 서비스에는 ‘동시에 몇 건’ 말고도 ‘1분에 몇 번(RPM)‘과 ‘1분에 토큰 몇 개(TPM)’ 한도가 있고, 넘으면 429와 다시 올 시간(Retry-After)이 와요. 중계기는 이 시간을 읽어 쓰는 쪽에 그대로 전해요 ② 중계기의 페이서는 최근 1분 장부를 보며 요청 출발을 ‘1분 ÷ 한도’ 간격으로 고르게 띄우고, 토큰은 미리 잡아 두었다가 끝나면 고쳐 적어요. 거절당하고 다시 보내는 대신 처음부터 거절당하지 않을 시각에 보내요 ③ 같은 429라도 ‘잠깐 붐빔’은 짧게, ‘다 씀’은 길게 다시 올 시간을 알려 주고, 역할 이름으로 부르면 다 쓴 모델을 건너뛰어요 — 다음 편은 “설정 한 줄 빠졌을 뿐인데 전멸”입니다
차선과 대기 줄 이야기는 10편에, 429 말고 401·403은 무슨 뜻인지는 8편에 있어요.
2026년 10월 1일 기준입니다. 제가 만든 중계기의 개발 기록을 바탕으로 썼고, 특정 기업·서비스의 공식 입장이 아닙니다. ‘예를 들어’로 든 한도 숫자는 설명을 위한 가상의 값이에요. NVIDIA의 1분 40번은 중계기 기록에 적어 둔 값이고, 각 서비스의 실제 한도는 서비스마다, 시기마다 다르니 쓰기 전에 그 서비스의 안내를 확인하세요.