이 글에는 제휴 링크가 없고 어떤 AI 서비스와도 관계가 없습니다. 제가 직접 만든 중계기의 개발 기록을 바탕으로 썼습니다. 삽화는 GPT 이미지 생성, 도식은 직접 제작했습니다.
한국어는 토큰을 더 먹는다 — 같은 짐도 포장 단위가 다르다 (LLM 중계기 개발기)
이사 견적을 받아 본 적 있으신가요? 이삿짐센터는 짐을 방 크기가 아니라 상자 수로 셉니다. 같은 크기의 방이라도 이불과 옷처럼 큰 상자 몇 개에 푹푹 담기는 짐이 있고, 그릇과 유리컵처럼 하나하나 싸서 작은 상자에 나눠 담아야 하는 짐이 있어요. 겉으로는 둘 다 ‘방 하나 분량’인데, 견적서의 상자 수는 몇 배씩 차이가 납니다.
트럭에 실을 수 있는 양이 상자 수로 정해져 있다면 이 차이는 더 중요해져요. “방 하나면 트럭 한 대로 충분했지”라는 기억만 믿고 그릇 방을 실으려다가는 짐이 트럭 밖으로 넘칩니다.
AI도 글을 상자로 셉니다. 그 상자를 토큰이라고 불러요. 그리고 한국어는 영어보다 같은 글자 수에서 상자가 훨씬 많이 나옵니다.
이 글은 LLM 중계기 개발기의 19편이자, 4부 ‘AI가 이상하게 굴 때’의 마지막 편입니다. 지난 18편 「에러 메시지를 자르지 마라」에서는 오류 문구가 잘려 원인이 사라졌던 일을 이야기했어요. 이번 편은 15편에서 언어에 따라 토큰 수가 달라지는 이야기는 19편에서 따로 하겠다며 미뤄 둔 바로 그 이야기예요.
결론 요약
- 현상 — AI는 글을 글자가 아니라 토큰으로 셉니다. 중계기 설명서에 적어 둔 어림값으로 영어는 약 3.0자에 1토큰, 한국어와 기호는 약 1.1자에 1토큰이에요. 같은 3,000자라도 한국어는 영어의 2.7배쯤 되는 토큰을 씁니다
- 데인 일 — 중계기를 쓰는 코드 검토 도구가 글자 수로 토큰을 어림해 한 번에 보낼 분량을 정했다가, ‘안전해 보이던’ 분량이 실제로는 두 배가 넘는 토큰이어서 AI가 읽을 수 있는 분량을 번번이 넘겼어요
- 규칙 — 긴 한국어 문서를 AI에 나눠 줄 때는 글자가 아니라 토큰으로 계획합니다. 한국어·코드는 1자를 1토큰으로 넉넉하게 세고, 답 예산과 여유를 먼저 빼고, 그래도 넘치면 오류에 적힌 숫자를 보고 줄여 다시 보내요
📦 1. 토큰을 다시 짚어 보면 — 같은 길이, 다른 상자 수
토큰(token)은 AI가 글을 세는 단위입니다. 15편에서 “AI가 쓰는 글의 양을 재는 자”라고 했었죠. 글자 하나가 늘 토큰 하나인 건 아니고, 낱말이나 낱말 조각 단위로 셉니다.
AI에게는 토큰으로 정해진 한도가 두 가지 있어요.
- 한 번에 읽을 수 있는 분량 — 흔히 컨텍스트 창이라고 부르는 것이에요. 질문과 자료를 이 안에 넣어야 하고, AI가 쓸 답 몫도 이 안에서 남겨 둬야 합니다. 9편에서 본 스펙 카드의 첫 줄이 이 값이에요
- 답 예산 — 답은 이만큼까지만 쓰라는 상한이에요. 15편에서 생각형 AI가 이 예산을 생각에 다 써 버린 이야기를 했죠
이사로 치면 컨텍스트 창은 트럭 짐칸이고, 토큰은 상자예요. 짐칸에 상자가 몇 개 들어가는지는 정해져 있습니다.
문제는 우리가 글을 잴 때 쓰는 자가 글자 수라는 점이에요. 문서 프로그램은 글자 수는 세어 주지만 토큰 수는 세어 주지 않으니까요. 그래서 글자 수를 토큰으로 바꾸는 어림이 필요한데, 이 어림이 언어와 내용에 따라 크게 달라집니다. 중계기 설명서에 적어 둔 값은 이래요.
- 영어 글 — 약 3.0자에 1토큰
- 한국어와 기호 — 약 1.1자에 1토큰
한국어는 거의 글자 하나가 토큰 하나인 셈이에요. 같은 3,000자를 셈해 보면 영어는 약 1,000토큰, 한국어는 약 2,700토큰입니다. 방 크기는 같은데 상자는 2.7배쯤 나오는 거죠.
왜 이렇게 다를까요? 흔히 AI가 글을 토큰으로 자르는 방식이 영어 글을 많이 보며 만들어져서, 자주 쓰이는 영어 낱말은 통째로 한 조각이 되고 한국어는 더 잘게 쪼개지는 경우가 많다고 설명합니다. 코드도 비슷해요. 괄호, 점, 등호, 줄 앞의 빈칸 같은 기호가 촘촘해서 낱말처럼 묶이기보다 하나하나 조각이 되기 쉽죠. 중계기 설명서도 코드를 한국어와 같은 쪽으로 묶어 두었어요.
다만 이 숫자들은 어림값이에요. AI마다, 글마다 달라서 설명서에도 “정확한 토큰은 내용마다 달라 100% 미리 맞힐 수 없다”고 적어 두었습니다. 그래도 방향은 분명해요. 같은 글자 수라면 한국어와 코드는 영어보다 훨씬 무겁습니다.
🔥 2. 여기서 크게 데였다 — ‘안전해 보이던’ 글자 예산
중계기를 처음 만든 날 저녁, 중계기에 다른 프로그램을 붙이려는 사람을 위한 연결 설명서를 처음 썼어요. 중계기가 켜져 있는지 확인하는 법, 모델을 고르는 법 같은 절이 차례로 이어지는데, 여섯 번째 절의 제목에만 경고 표시가 붙어 있습니다.
컨텍스트 한도 처리 — 여기서 우리가 크게 데였습니다
이 절은 중계기를 쓰는 코드 검토 도구가 먼저 겪은 일을 적은 거예요. 이 도구는 코드와 한국어가 섞인 글을 AI에게 보내야 했고, 한 번에 보낼 분량을 정해야 했어요. AI가 한 번에 읽을 수 있는 분량을 넘기면 요청이 통째로 거절되니까요.
그래서 글자 수로 토큰을 어림해 분량을 정했습니다. 그런데 이 어림이 한국어와 코드에서 크게 빗나갔어요. 설명서의 표현을 그대로 옮기면, “안전해 보이는” 글자 예산이 실제로는 두 배가 넘는 토큰이어서 매번 넘쳤습니다.
이사로 치면 이래요. 이불 방을 옮기던 경험으로 “방 하나면 트럭 한 대”라고 견적을 잡았는데, 실제로 실은 건 그릇 방이었던 거예요. 견적서는 안전해 보였지만 상자는 두 배 넘게 나왔고, 트럭은 매번 넘쳤습니다.
넘치면 AI는 요청을 읽지 않고 “읽을 수 있는 분량을 넘었다”는 오류로 돌려보내요. 이때 오류 문구에는 숫자 두 개가 적혀 옵니다. 설명서에 예로 적어 둔 문구들도 모두 그랬어요.
- AI가 한 번에 읽을 수 있는 한도
- 이번 요청의 입력 토큰 수
중계기는 이 오류를 쓰는 쪽에 전할 때 원래 문구를 그대로 실어 보냅니다. 18편에서 오류 문구를 자르지 말아야 한다고 했죠. 이 두 숫자도 그 문구 안에 들어 있어요. 4절에서 보겠지만, 이 숫자가 마지막 안전망이 됩니다.
⚖️ 3. 같은 가방, 다른 무게 — 영어·한국어·코드
설명서의 어림값으로 글 3,000자를 세 가지 가방에 담아 보면 차이가 한눈에 보여요.
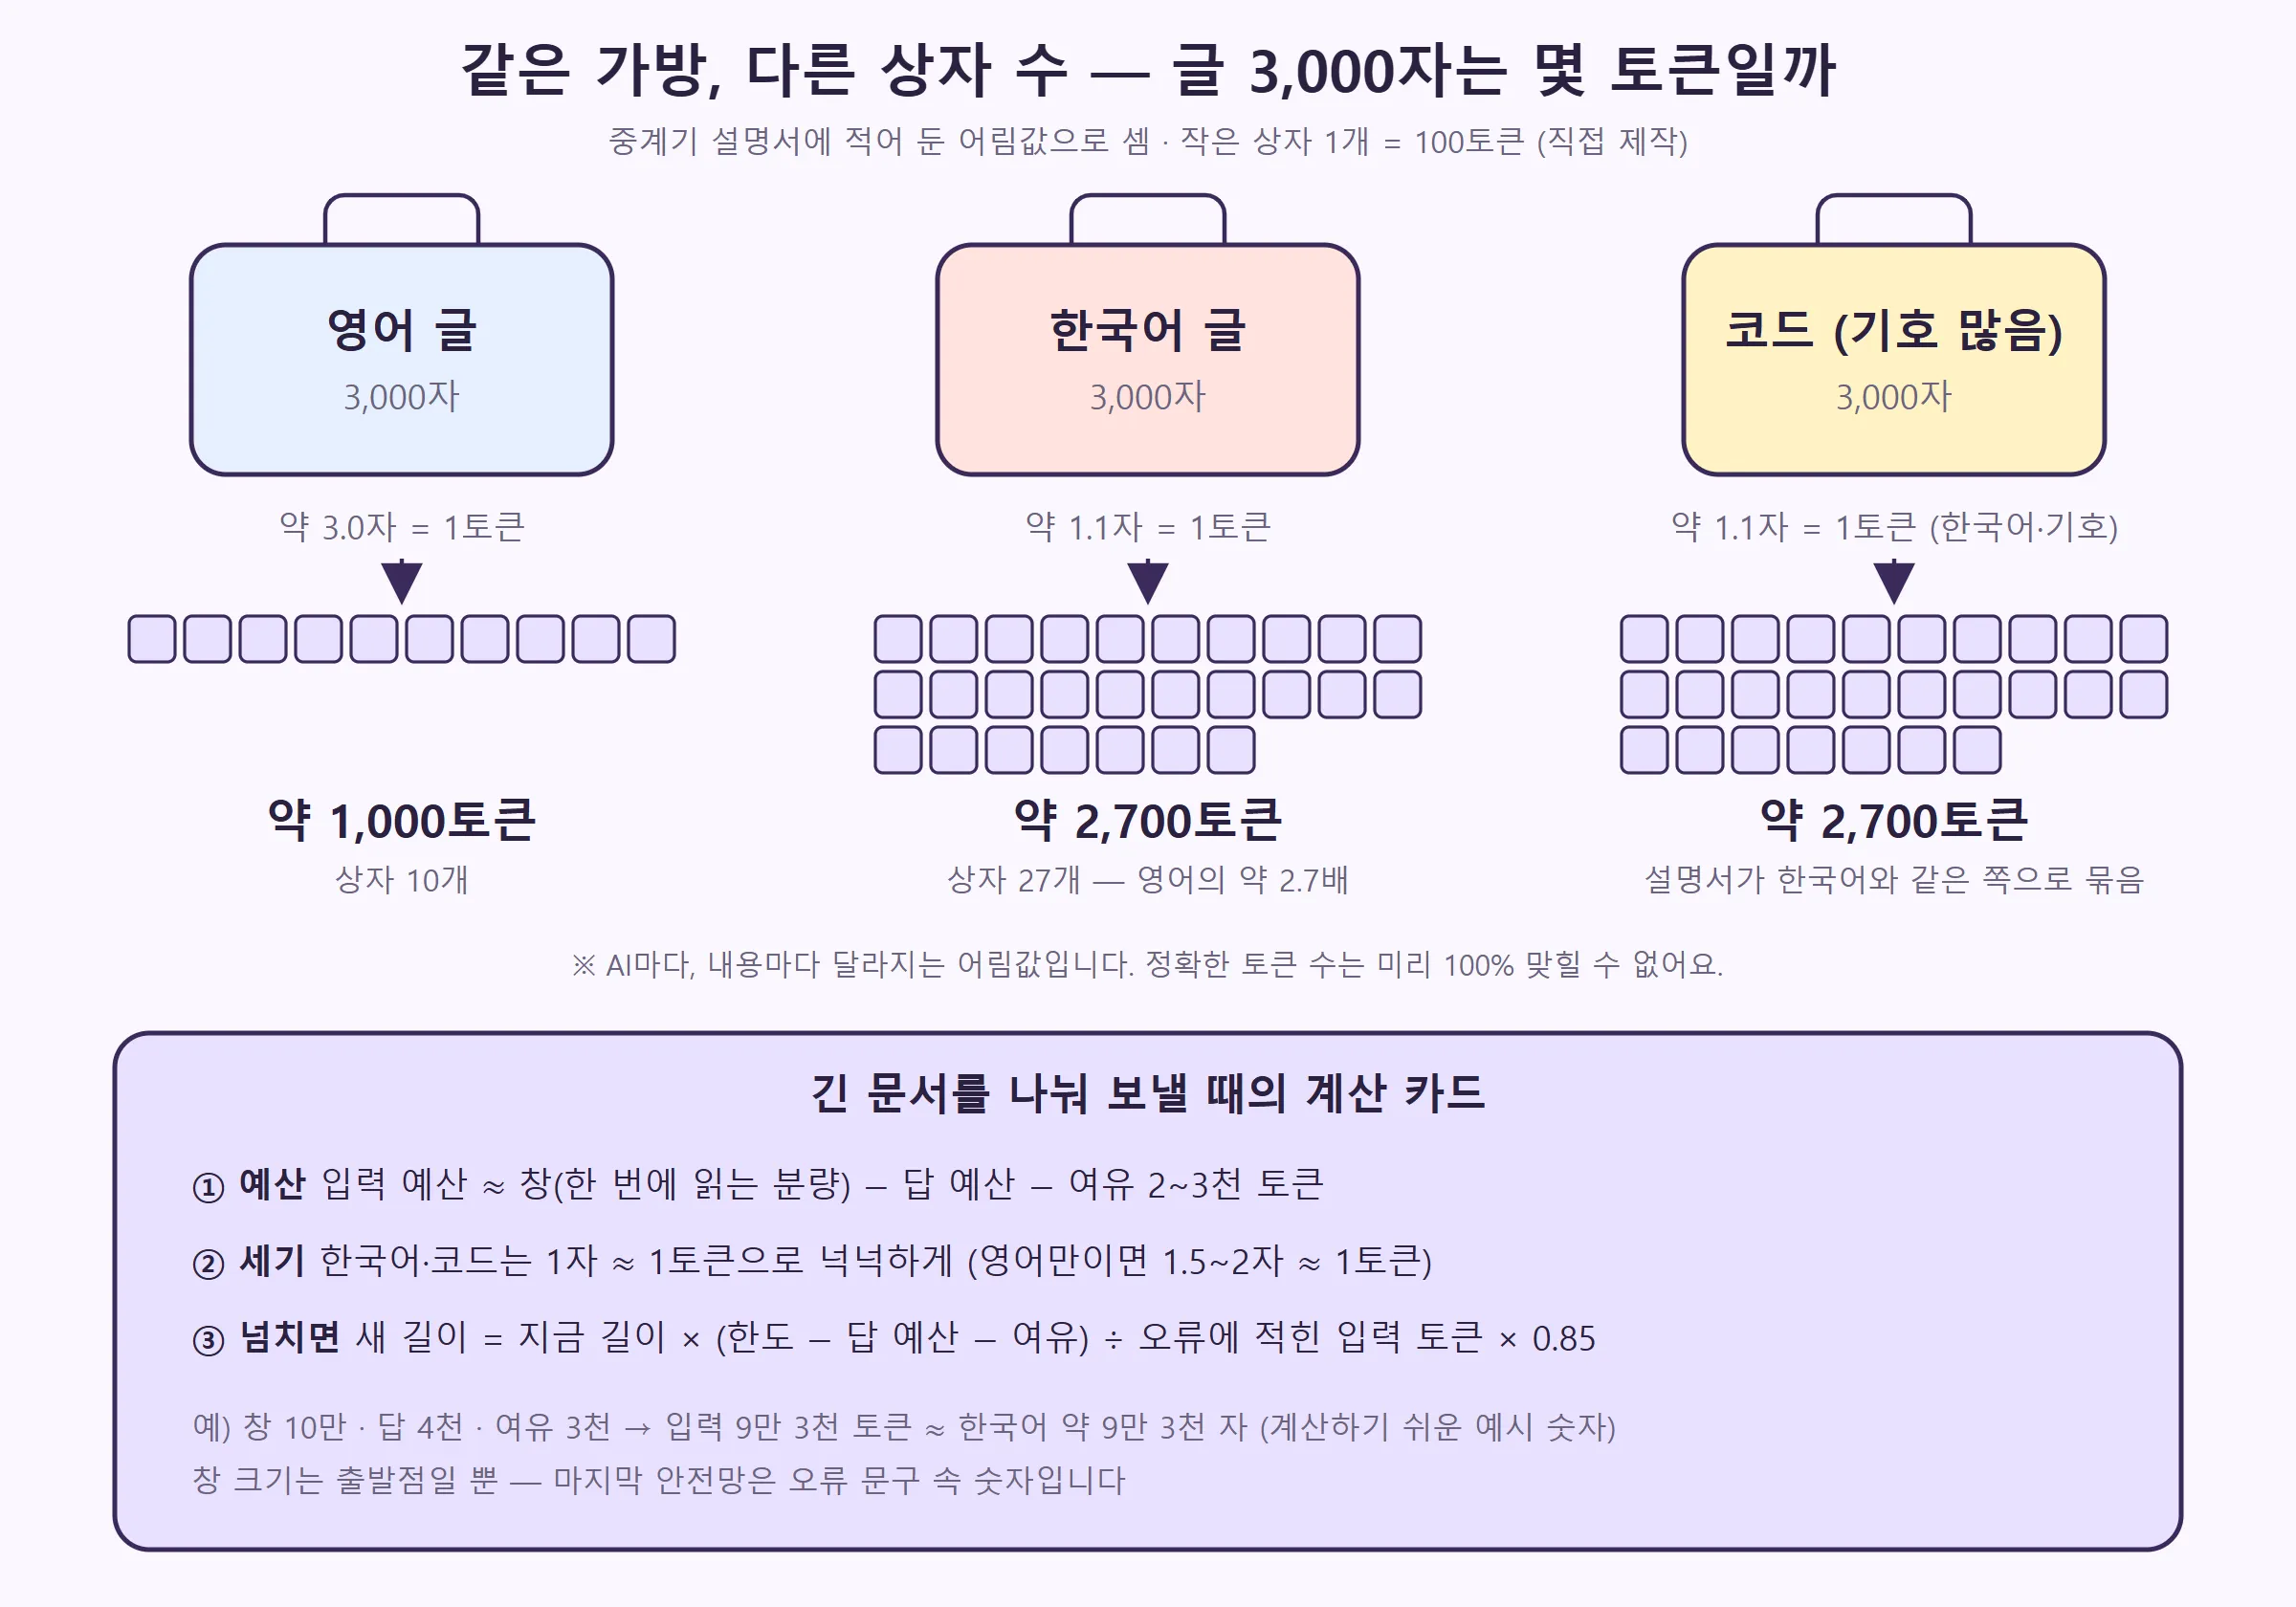
영어 기준으로 “이 정도면 넉넉하다”고 잡은 글자 수를 한국어에 그대로 쓰면, 셈으로는 토큰이 2.7배쯤 나와요. 설명서에 적힌 “두 배가 넘는 토큰”이라는 말과 맞아떨어지는 숫자입니다.
15편의 숫자도 이 눈으로 다시 볼 수 있어요. 그날 생각형 AI가 생각에 쓴 글은 33,748자에 8,192토큰이었습니다. 토큰 하나에 4.1자쯤이니, 설명서의 영어 값(3.0자)보다도 가벼운 글이었던 셈이에요. 같은 33,748자가 한국어였다면 설명서 값으로 약 3만 700토큰, 3.7배쯤이 됩니다.
그러니 ‘토큰 하나에 몇 글자’는 AI가 정해 둔 고정값이 아니에요. 어떤 글이냐에 따라 달라지는 값입니다. 같은 가방이라도 무엇을 담았느냐에 따라 무게가 다르듯이요.
✂️ 4. 해법 세 단계 — 토큰으로 세고, 넉넉히 잡고, 넘치면 숫자 보고 줄인다
설명서에는 함정 바로 아래에 해법이 세 단계로 적혀 있어요.
① 1차 예산 — 짐칸에서 거꾸로 계산한다
먼저 AI가 한 번에 읽을 수 있는 분량에서 거꾸로 셈합니다.
입력 예산 ≈ 한 번에 읽을 수 있는 분량 − 답 예산 − 여유(2~3천 토큰)
답 몫과 여유분을 먼저 떼어 두고 남은 자리에만 자료를 싣는 거예요. 한 번에 읽을 수 있는 분량은 중계기가 모델 목록과 스펙 카드에 알려 줍니다. 아는 모델에 대해서만요.
② 넉넉하게 센다 — 한국어·코드는 1자를 1토큰으로
설명서는 일부러 많이 세라고 적었어요. 글자 수를 토큰으로 바꿀 때 1자를 1토큰으로 보라는 거예요. 그래야 예산이 모자랄 일이 없다고요. 영어만 있는 글이라면 1.5~2자에 1토큰까지는 올려도 된다고 했습니다.
한국어 어림값(1.1자)보다도 조금 더 무겁게 세는 셈이라, 상자를 조금 덜 싣게 됩니다. 대신 트럭이 넘치지는 않아요. 적게 세면 실패하고, 넉넉하게 세면 조금 덜 담을 뿐이니까요.
③ 그래도 넘치면 — 오류 속 숫자로 줄여서 다시 보낸다
그래도 넘칠 수 있어요. 어림은 어림이니까요. 그때는 2절의 오류 문구에서 한도와 입력 토큰 수를 읽어, 넘친 비율만큼 글을 줄여 다시 보냅니다. 설명서의 셈은 이래요.
새 길이 = 지금 길이 × (한도 − 답 예산 − 여유) ÷ 오류에 적힌 입력 토큰 × 0.85
마지막의 0.85는 넘친 만큼만 줄이지 않고 15%를 더 덜어 내는 여유예요. 줄인 비율도 어림이라 딱 맞춰 줄이면 또 넘칠 수 있거든요.
계산하기 쉬운 예시 숫자로 세 단계를 한 번에 따라가 볼게요.
- 한 번에 10만 토큰을 읽는 AI에 답 예산 4천, 여유 3천을 남기면 입력 예산은 9만 3천 토큰이에요
- 한국어를 1자 1토큰으로 세면 한 번에 약 9만 3천 자까지 보냅니다
- 만약 영어 셈(3.0자)을 그대로 썼다면 27만 9천 자까지 괜찮다고 착각했을 거예요. 한국어 27만 9천 자는 설명서 값으로 약 25만 토큰이라 짐칸의 2.5배입니다
- 그래도 넘쳐서 오류에 ‘입력 12만 토큰’이 찍혀 왔다면, 9만 3천 ÷ 12만 × 0.85 ≈ 0.66이니 지금 길이의 66%쯤으로 줄여 다시 보내요
설명서는 이 절을 이렇게 맺어요. 한 번에 읽을 수 있는 분량은 힌트일 뿐이고, 정확한 토큰은 내용마다 달라 미리 다 맞힐 수 없으니 오류에 기댄 세 번째 단계가 최종 안전망이라고요. 9편에서 스펙 카드의 분량 줄을 ‘출발점’이라고 부른 것도 같은 뜻이었습니다.
이 규칙은 그 뒤에도 따라다녔어요. 8월 12일에는 중계기에 붙을 프로그램을 AI 코딩 도구로 만들 때 그대로 건네는 안내문을 중계기 화면에 넣었는데, “실제 사고에서 나온 규칙”이라고 이름 붙인 목록에 이 줄이 들어갔습니다. 한국어·코드는 1자를 1토큰으로 많이 세고, 영어만 있을 때만 1.5~2자에 1토큰으로 세라는 줄이요.
📏 5. 중계기 안에도 자가 세 개 있다
중계기 자신도 곳곳에서 글자 수로 토큰을 어림합니다. 그런데 자가 하나가 아니에요. 이 연재에서 이미 세 번 만났습니다.
- 4글자 = 1토큰 — 12편의 페이서가 1분 토큰 한도를 지키려고 쓰는 장부의 자예요. 코드 메모에는 “실제 토큰 세는 방식과는 상관없는 대략적인 셈이지만 안전장치로는 충분하다”는 뜻으로 적혀 있어요. 영어 기준의 대략적인 셈이라 한국어에서는 빗나갈 수 있다고 12편에서 말씀드렸죠
- 3글자 = 1토큰 — 15편에서 생각형 AI가 생각에 쓴 분량을 어림하는 자예요. 그날 실제로 본 생각 글(토큰 하나에 4.1자)보다 일부러 무겁게 잡았습니다. 코드 메모는 “과소보다 과대가 안전하다”예요
- 한국어 1글자 = 1토큰 — 16편에서 끝난 이유를 알려 주지 않는 AI의 답이 잘렸는지 재는 자예요. 7월 21일에 넣었는데, 코드 메모가 이 편의 이야기를 그대로 담고 있어요. “4글자 = 1토큰 셈은 한국어를 크게 적게 센다, 한국어는 글자당 1토큰 이상”이라고요. 그래서 한국어 같은 글자는 1글자를 1토큰으로, 나머지는 4글자를 1토큰으로 셉니다
같은 중계기 안에서 자가 셋인 건 용도도 다르고 그 자를 맞춘 글도 달라서예요. 그래도 고르는 기준은 하나로 모입니다. 적게 세면 사고가 나는 자리에서는 무겁게 센다. 잘림 감지에서 적게 세면 잘린 답을 멀쩡한 답으로 놓치고, 생각 여유분을 적게 세면 15편처럼 답이 비어 버리니까요.
🗂️ 6. 긴 한국어 문서를 AI에 나눠 줄 때
중계기를 쓰지 않더라도, 긴 한국어 문서를 AI에게 읽히려는 분이라면 같은 함정을 만날 수 있어요. 설명서의 해법을 읽는 분 쪽으로 옮기면 이렇습니다.
① 글자가 아니라 토큰으로 계획한다 — 한국어와 코드는 1자를 1토큰으로 넉넉하게 세요. 영어만 있는 글이라면 1.5~2자에 1토큰까지 봐도 됩니다
② 여유를 남긴다 — 한 번에 읽을 수 있는 분량에서 답 예산과 2~3천 토큰을 먼저 빼고 남은 만큼만 자료를 넣어요. 생각형 AI라면 15편에서 본 생각 여유분도 함께 빼야 합니다
③ 모델의 스펙부터 본다 — 한 번에 읽는 분량과 권장 방식을 먼저 확인해요. 중계기라면 스펙 카드, 아니라면 그 AI 서비스가 밝힌 공식 스펙이요. 스펙을 모르면 9편의 도구처럼 작게 나눠 차례로 보내는 게 안전합니다
④ 넘치면 숫자를 보고 줄인다 — 오류 문구에 적힌 한도와 입력 토큰 수로 비율을 셈해서 줄이고, 거기서 조금 더 덜어 내요. 그러려면 오류 문구를 자르지 말고 끝까지 남겨야 하고요
채팅창에 직접 긴 문서를 붙여 넣는 경우에도 셈은 같아요. 서비스가 “한 번에 몇 토큰까지”라고 안내한다면, 한국어 문서는 그 숫자만큼의 글자를 넘지 않게, 답이 들어갈 자리는 따로 남겨 두고 잡는 편이 넉넉합니다.
정리
① AI는 글을 토큰으로 셉니다. 중계기 설명서의 어림값으로 영어는 약 3.0자, 한국어와 기호는 약 1.1자에 1토큰이라, 같은 글자 수라도 한국어와 코드는 2.7배쯤 많은 토큰을 써요 ② 글자 수로 잡은 ‘안전해 보이던’ 분량이 실제로는 두 배 넘는 토큰이어서 번번이 넘친 일이, 중계기 첫날 설명서에 “여기서 우리가 크게 데였습니다”로 남았어요 ③ 그래서 한 번에 읽는 분량에서 답 예산과 여유를 빼고, 한국어·코드는 1자를 1토큰으로 넉넉하게 세고, 넘치면 오류 속 숫자로 줄여 다시 보냅니다. 분량 정보는 출발점이고, 마지막 안전망은 오류 문구 속 숫자예요
이번 편으로 4부 ‘AI가 이상하게 굴 때’를 마칩니다. 다음 20편부터는 5부 ‘만들고 나서가 더 어렵다’가 시작돼요. 첫 이야기는 “맥에서 되는데 윈도에서 안 되는 이유”입니다. 만든 컴퓨터에서는 멀쩡하던 중계기가 다른 컴퓨터에서 멈춘 이야기예요.
2026년 10월 1일 기준입니다. 제가 만든 중계기의 개발 기록을 바탕으로 썼고, 특정 기업·서비스의 공식 입장이 아닙니다.