이 글에는 제휴 링크가 없고 OpenAI·앤트로픽과 아무 관계가 없습니다. 제가 직접 만든 중계기와 그 위에서 돌아가는 도구의 개발 기록을 바탕으로 썼습니다. 삽화는 GPT 이미지 생성, 도식은 직접 제작했습니다.
지식을 넣었더니 지적이 사라졌다 — 참고서를 줬더니 답안이 짧아졌다 (LLM 중계기 개발기)
시험을 앞둔 학생에게 참고서를 몇 권 더 챙겨 줬다고 해 볼게요. 많이 볼수록 잘 풀겠지 싶었어요. 그런데 다음 날 받아 온 답안지가 오히려 짧아졌어요. 아는 걸 더 쓰기는커녕, 쓰던 답마저 비워 두고 왔어요.
말이 안 되는 것 같지만, AI에게 이와 비슷한 일이 실제로 일어났어요. 코드를 검토하는 AI에게 프로젝트에 대한 지식을 더 넣어 줬더니, 원래 찾아내던 문제조차 말하지 않게 된 거예요. 오늘은 “많이 알려 줄수록 잘하겠지”라는 믿음을 숫자로 재 본 이야기를 합니다.
이 글은 LLM 중계기 개발기의 28편입니다. 지난 27편 「AI끼리 코드리뷰 대결」에서는 코드 리뷰 대결 도구가 바뀐 코드를 조각과 관점으로 나눠 여러 AI에게 맡기고, 심판 AI가 그 지적들을 검증해 하나로 합치는 이야기를 했어요. 오늘은 그 도구를 다듬다가 해 본 실험, 그리고 그 실험이 남긴 규칙 이야기예요.
결론 요약
- 믿음 — AI 리뷰어에게 프로젝트 지식을 더 넣어 주면 문제를 더 잘 찾을 거라고 봤어요. 그래서 관련 지식 카드를 골라 넣는 기능까지 만들었어요
- 측정 — 같은 코드 변경, 같은 AI로 넣어 주는 자료만 바꿔 봤더니, 지식 카드를 넣은 구성은 심판이 인정한 지적이 3건에서 0건이 됐어요. 틀린 지적이 늘어난 게 아니라 AI가 입을 다물었어요. 주변 코드는 입력만 늘리고 결과는 그대로였고요
- 규칙 — 지식이 가장 필요해 보이는 관점 하나에만 좁혀 넣어도 손해였어요. 그래서 지식 넣기는 기본으로 끄고, 좋아진다는 걸 증명하기 전엔 넣지 않는다는 규칙을 남겼어요
📚 1. AI에게 ‘지식을 넣어 준다’는 것
AI는 기본적으로 학습할 때 익힌 일반 지식과, 이번에 함께 받은 글을 보고 답해요. 이 프로젝트에서 지켜 온 관례나 지난주에 있었던 사고 같은 건 알려 주지 않으면 몰라요. 그래서 알려 주고 싶은 것이 있으면 질문 앞에 참고 자료를 붙여 같이 보내요.
개발자들은 이걸 컨텍스트 주입이라고 불러요. 컨텍스트(context)는 ‘앞뒤 사정’이라는 뜻이에요. 시험지에 참고 자료를 함께 끼워 주는 셈이죠.
코드 리뷰 대결 도구가 리뷰하는 AI에게 넣어 줄 수 있던 자료는 이랬어요.
- 바뀐 내용(diff) — 리뷰의 원래 대상이에요. 코드가 고치기 전과 후에 어떻게 달라졌는지 줄 단위로 보여 주는 글이에요
- 프로젝트 지식 카드 — 이 프로젝트의 관례나 과거 사고 기록을 한 장에 하나씩 정리한 카드예요. 카드마다 어떤 파일에 해당하는지 적어 두고, 이번에 바뀐 파일과 맞는 카드를 골라 넣어요. 많아야 다섯 장, 4,000자 안으로 넣게 되어 있었어요
- 주변 코드 — 바뀐 줄 앞뒤에 원래 있던 코드예요. 바뀐 부분만 봐서는 놓치는 맥락을 채워 주려는 거예요
- 변경 목적 — 이 변경이 무엇을 하려는 건지 적은 설명이에요
지식 카드 기능은 7월 11일에 들어갔어요. 넣으면 좋아질 거라고 보고 만든 기능이었죠. 그리고 그날 자정을 막 넘긴 7월 12일 0시 무렵, 정말 좋아지는지 재 보는 실험 도구가 들어갔어요. 실험 도구 맨 위에는 영어로 짧은 메모가 적혀 있어요. 우리말로 옮기면 “무엇이 도움이 되는지는 가정하지 말고 재야 한다”예요.
이 실험은 사실 중계기보다 하루 먼저예요. 중계기의 첫 저장은 7월 13일이었거든요(4편). 그래도 이 이야기를 중계기 개발기에 넣는 건, 이때 정한 규칙이 중계기 위에서 돌아가는 리뷰에도 그대로 이어졌고, 중계기 저장소의 정리 문서에도 한 장으로 남아 있기 때문이에요.
🧪 2. 실험은 이렇게 — 같은 시험지, 같은 학생, 다른 참고서
방법은 A/B 실험이에요. 두 가지를 나란히 놓고 딱 하나만 다르게 해서 비교하는 방법이에요. 여러 조건이 한꺼번에 바뀌면 무엇 때문에 결과가 달라졌는지 알 수 없으니까요.
- 같은 시험지 — 실제로 쓰이던 코드의 변경 하나
- 같은 학생 — Codex 계열의 빠른 모델 하나
- 바꾼 것 — 넣어 준 자료뿐
정답셋 — 채점표부터 만든다
돌려 보고 “지적이 많네, 좋다”라고 하면 안 돼요. 그래서 채점 기준을 먼저 정했어요. 이 변경 안에 들어 있는 것으로 미리 확인해 둔 결함 세 개를 정답셋으로 삼았어요.
① 널 역참조 — 비어 있을 수 있는 값을 확인하지 않고 꺼내 쓰는 문제예요. 빈 상자인 줄 모르고 물건을 꺼내려다 손이 허공을 짚는 것과 같아요 ② 리소스 잔류 — 작업이 실패했을 때, 잠깐 쓰려고 만든 것이 치워지지 않고 남는 문제예요 ③ 메모리 누수 — 다 쓴 자원을 돌려주지 않아 메모리가 조금씩 새는 문제예요
AI가 짚은 위치가 정답 결함이 있는 파일과 줄 범위 안에 들어오면 ‘적중’으로 쳤어요. 세 개 중 몇 개를 짚었는지가 정답 적중이에요.
심판이 인정한 지적만 센다
지적의 개수도 그대로 세지 않았어요. AI 리뷰어는 가끔 틀린 지적을 해요. 개발자들은 이걸 오탐(잘못 울린 경보)이라고 불러요. 문제가 아닌 걸 문제라고 하면 사람이 확인하느라 시간만 쓰죠. 지적 수만 세면 아무 말이나 많이 하는 리뷰어가 이기게 돼요.
그래서 리뷰가 끝날 때마다 27편에서 본 심판 AI에게 지적 하나하나를 다시 확인하게 했어요. 심판이 반박한 지적을 뺀 나머지만 유효 지적으로 셌어요.
한계도 함께 적어 둔다
구성마다 한 번씩만 돌렸어요. AI는 같은 질문에도 매번 조금씩 다르게 답할 수 있어서, 한 번의 결과로 우열을 확정할 수는 없어요. 기록에도 “방향 신호로 해석, 반복 확대로 확정 예정”이라고 적어 두었어요. 아래 숫자도 그 정도 무게로 읽어 주세요.
🤐 3. 결과 ① — 지식을 넣자 AI가 입을 다물었다
넣어 준 자료를 네 가지로 바꿔 가며 돌린 결과예요.
| 넣어 준 자료 | 유효 지적 | 정답 적중 |
|---|---|---|
| 바뀐 내용만 | 3 | 1/3 |
| + 프로젝트 지식 카드 | 0 | 0/3 |
| + 주변 코드 | 3 | 1/3 |
| 전부 넣기 (지식 카드·주변 코드·변경 목적) | 0 | 0/3 |
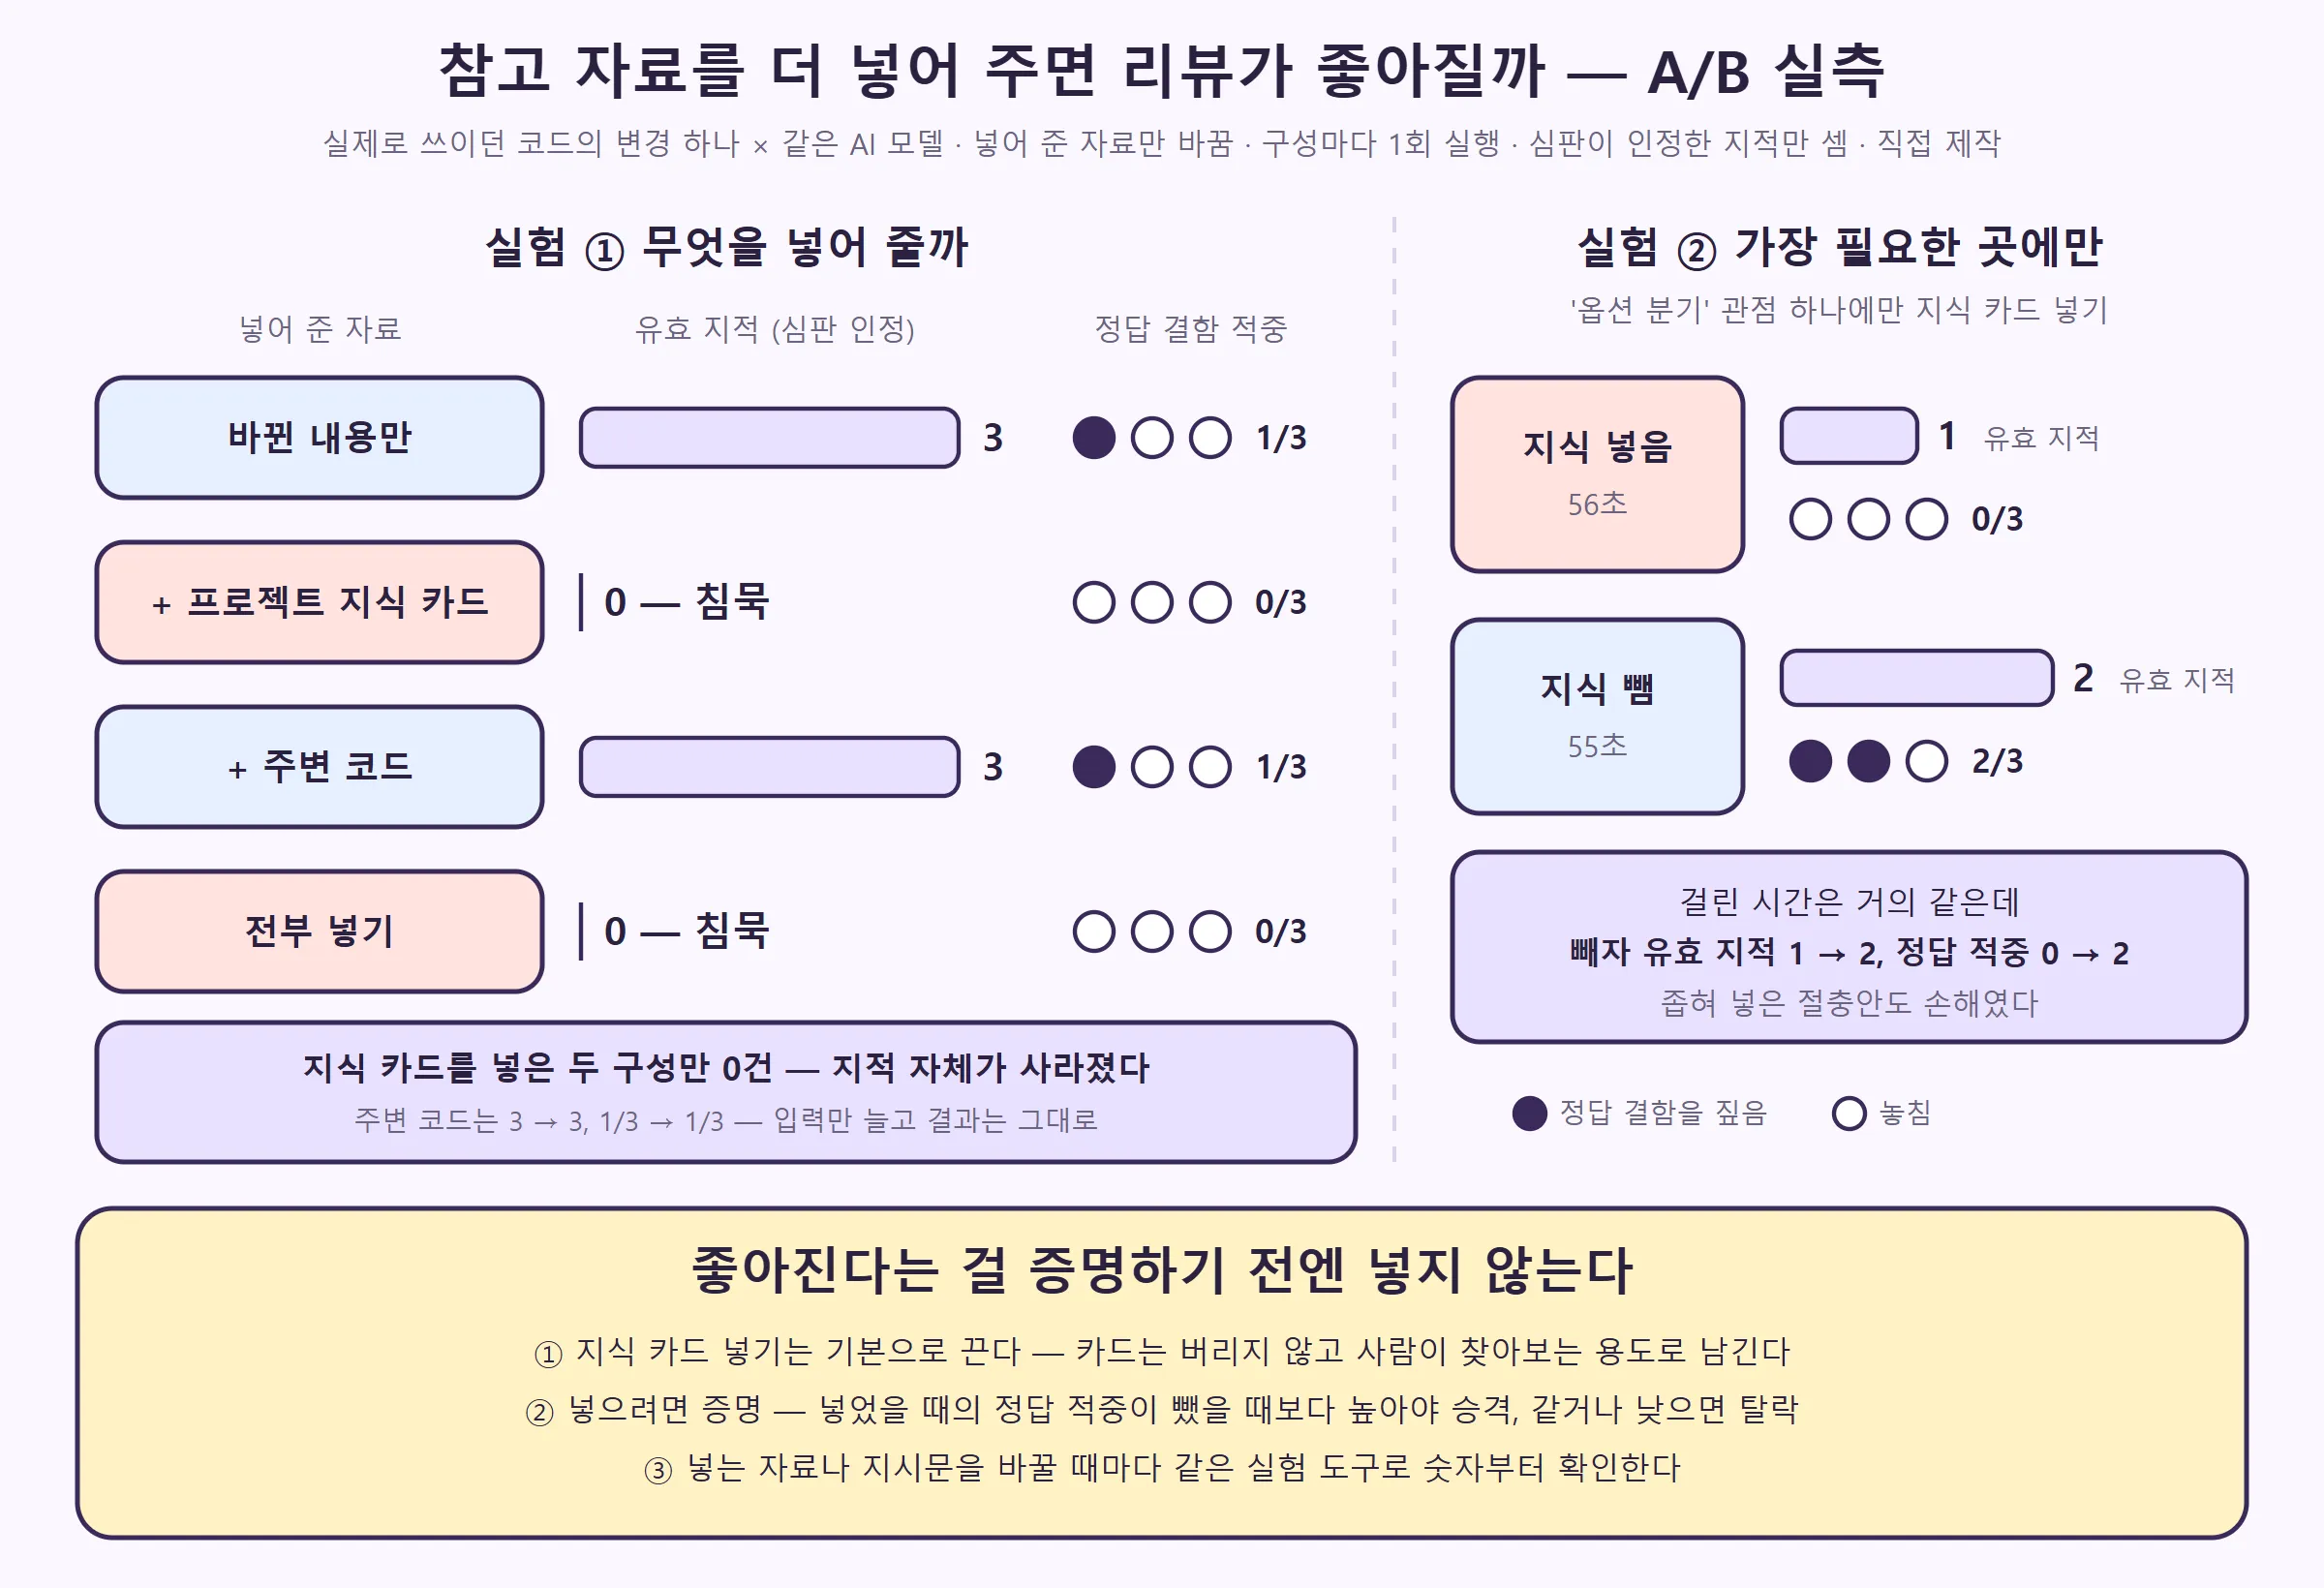
0이 나온 두 줄에는 공통점이 있어요. 둘 다 지식 카드가 들어간 구성이에요.
더 눈여겨볼 건 0의 내용이에요. 틀린 지적이 잔뜩 나와서 심판에게 전부 걸러진 게 아니에요. 기록의 표현을 그대로 옮기면 “오탐이 늘어난 것이 아니라 모델이 침묵한다”예요. 지적 자체를 내놓지 않은 거예요. 참고서를 받은 학생이 답안을 비워 두고 온 것처럼요.
생각해 보면 침묵은 틀린 지적보다 알아채기 어려워요. 틀린 지적은 사람이 읽다가 “이건 아닌데” 하고 걸러 낼 수 있어요. 그런데 지적이 0건이면 화면에는 “문제 없음”처럼 보여요. 정답셋을 쥐고 채점하지 않았다면, 지식을 넣은 리뷰가 오히려 깔끔한 리뷰로 보였을지도 몰라요.
주변 코드는 3건에서 3건, 1/3에서 1/3이었어요. 나빠지지는 않았지만 나아지지도 않았어요. 입력이 길어진 만큼 AI가 읽어야 할 분량만 늘었으니, 기록의 말대로 “비용만 늘고 이득이 없다”였어요.
🎯 4. 결과 ② — 가장 필요한 곳에만 넣어도
여기서 자연스러운 반론이 나와요. “모든 리뷰에 지식을 다 넣어서 그런 것 아닐까? 정말 필요한 곳에만 넣으면 다르지 않을까?”
27편에서 본 것처럼 코드 리뷰 대결 도구는 리뷰를 관점별로 나눠 맡겨요. 그중 옵션 분기 관점은 설정값이나 스위치에 따라 프로그램이 다르게 움직이는 곳을 살펴요. 어떤 설정이 어디서 갈리는지는 바뀐 코드만 봐서는 알기 어려워서, 이 관점은 처음부터 “제공된 프로젝트 지식을 적극 활용하라”는 지시를 받고 있었어요. 지식 카드의 단골손님이었던 셈이에요.
그래서 이 관점 하나만 놓고, 지식 카드를 넣은 판과 뺀 판을 비교했어요.
| 옵션 분기 관점 | 유효 지적 | 정답 적중 | 걸린 시간 |
|---|---|---|---|
| 지식 넣음 | 1 | 0/3 | 56초 |
| 지식 뺌 | 2 | 2/3 | 55초 |
걸린 시간은 거의 같았어요. 그런데 카드를 빼자 유효 지적은 1건에서 2건으로 늘고, 정답 적중은 0개에서 2개가 됐어요. 좁혀 넣는 절충안도 손해였던 거예요. 기록은 이걸 “절충안(‘관점 한정 주입’)조차 유해”라고 적었어요.
🔍 5. 왜 조용해졌을까 — 기록은 ‘추정’까지만
먼저 솔직하게 말할게요. 이 실험은 무엇이 나빠졌는지는 보여 줬지만 왜 나빠졌는지는 증명하지 못했어요. 기록도 원인에 대해서는 “추정한다”고만 적었어요. 기록에 남은 추정은 두 가지예요.
① 묽어진다 — 입력이 길어지면 정작 봐야 할 바뀐 코드에 대한 집중이 묽어진다는 설명이에요. 흔히 ‘컨텍스트 희석’이라고 불러요. 공개 연구 중에도 비슷한 방향의 보고가 있어요. 2025년 EMNLP Findings에 실린 「Context Length Alone Hurts LLM Performance Despite Perfect Retrieval」은 필요한 정보를 정확히 찾아 넣어 줘도 입력이 길어지는 것만으로 성능이 떨어질 수 있다고 보고했어요. 실험 도구 맨 위의 메모도 이 연구를 근거로 들고 있어요. 다만 이번 실험에서 주변 코드도 입력을 늘렸는데 결과가 그대로였던 걸 보면, 길이 하나만으로 다 설명되는지는 확실하지 않아요.
② 몸을 사린다 — 카드가 가리키는 파일에서 AI가 보수적으로 변했다는 추정이에요. 실제로 그때 카드 저장소에 있던 카드 가운데 하나는, 정답 결함 세 개 중 두 개가 들어 있던 바로 그 파일을 적용 대상으로 적어 둔 카드였어요. 기록에는 “넣은 카드가 바로 그 카드에 맞는 파일에서 지적을 누른다”는 뜻의 영어 문장도 남아 있어요.
사람에 빗대 흔히 이렇게 설명하기도 해요. 참고서에 “이 부분은 이렇게 처리돼 있다”는 설명이 있으면, 학생은 그 부분을 다시 의심하기보다 “참고서가 그렇다니 괜찮겠지” 하고 넘어가기 쉽다는 거예요. 또 카드를 넣을 때는 “카드는 배경일 뿐이고 코드가 우선이다, 카드만 근거로 지적하지 마라”라는 조심 문구가 함께 들어갔어요. 이런 문구가 AI를 더 조심스럽게 만들었을 가능성도 떠올려 볼 수 있어요. 하지만 둘 다 따로 재 보지 않은 이야기예요.
그래도 결정은 할 수 있었어요. 왜는 몰라도 넣으면 나빠진다는 숫자는 손에 있었으니까요.
📏 6. 남긴 규칙 — 증명하기 전엔 넣지 않는다
실험 도구를 저장하고 40분이 채 안 돼, 지식 넣기를 기본으로 끄는 변경이 저장됐어요. 그 저장 기록의 제목은 “Knowledge injection off by default — the A/B numbers say so”, 우리말로 옮기면 “지식 주입은 기본 끔 — A/B 숫자가 그렇게 말한다”예요. 그때 정한 원칙은 네 가지예요.
- 기본은 끈다 — 모든 관점에서 지식 카드를 넣지 않아요. 카드를 버린 건 아니에요. 카드 저장소와 검색은 그대로 두고, 사람이 찾아보는 용도로 남겼어요
- 넣으려면 증명한다 — 어떤 카드를 다시 넣으려면, 그 카드에 맞는 코드 변경으로 A/B를 돌려 ‘넣었을 때’의 정답 적중이 ‘뺐을 때’보다 높다는 걸 보여야 해요. 같거나 낮으면 탈락이에요. 결과 표는 기록에 남겨요. 이 설명은 설정 스위치 바로 옆에도 적어 두었어요. 누가 감으로 다시 켜는 일이 없게요
- 일반론은 빼고 기계에 맡긴다 — “빈 값인지 꼭 확인하라” 같은 일반적인 리뷰 규칙 문구도 지시문에서 뺐어요. 이런 일반론이 그 제품만의 관점을 밀어낸다고 봤기 때문이에요. 이런 규칙은 같은 입력이면 늘 같은 결과를 내는 결정적 검사, 예를 들어 코드 규칙 검사기가 맡는 게 낫다고 정리했어요
- 실험 도구는 늘 곁에 — 이후로는 넣는 자료나 지시문을 바꿀 때마다 숫자로 먼저 확인하고 반영해요. 나중에 관점 지시 없이 자유롭게 살펴보는 ‘자유 시점’ 관점을 더할 때도 A/B 결과를 보고 넣었어요
지금도 코드 리뷰 대결 도구의 지식 넣기 스위치는 기본값이 ‘끔’이에요.
이 실험은 코드 변경 하나에서 구성마다 한 번씩 잰 결과라, “지식을 넣으면 언제나 나빠진다”는 법칙은 아니에요. 다른 코드, 다른 AI, 더 잘 다듬은 카드에서는 다르게 나올 수 있어요. 그래서 규칙도 “넣지 마라”가 아니라 “증명하고 넣어라”예요.
다만 AI에게 자료를 잔뜩 붙여 넣기 전에, 넣은 판과 안 넣은 판을 한 번쯤 나란히 비교해 보는 습관은 누구에게나 쓸모 있을 거예요. 26편의 병렬 채팅처럼, 나란히 놓아야 보이는 것이 있으니까요.
정리
① 같은 코드 변경, 같은 AI로 넣어 주는 자료만 바꿔 재 보니, 프로젝트 지식 카드를 넣은 구성은 심판이 인정한 지적이 3건에서 0건이 됐어요. 틀린 지적이 는 게 아니라 AI가 입을 다물었어요 ② 주변 코드는 입력만 늘리고 결과는 그대로였어요. 지식이 가장 필요해 보이는 관점 하나에만 좁혀 넣어도 유효 지적 1 대 2, 정답 적중 0 대 2로 손해였어요 ③ 원인은 추정으로만 남았지만 결정은 숫자로 했어요. 지식 넣기는 기본으로 끄고, 좋아진다는 걸 증명하기 전엔 넣지 않는다는 규칙을 남겼어요
다음 29편은 「생각하지 않고 고르기만 하는 창구」예요. AI에게 긴 글 대신 정해진 보기 중 하나만 고르게 하는 중계기의 판정 창구, 그리고 객관식 문제에 서술형 답을 쓰던 학생처럼 느렸던 그 창구의 첫 버전 이야기예요.
2026년 10월 2일 기준입니다. 제가 만든 중계기와 그 위에서 돌아가는 도구의 개발 기록을 바탕으로 썼고, 특정 기업·서비스의 공식 입장이 아닙니다. 실험 숫자는 코드 변경 하나에서 구성마다 한 번씩 잰 결과라, 다른 코드나 다른 AI에서는 다르게 나올 수 있어요.