이 글에는 제휴 링크가 없고 TypeSafe AI·NVIDIA·OpenAI·앤트로픽과 아무 관계가 없습니다. 제가 직접 만든 중계기의 개발 기록을 바탕으로 썼습니다. 삽화는 GPT 이미지 생성, 도식은 직접 제작했습니다.
생각하지 않고 고르기만 하는 창구 — 객관식에 서술형 답을 쓴 학생 (LLM 중계기 개발기)
객관식 시험 시간이라고 해 볼게요. “다음 중 우리나라의 수도는?” 보기는 넷이에요. 대부분의 학생은 정답 번호에 동그라미를 치고 다음 문제로 넘어갑니다.
그런데 한 학생은 문제마다 여백에 이렇게 적어요. “①일 가능성 5%, ②일 가능성 85%, ③ 5%, ④ 5%.” 틀린 말은 하나도 없는데, 다른 학생들이 연필을 내려놓고 교실을 나갈 때까지 이 학생은 아직 쓰고 있어요. 게다가 채점하는 선생님은 그 퍼센트를 보지도 않아요. 점수는 동그라미 친 번호로만 매기니까요.
제가 만든 LLM 중계기의 ‘판정 창구’가 처음에 바로 이 학생이었어요.
이 글은 LLM 중계기 개발기의 29편입니다. 지난 28편 「지식을 넣었더니 지적이 사라졌다」에서는 AI 리뷰어에게 지식을 넣어 주는 A/B 실험에서 오히려 지적이 사라진 이야기를 했어요. 이번에도 A/B 비교에서 시작하는 이야기예요. 9월 22일에 Jev 소개 글에서 다룬 ‘고르기만 하는 AI’와 이어지는 이야기이기도 하고요.
결론 요약
- 판정 창구 — 답이 정해진 보기 안에서만 나오는 질문(분류, 갈림길, 다음 행동 고르기)을 받는 객관식 창구예요. 고르기 전용 AI인 Jev가 없을 때는 글을 쓰는 보통 AI가 같은 답안 형식을 흉내 냈어요
- 사고 — 첫 흉내는 AI에게 보기마다 확률을 하나씩 다 쓰게 했어요. 글 쓰는 AI는 한 글자씩 쓰니 쓸 게 많을수록 느려요. 그런데 그 확률은 애초에 “믿지 말라”고 표시해 둔 숫자였어요
- 해결 — 이제 AI는 고른 답과 확신도 하나만 쓰고, 나머지 확률은 중계기가 계산해 채워요. 같은 공개 AI로 잰 판정 한 번에서 AI가 쓴 글이 115→52토큰, 걸린 시간이 1.38초→0.62초로 줄었어요
🗳️ 1. 객관식 창구 — 판정 창구가 하는 일
AI에게 묻는 질문 가운데에는 답이 처음부터 정해져 있는 것이 많아요.
- 이 고객 문의는 결제·기술·영업·기타 중 어느 팀이 맡아야 하나 — 분류
- 이 요청은 빠른 AI로 보낼까, 깊이 생각하는 AI로 보낼까 — 갈림길
- 이 글에 답장을 달까, 그냥 넘어갈까 — 다음 행동 고르기
모두 객관식이에요. 답은 보기 안에서만 나오고, 프로그램은 고른 보기에 따라 다음 일을 정하면 돼요. 긴 문장은 필요 없어요.
이런 질문만 받는 창구가 중계기의 판정 창구예요. 9월 22일(v0.1.99)에 새로 냈어요. 약속(계약)은 TypeSafe AI의 Jev에서 그대로 가져왔어요. 판정할 재료(상태)와 질문표를 보내면, 질문마다 답과 확률이 돌아와요. 질문은 세 종류예요.
- 예/아니오 — “사람이 직접 답해야 하는 문의인가?” → 0~1 사이 확률 하나
- 하나 고르기 — “담당 팀은?” → 고른 보기 + 보기별 확률 + 확신도
- 단계 매기기 — “긴급도는 낮음·보통·높음 중 어디?” → 고른 단계 + 단계별 확률 + 확신도
확신도(confidence)는 확률이 한쪽에 얼마나 몰렸는지를 0과 1 사이 숫자 하나로 접은 값이에요. Jev 2편에서 이 숫자로 “자동 처리 · 확인 후 진행 · 사람에게” 세 갈래를 나누는 법을 다뤘어요.
Jev는 Jev 1편에서 본 것처럼 글을 한 글자도 쓰지 않는 AI예요. 보기를 고르기만 하니 빨라요. 제 개발 컴퓨터에서 잰 기록으로 판정 한 번에 0.3초에서 1초 안팎이었어요. Jev에게 대화 창구로 말을 걸면 ‘대화를 지원하지 않는다’는 정해진 오류가 돌아와요. 5편에서 말한, 대화를 하지 않는 AI가 바로 이런 경우예요.
그런데 Jev는 인터넷 너머의 유료 서비스라, 열쇠(API 키)가 없거나 그 서비스에 닿을 수 없는 컴퓨터에서는 쓸 수 없어요. 그래서 판정 창구에는 길이 두 개 있어요.
- 진짜 길 — Jev가 직접 답해요. 확률이 실제로 맞는 빈도에 맞춰 조정(보정)돼 있어서, 응답에 ‘보정됨’(calibrated: true) 표시가 붙어요
- 흉내 길 — Jev가 없으면 중계기에 연결된 글 쓰는 AI에게 “이 질문표에 JSON(정해진 모양의 데이터)으로만 답하라”고 시키고, 돌아온 답을 Jev와 같은 모양으로 정리해요. 이때 확률은 그 AI가 스스로 적어 낸 숫자라 ‘보정 안 됨’(calibrated: false) 표시를 붙이고, 쓰는 쪽에는 “확률로 갈림길을 만들지 말고 고른 답만 믿으라”고 안내했어요
판정 AI를 중계기에게 맡기면(auto) Jev부터, 그다음은 내 컴퓨터에서 돌리는 AI, 그다음은 클라우드의 작은 AI 순서로 연결된 것을 찾아요. 이 글의 사고는 두 번째 길, 흉내에서 났어요.
✍️ 2. 첫 흉내 — 보기마다 확률을 다 쓰게 했다
흉내 길의 첫 버전은 Jev의 답안 모양을 그대로 따라 하려고 했어요. Jev는 보기마다 확률을 돌려주니, 흉내 내는 AI에게도 보기마다 확률을 쓰라고 시켰죠.
고객 문의 한 통(“3일째 정산이 실패하고 있어요. 내일이 월세 납부일인데…”)에 질문 셋을 붙였다고 해 볼게요. 중계기가 AI에게 건넨 답안 양식을 풀어 쓰면 이래요.
- 사람 응대가 필요한가 → 확률 칸 하나
- 담당 팀 → 고른 팀 칸, 그리고 결제 · 기술 · 영업 · 기타 각각의 확률 칸 넷
- 긴급도 → 고른 단계 칸, 그리고 낮음 · 보통 · 높음 각각의 확률 칸 셋
지시문 첫머리에는 “너는 빠르고 보정된 분류기(System One)다”, “확률은 너의 정직한 추정이고, 보기들의 확률을 다 더하면 1이어야 한다”는 문장도 영어로 들어 있었어요. 말로 부탁한다고 확률이 보정되지는 않으니, 그 숫자에는 여전히 ‘보정 안 됨’이 붙었고요.
이 질문표 하나에 AI가 직접 써야 하는 숫자는 여덟 개예요. 예/아니오에 1개, 팀 넷에 4개, 단계 셋에 3개. 보기가 늘면 쓸 숫자도 그만큼 늘어나요.
여기서 Jev 1편의 한 문장을 다시 꺼내야 해요. 글을 쓰는 AI는 답을 한 글자(토큰)씩 만들어요. 쓸 글이 길수록 오래 걸리죠. Jev가 빠른 건 글을 아예 쓰지 않기 때문이고요. 흉내를 내는 AI는 Jev가 아니라 글 쓰는 AI라서, 객관식 답안이라도 한 글자씩 써야 해요. 보기마다 확률을 쓰라는 건 그 AI에게 객관식 문제마다 서술형 답을 쓰게 한 셈이었어요.
🐢 3. 증상 — 같은 AI인데 판정 창구가 더 느렸다
판정 창구를 낸 날, 시연 화면(데모)도 함께 만들었어요. 같은 항목들을 두 열로 나란히 돌려 보는 A/B 화면이에요.
- A 열 — 판정 창구 없이, 보통의 대화 창구에서 AI에게 “JSON으로 분류해 줘”라고 직접 시켜요. 예/아니오에는 확률 하나, 나머지는 보기 이름 하나만 적으라고 해요
- B 열 — 같은 질문을 판정 창구로 보내요
항목마다 걸린 시간, AI가 읽고 쓴 분량, 형식이 깨진 답의 수를 나란히 보여 주고, 마지막에 두 열의 합계를 비교해요.
그런데 이 화면을 돌려 보니 이상한 결과가 나왔어요. A와 B에 같은 AI를 골랐는데, 판정 창구(B)가 그냥 대화로 분류시킨 쪽(A)보다 눈에 띄게 느렸어요. ‘빠른 판정’이라는 이름이 무색했죠.
원인을 따라가 보니 창구 자체의 군더더기가 아니었어요. 개발 기록은 원인을 모델에게 시킨 일의 양이라고 적었어요.
- A 열은 AI에게 짧은 지시문을 주고 “보기 이름 하나만 적어”라고 했어요
- B 열(흉내 길)은 영어 머리말이 붙은 긴 지시문에, 2절의 답안 양식을 줬어요. 읽을 것도 많고, AI가 직접 쓸 숫자만 여덟 개였죠
더 아픈 대목은 따로 있었어요. 그렇게 시간을 들여 받은 보기별 확률은, 1절에서 본 대로 중계기가 스스로 ‘보정 안 됨’ 딱지를 붙이고 “이 숫자로 갈림길을 만들지 말라”고 안내하던 숫자였어요. 채점하지도 않을 퍼센트를 쓰느라 시험 시간을 쓴 학생과 똑같았던 거예요.
✅ 4. 해결 — 답 하나와 확신도 하나, 나머지는 중계기가
고친 버전(v0.1.100)은 그날 밤에 만들었어요. 핵심은 AI가 쓰는 칸을 줄인 것이에요.
- 예/아니오 → 확률 숫자 하나 (그대로)
- 하나 고르기 → 고른 보기 + 확신도 하나
- 단계 매기기 → 고른 단계 + 확신도 하나
같은 질문표라면 AI가 직접 쓰는 숫자는 여덟 개에서 세 개로 줄어요.
그럼 보기별 확률은 어디서 올까요? 쓰는 쪽 프로그램은 여전히 Jev와 같은 모양, 그러니까 보기마다 확률이 붙은 답을 기대하니까요. 이제는 그 칸을 중계기가 계산해서 채워요. 규칙은 단순해요.
① 고른 보기에 AI가 적은 확신도를 줘요 ② 남은 확률(1에서 확신도를 뺀 값)을 나머지 보기에 똑같이 나눠요. 그래서 다 더하면 1이에요 ③ 고른 보기가 다른 보기보다 작아지지 않도록, 확신도가 아주 낮게 와도 ‘보기 수로 똑같이 나눈 몫’보다 작게는 두지 않아요
예를 들어 담당 팀에서 ‘결제’를 고르고 확신도 0.85를 적었다면 결제 0.85, 기술·영업·기타는 0.05씩이에요. 긴급도에서 ‘높음’에 0.9를 적었다면 높음 0.9, 낮음·보통은 0.05씩이고요.
중계기가 만든 숫자를 확률 칸에 넣어도 괜찮을까요? 이 부분은 정직하게 처리했어요.
- 표시는 그대로 — 흉내 길의 답에는 여전히 ‘보정 안 됨’이 붙어요. 원래부터 믿지 말라던 숫자를 AI가 지어내는 대신 중계기가 정해진 규칙으로 만든다는 것만 달라졌어요
- 문서에 밝혔다 — 중계기 안내서에 “흉내 길의 보기별 확률은 AI가 낸 값이 아니라 중계기가 확신도로 만든 분포”라고 적어 뒀어요
- 진짜는 버리지 않는다 — Jev가 직접 답할 때는 Jev가 준 확률을 그대로 써요
- 쓰는 쪽은 할 일이 없다 — 답의 모양이 그대로라, 판정 창구를 쓰던 프로그램은 아무것도 바꾸지 않아도 돼요
지시문도 다이어트를 했어요. 영어로 된 긴 머리말을 줄이고, 답안 양식에서 보기 이름을 두 번씩 늘어놓던 부분을 없앴어요. 지시문은 1,140자에서 595자로, AI가 지켜야 할 답의 모양을 적은 형식 명세(스키마)는 1,202자에서 671자로 줄었어요.
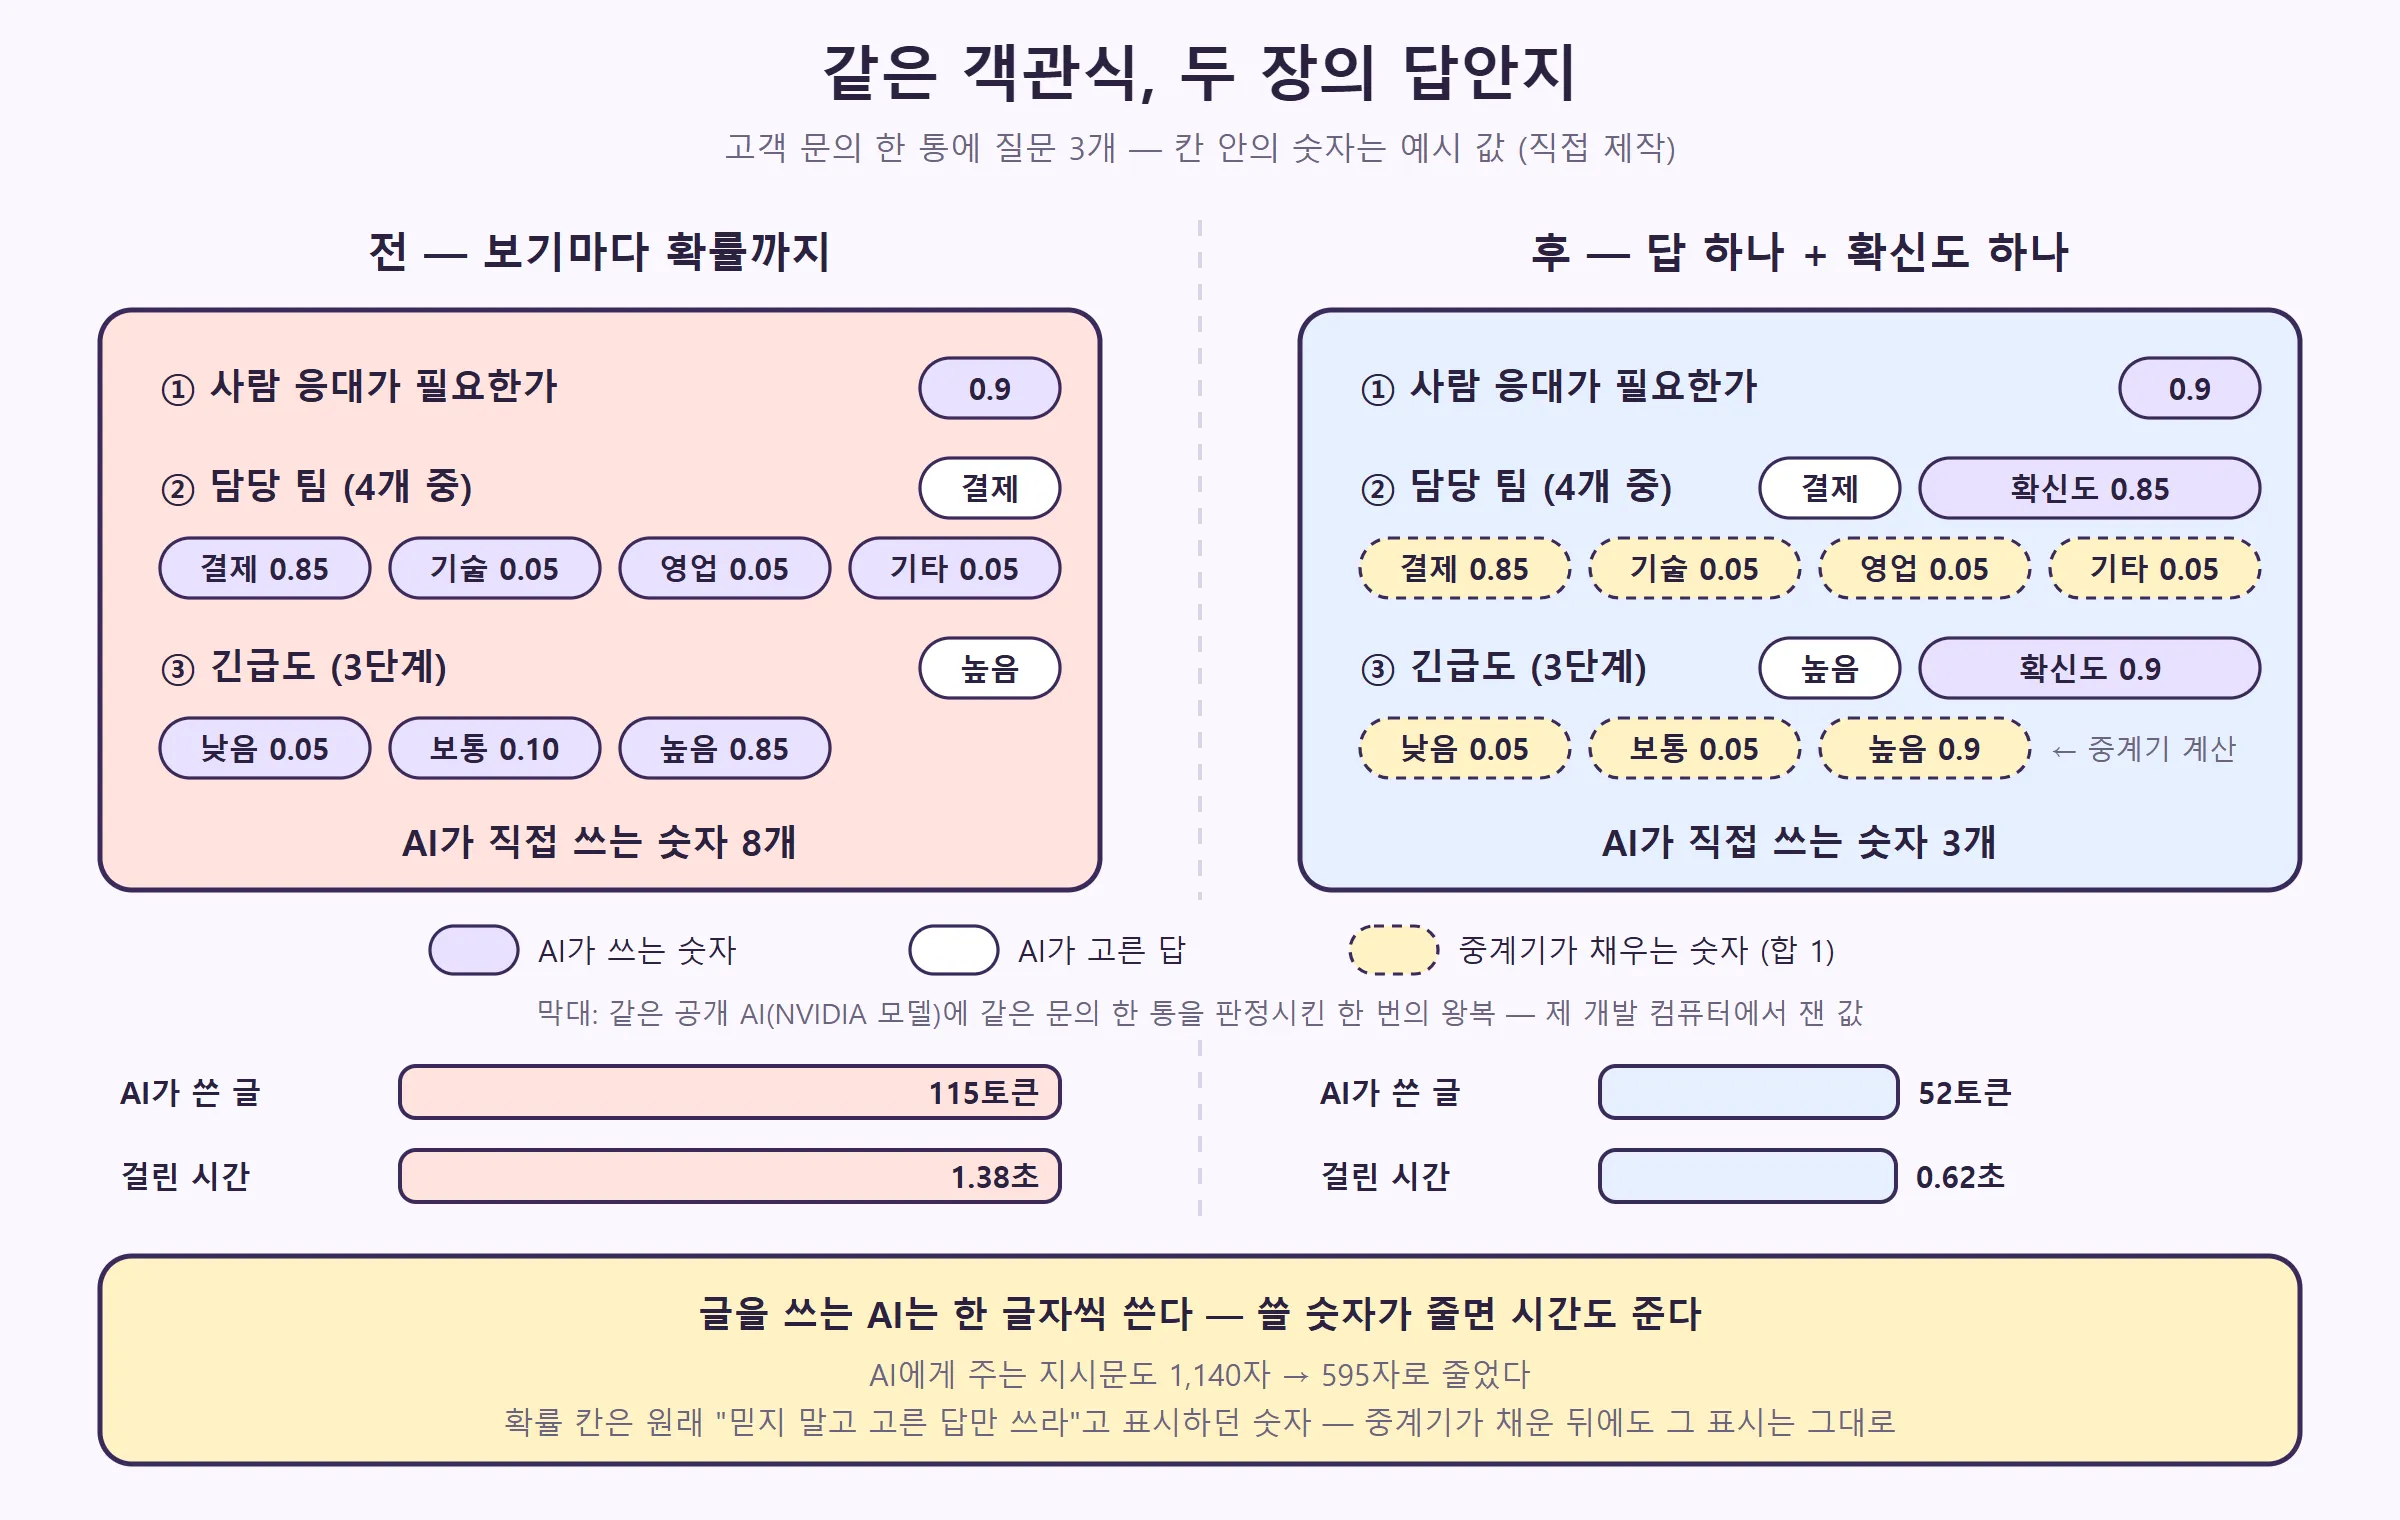
고치기 전과 후를 같은 공개 AI들로 쟀어요. 제 개발 컴퓨터에서, 위의 고객 문의 한 통과 질문 셋으로 판정 창구를 한 번 왕복한 값이에요.
| AI | 읽은 글(입력) | 쓴 글(출력) | 걸린 시간 |
|---|---|---|---|
| NVIDIA의 공개 모델 | 483 → 301토큰 | 115 → 52토큰 | 1.38초 → 0.62초 |
| Claude haiku | 686 → 495토큰 | 117 → 66토큰 | 기록 없음 |
| Codex | 13,514 → 13,333토큰 | 89 → 40토큰 | 기록 없음 |
세 AI 모두 쓴 글이 절반 안팎으로 줄었어요. 시간까지 전후로 짝지어 남은 건 NVIDIA 모델 하나인데, 절반 아래로 줄었고요. Codex는 질문과 상관없이 매번 함께 읽는 기본 분량이 커서 입력은 거의 그대로였지만, 쓴 글은 마찬가지로 절반 아래가 됐어요.
명령어 도구로 붙는 Claude와 Codex는 고친 뒤에도 판정 한 번에 몇 초씩 걸렸어요(제 개발 컴퓨터에서 Claude haiku 5.9초와 6.7초, Codex 4.2초). Claude는 판정 때 대화 기억 없이 한 번 묻고 끝내는 ‘단발’ 방식으로 불러서, 6편의 콜택시처럼 부를 때마다 준비하는 시간이 들어가요. 그래서 중계기 안내서는 명령어 도구 AI의 흉내를 ‘빠른 판정’으로 치지 않고, 다른 길이 없을 때의 대비책으로만 보라고 적어 뒀어요.
작은 고침도 하나 함께 들어갔어요. 작은 AI가 ‘단계 매기기’ 질문에 ‘하나 고르기’ 칸 이름으로 답하면 형식 오류(502)로 끝났거든요. Claude haiku에서 실제로 본 일이에요. 질문의 종류는 보낸 쪽이 이미 정했으니, 칸 이름이 달라도 뜻이 분명하면 받아 주게 했어요. 지시문에도 질문마다 어느 칸에 적을지 이름을 밝혀 두었고요.
⚖️ 5. 같은 AI라면 창구를 바꿔도 빨라지지 않는다 — 공정한 비교 만들기
고친 뒤에도 하나는 분명히 해 둬야 했어요. A와 B에 같은 AI를 고르면, 판정 창구가 대화 창구보다 빨라지지 않아요. 흉내 길도 결국 같은 AI가 글을 쓰는 거니까요. 오히려 확신도까지 적으니 조금 더 쓰죠. 중계기 안내서에는 이걸 따로 한 절로 적었어요. 데모에서 A가 B보다 빠르게 나와도 정상이라고요.
그럼 판정 창구는 왜 쓸까요? 이득은 속도가 아니라 이 세 군데서 나요.
- 형식이 깨지지 않는다 — 보기 밖의 답이나 깨진 JSON은 통과시키지 않아요. 지원하는 AI에는 답의 모양을 강제하고, 어긋나면 한 번 다시 묻고, 그래도 안 되면 짐작으로 채우지 않고 ‘형식 실패’라고 분명히 알려요
- 더 빠른 AI로 바꿔 끼울 수 있다 — 약속이 같으니 쓰는 쪽 프로그램은 그대로 두고, 판정하는 AI만 Jev나 빠른 작은 AI로 바꾸면 그때 빨라져요
- 판정으로 글쓰기를 건너뛴다 — “답장이 필요 없는 글”을 먼저 걸러 내면 긴 글쓰기 자체를 하지 않아요. 큰 절약은 여기서 나요. 빨라지는 건 AI가 아니라 일의 흐름이에요
데모도 이 원칙에 맞게 다듬었어요. 사실 그날 낮에도 한 번 고쳤던 화면이에요.
- 같은 차선을 다투던 두 열 — 처음 데모는 A와 B 두 열을 동시에 돌렸어요. 둘이 같은 AI를 쓰거나 같은 명령어 도구 AI를 쓰면, 10편에서 본 같은 차선을 놓고 서로 기다리게 돼요. 줄 선 시간이 양쪽 기록에 섞여 둘 다 부풀어 보였죠. 이제 기본은 순서대로(A 열을 끝낸 뒤 B 열)이고, 항목마다 줄 선 시간을 따로 보여 줘요. 26편의 병렬 채팅 카드가 읽던 그 ‘줄 선 시간’ 값이에요. 같은 AI나 같은 명령어 도구를 고르면 실행 전에 경고도 띄워요
- 알아서 고른 AI도 확인한다 — B를 ‘auto’로 두면 중계기가 고른 AI가 A와 같아도 경고가 뜨지 않았어요. 이제는 첫 답에서 실제로 고른 AI를 확인해 다시 경고해요
- 느린 걸 ‘빠름’이라고 적던 표 — 비교표는 B가 더 느릴 때도 ‘0.1× 빠름’처럼 ‘빠름’이라고 적었어요. 이제는 ‘N배 B가 느림’으로 적고, 표 아래에 같은 AI일 때 무엇을 봐야 하는지 설명을 붙였어요
함께 내놓은 예제 프로그램도 하나 고쳤어요. 판정으로 거른 뒤 필요한 것만 글을 쓰게 하는 과정을 터미널에서 해 보는 예제인데, 실제로 돌려 보니 NVIDIA 쪽의 일시 오류(503) 한 건에 전체가 멈췄어요.
- 잠깐 붐빔(429)이나 상대 서버의 일시 오류(500번대)는 한 번 다시 시도해요
- 한 항목이 실패해도 나머지 항목은 계속 진행해요
- 판정에 실패한 항목은 걸러 내지 않고 ‘글쓰기 필요’로 넘겨요. 판정이 안 됐다고 건너뛰면 답해야 할 문의를 놓칠 수 있으니까요. 넘어질 때는 안전한 쪽으로 넘어지게 한 거예요
그리고 측정 도구를 하나 더했어요. 고치기 전과 후를 같은 컴퓨터, 같은 문항으로 비교하려면 사람이 데모 화면을 직접 돌려야 했거든요. 이제 데모와 같은 항목과 질문을 명령 한 줄(npm run measure:decisions)로 보내, 항목마다 걸린 시간·읽고 쓴 토큰·다시 시도 횟수를 표로 찍어요.
이 사고에서 남긴 규칙은 넷이에요.
① 믿지 않을 숫자는 받지 않는다 — 쓰지 않을 답을 쓰게 하면 그만큼 기다려야 해요
② 글 쓰는 AI에게는 쓸 분량이 곧 시간이다 — 같은 판정이라도 답안 양식이 짧을수록 빨라요
③ 비교는 같은 조건에서 — 같은 차선을 다투면 둘 다 느려 보이고, 같은 AI끼리는 창구만 바꿔서는 빨라지지 않아요
④ 판정이 실패하면 안전한 쪽으로 — 걸러 내지 말고 다음 단계로 넘겨요
정리
① 판정 창구는 답이 보기 안에서만 나오는 질문을 받는 객관식 창구예요. 고르기 전용 AI인 Jev가 없을 때는 글 쓰는 AI가 같은 답안 형식을 흉내 내요 ② 첫 흉내는 AI에게 보기마다 확률을 다 쓰게 해서, 같은 AI에게 그냥 분류를 시킬 때보다 오히려 느렸어요. 그 확률은 원래 ‘믿지 말라’고 표시하던 숫자였고요 ③ 이제 AI는 고른 답과 확신도 하나만 쓰고 나머지는 중계기가 채워요. 같은 공개 AI에서 쓴 글 115→52토큰, 1.38초→0.62초. 그래도 같은 AI라면 창구만 바꿔서는 빨라지지 않아요 — 이득은 형식 보장, AI 바꿔 끼우기, 글쓰기 건너뛰기에서 나요
다음 30편은 「AI가 허락을 기다리다 멈췄다」예요. 7편에서 미뤄 둔 작업 폴더 모드, 그러니까 AI에게 내 프로젝트 폴더를 맡겨 파일을 고치게 하는 기능에서, AI가 “이거 해도 될까요?” 하고 물었는데 그 질문이 어디에도 전해지지 않아, 답을 기다리다 멈춰 선 이야기를 할게요. 결재 도장을 기다리며 책상 위에 멈춘 서류처럼요.
2026년 10월 2일 기준입니다. 제가 만든 중계기의 개발 기록을 바탕으로 썼고, 특정 기업·서비스의 공식 입장이 아닙니다. 토큰 수와 시간은 제 개발 컴퓨터에서 공개 AI 서비스로 잰 값이라 AI와 환경에 따라 달라요. 답안지 도식의 확률 숫자는 설명용 예시예요.