목차 · 9개
이 글에는 제휴 링크가 없고 미스트랄 AI와 아무 관계가 없습니다. 내용은 미스트랄 공식 발표(2026-10-06)와 미스트랄 문서(2026-10-07 확인), Reuters·TechCrunch(2026-10-06) 보도, Artificial Analysis 독립 평가(2026-10-07 확인) 기준이며, 직접 써 본 후기는 아닙니다. 성능 수치는 누가 잰 것인지를 본문에 각각 적었고, 가중치 공개 전이라 바뀔 수 있습니다. 라이선스 설명은 법률 판단이 아닙니다. 삽화는 GPT 이미지 생성, 도식은 직접 제작했습니다.
미스트랄 라지 4 정리, 1조 파라미터 MoE 뜻과 공개 일정
미스트랄 라지 4 — 1조 파라미터 MoE와 공개 일정 (캐릭터는 GPT 이미지 생성)
“1조 파라미터”라는 숫자를 보면 이런 생각이 들어요. “그게 얼마나 큰 거지? 그리고 나랑 상관있는 모델이야?” 프랑스 미스트랄이 10월 6일에 공개한 라지 4가 딱 그 숫자를 내걸었어요.
의사 1,000명이 상주하는 큰 병원을 떠올려 보세요. 환자 한 명이 1,000명을 다 만나지는 않아요. 접수대가 증상을 보고 그 환자에게 맞는 의사 두세 명만 불러요. 병원 전체 규모가 ‘전체 파라미터’, 환자 한 명이 실제로 만나는 의사 수가 ‘활성 파라미터’예요.
미스트랄 라지 4는 전체 약 1조, 한 번에 쓰는 건 약 500억인 MoE 모델이에요. 지금은 API 프리뷰이고, 가중치는 10월 말에 풀린대요.
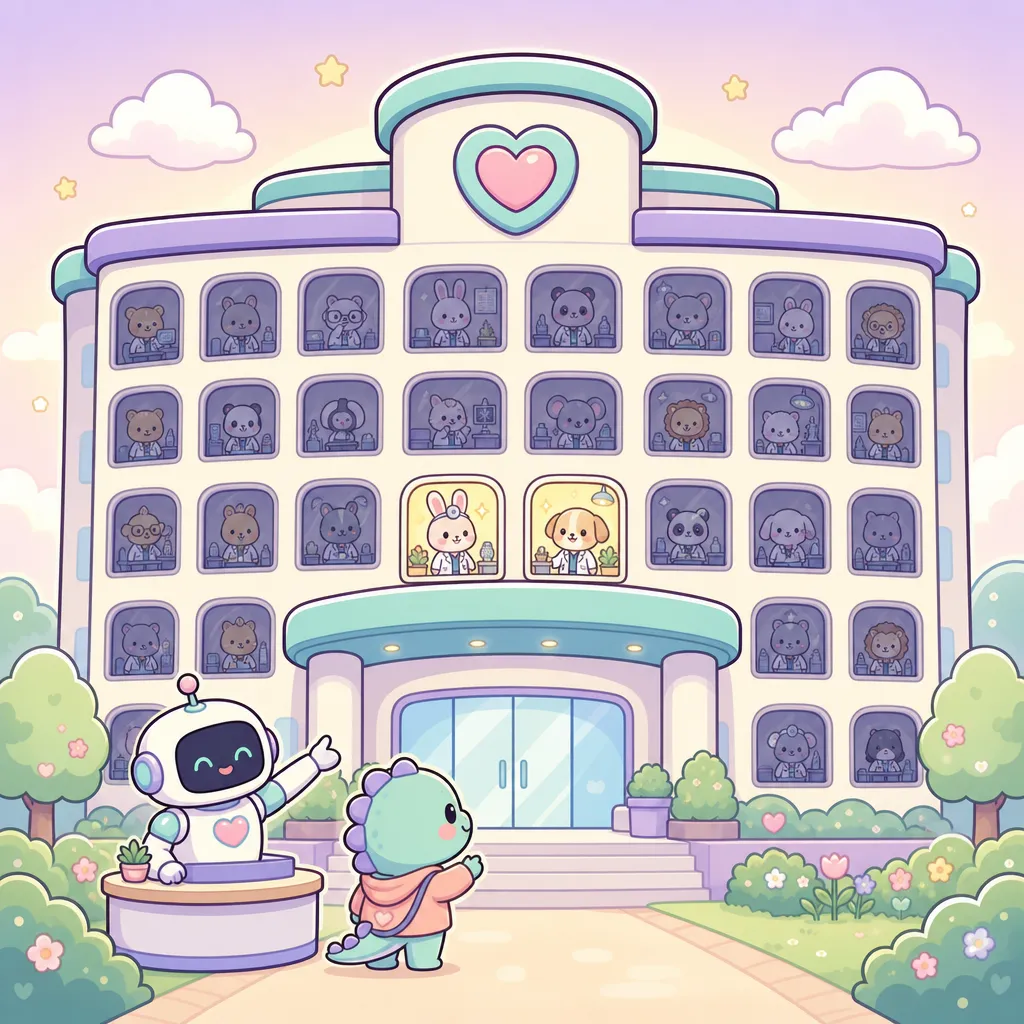
접수 로봇이 큰 병원의 수많은 진료실 중 불 켜진 두 곳만 가리키는 장면 — MoE 라우터가 전문가를 고르는 모습 (GPT 이미지 생성)
① MoE와 ‘전체 1조 · 활성 500억’이 무슨 뜻인지
② 미스트랄이 밝힌 성적과 독립 평가의 차이
③ 가격·써 보는 곳·가중치 공개 일정
2026년 10월 7일 기준 · 미스트랄 발표·문서
1. 무슨 일: API 프리뷰로 먼저 공개
2026년 10월 6일 프랑스 미스트랄 AI가 새 최상위 모델 미스트랄 라지 4(Mistral Large 4)의 공개 프리뷰를 시작했어요.
- 발표문은 이렇게 시작해요. “오늘 우리는 미스트랄 라지 4의 공개 프리뷰를 시작합니다. 비공식 이름은 ML4, 아주 공식적인 이름은 le Chonk.”
- chonk는 통통하다는 뜻의 영어 인터넷 속어예요. 지금은 미스트랄 스튜디오(Mistral Studio)에서 API로만 써 볼 수 있고, 모델 이름은
mistral-large-4예요.
가중치는 아직 공개 전이에요. 발표문은 “이달 말까지 가중치를 공개하겠다”고 했고, 로이터는 10월 27일 공개로 보도했어요. 그때까지 보안 업계와 검증된 파트너, 정부 기관은 “완화된 조정과 확장된 사이버 능력”을 가진 같은 모델로 실전 레드팀 테스트를 해요. 일반에 열린 프리뷰는 보호 장치가 있는 엔드포인트라고 테크크런치는 전했어요.
2. MoE 뜻: 토큰마다 전문가를 고른다
MoE(Mixture of Experts, 전문가 혼합)는 모델 안에 작은 전문가 신경망을 여럿 두고, 토큰마다 그중 일부만 골라 계산하는 구조예요.
- 글은 토큰이라는 조각 단위로 처리돼요. 토큰 하나가 들어오면 ‘라우터’라는 작은 판단 장치가 어느 전문가에게 보낼지 정하고, 고른 전문가들의 답을 합쳐 다음 토큰으로 넘어가요.
- 병원 비유로 돌아가면 접수대가 라우터이고, 진료실마다 있는 의사가 전문가예요. 환자(토큰)마다 부르는 의사가 달라져요.
미스트랄 문서는 라지 4를 “세분화된(granular) 전문가 혼합 구조”라고 적었어요. 전문가가 몇 명이고 토큰마다 몇 명을 고르는지는 아직 안 밝혔고, 발표문은 가중치를 공개할 때 구조를 더 설명하겠다고 했어요.
3. 전체 1조와 활성 500억, 둘 다 본다
전체 파라미터는 메모리를 얼마나 차지하는지, 활성 파라미터는 토큰 하나를 만들 때 계산을 얼마나 하는지를 정해요.
- 전체 1조 개는 어느 전문가가 불릴지 모르니 전부 메모리에 올려 둬야 해요. 그래서 ‘활성 500억’만 보고 500억짜리 모델과 같은 장비에서 돌아간다고 생각하면 안 돼요.
- 반대로 계산량은 활성 쪽을 따라가요. 같은 1조라도 전부 쓰는 모델보다 토큰당 계산이 훨씬 적어서 속도와 비용에 유리해요.
숫자는 자료마다 조금 달라요. 발표문은 “1조 파라미터, 활성 490억”, 문서는 “전체 1.05조, 활성 520억, 시각 인코더 16억”이라고 적었어요. 이 글은 ‘약 1조·약 500억’으로 뭉뚱그려요. 전작 라지 3(2025년 12월)는 전체 6,750억·활성 410억이었어요. 전체는 1.5배 가까이 커졌고 활성은 조금 늘었어요.
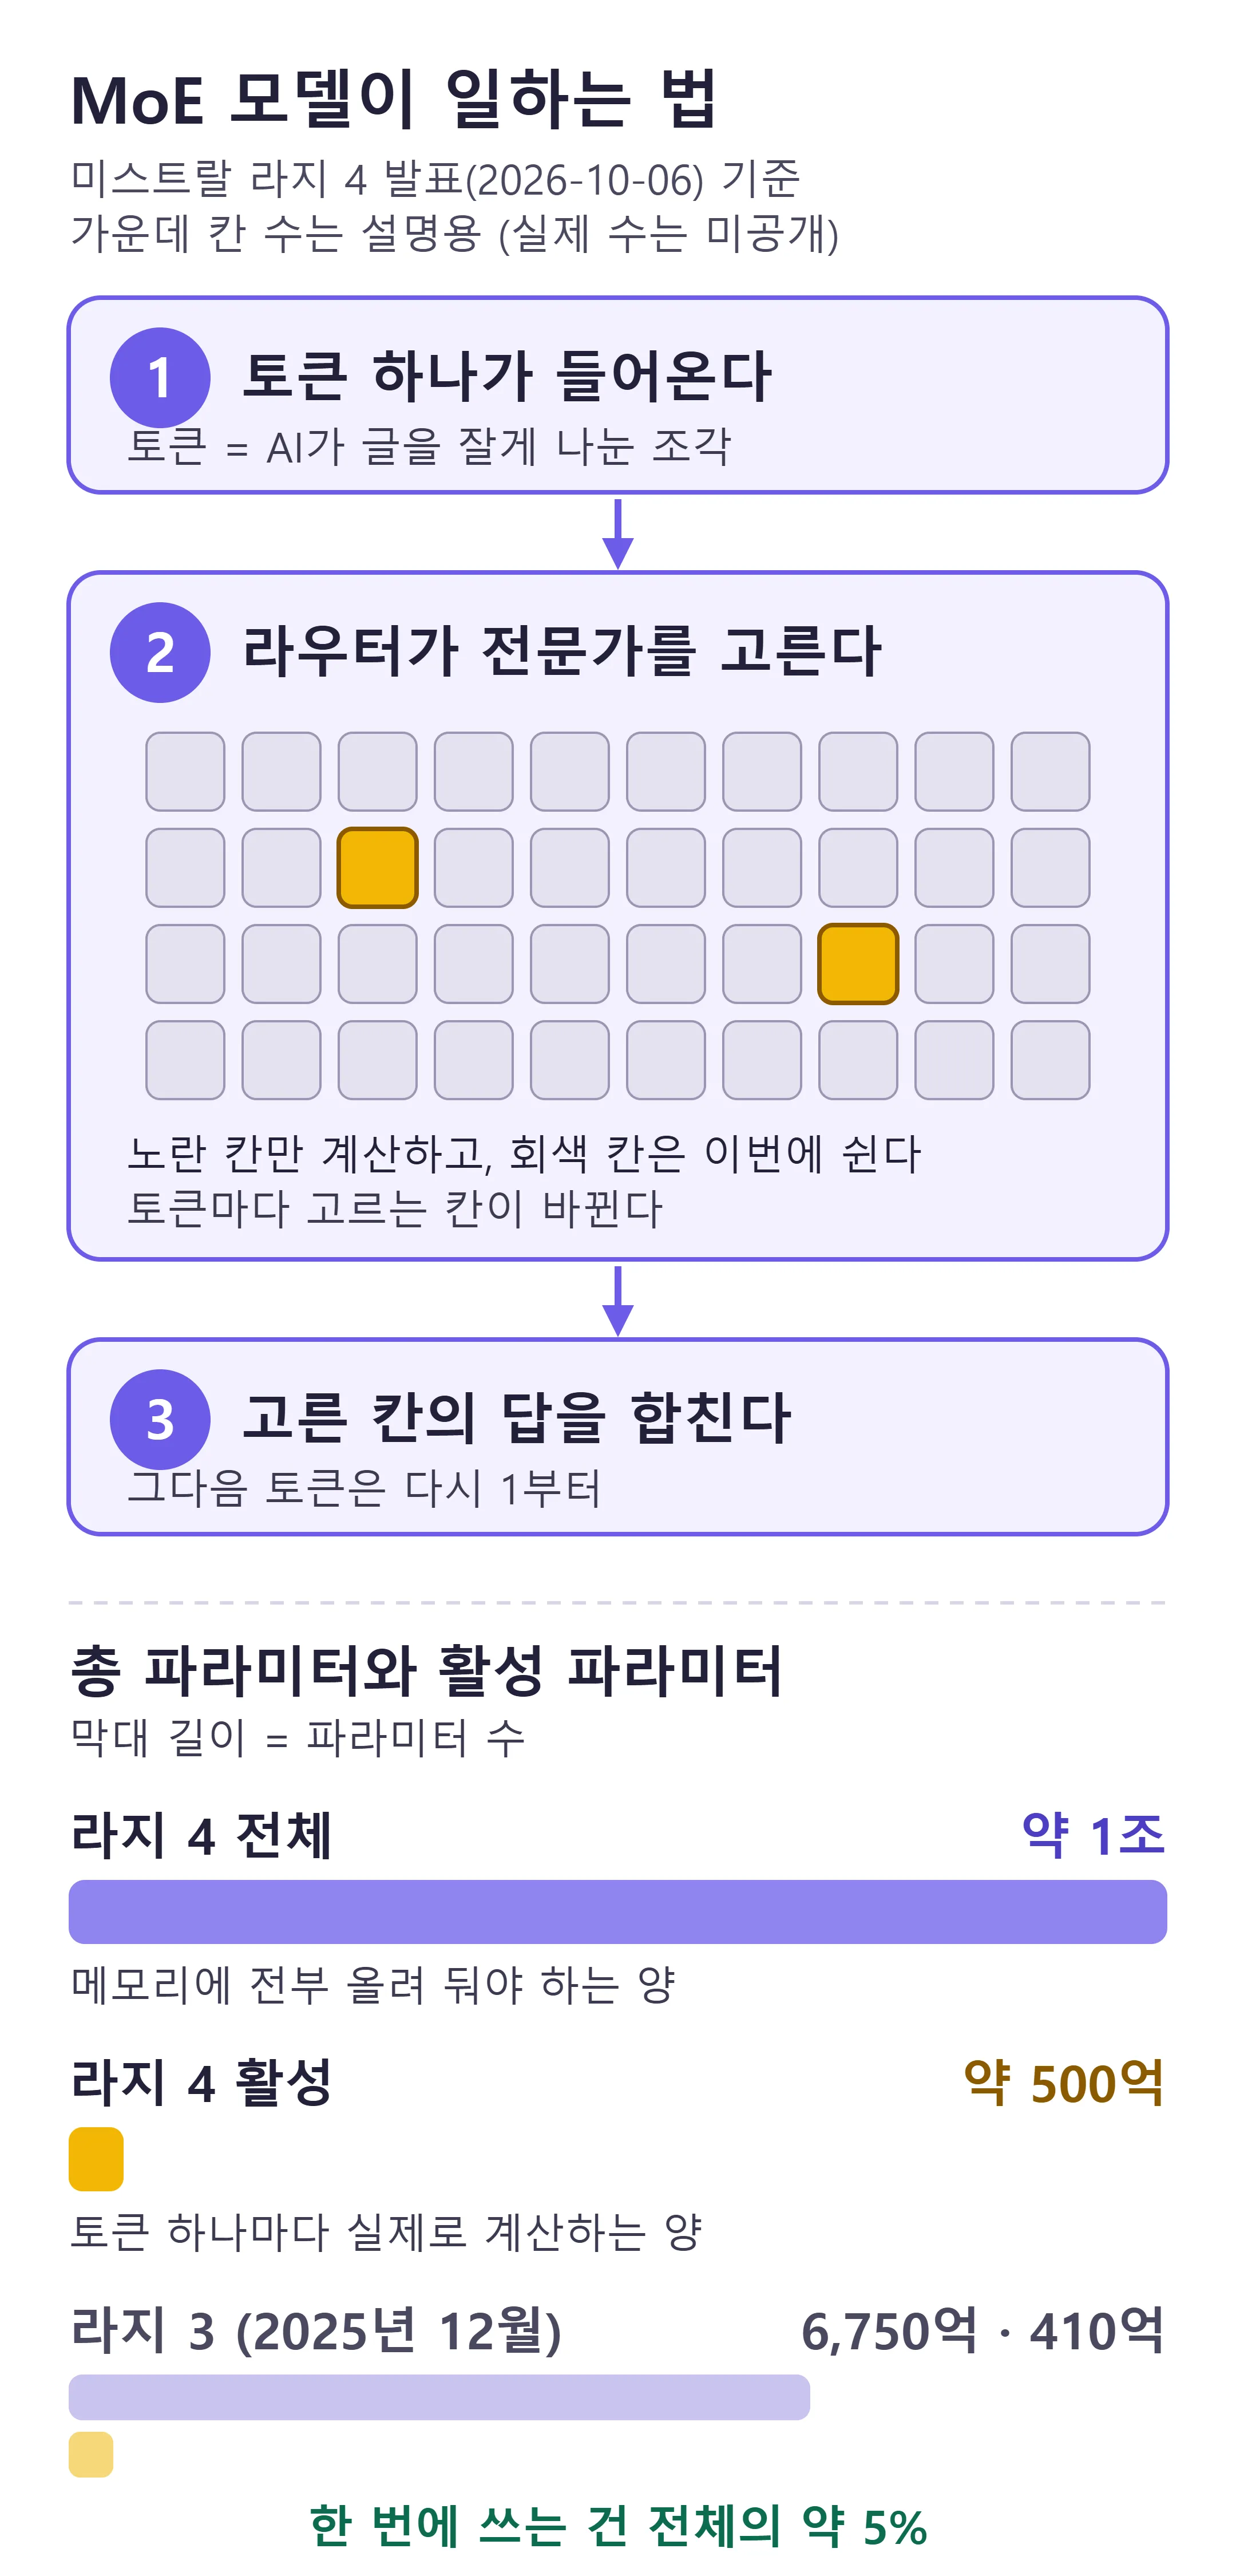
MoE가 토큰 하나를 처리하는 세 단계와, 라지 4·라지 3의 전체 파라미터 대 활성 파라미터 — 한 번에 쓰는 건 전체의 약 5% (직접 제작)
4. 미스트랄이 밝힌 성적
미스트랄은 라지 4가 코딩·에이전트·사이버보안·이미지 이해에서 오픈웨이트 중 최상위라고 밝혔어요.
- 발표문의 표현은 이래요. “전 세계에서 가장 강한 오픈소스 모델들과 경쟁할 만한 성능이며, 미국이나 유럽에서 개발된 어떤 오픈웨이트 모델보다 크게 앞선다.”
- 발표문에 나온 수치를 옮겼어요. 평가 종목과 비교 상대는 모두 미스트랄이 고른 거예요.
| 평가 (재는 것) | 미스트랄이 밝힌 결과 |
|---|---|
| AA 사이버 지수 중 취약점 재현·패치 | 82%, 전체 모델 중 최고 |
| Cybench (보안 대회 문제 40개) | 93% 해결 |
| DeepSWE v1.1 (실전 코딩) | 61.7% |
| Terminal-Bench 4 (터미널 작업) | 28.3% |
| 코딩 에이전트 지수 (합산) | 49.8%, DeepSeek V4 Pro·Qwen3.8 Max 앞 |
| AutomationBench (업무 자동화 657건) | 59.9%, Kimi K3·MiMo-V2.6-Pro 앞 |
| Dense 200 (이미지 위치 찾기) | 42%, GPT-6 Astra 41% 앞 |
| Surge AI 코딩 블라인드 평가 | 5개 중 2위(3.74), 1위 Claude Opus 5 |
사이버보안 설명이 특히 길어요. 미스트랄은 Claude Opus 5.5나 GPT-6 Astra 같은 폐쇄형 모델이 취약점 재현 과제를 거부해 0점 가까이 받는다며, 방어자에게는 거부하지 않는 모델이 필요하다고 주장해요. 학습은 유럽에 있는 자체 데이터센터의 엔비디아 그레이스 블랙웰 GPU 3,800장으로 처음부터 했고, 학습 데이터는 EU 공식 언어 전부를 포함한 160개 넘는 언어였대요.
5. 검증: 독립 평가와 숫자 불일치
로봇이 별이 가득한 자기 성적표를 들어 보이고, 탐정이 돋보기로 상자 속을 확인하는 장면 — 회사 벤치마크와 독립 검증 (GPT 이미지 생성)
4장의 숫자는 미스트랄이 고른 평가에서 미스트랄이 잰 점수예요. 독립 평가는 결이 조금 달라요. 평가 기관 Artificial Analysis가 10월 6일 프리뷰 API를 직접 재서 올린 결과를 보면 이래요.
① 지능 지수(Intelligence Index) 38점. 같은 기관 표에서 중국 오픈웨이트 MiMo-V2.6-Pro 46, Qwen3.8 Max 45, GLM-5.3 45, Kimi K3 44보다 낮고, DeepSeek V4 Pro 36보다는 높아요. 이 기관은 “미국·중국 밖에서 나온 가장 똑똑한 모델”이라고 평했어요.
② 사이버 지수(Cyber Index) 50점. GLM-5.3-Flash와 같고, Grok 4.7 56, MiMo-V2.6-Pro 56, GPT-6 Luna 53 뒤예요. 미스트랄이 말한 ‘상위 5위 안’과 어긋나진 않지만 1위는 아니에요.
발표 자료끼리도 숫자가 조금씩 달라요. 아직 ‘프리뷰’라는 뜻이라, 글을 옮길 때 어느 자료 기준인지 적어 두는 게 안전해요.
| 항목 | 자료마다 다른 값 |
|---|---|
| 활성 파라미터 | 발표문 490억 · 문서 520억 |
| 전체 파라미터 | 발표문 1조 · 문서 1.05조 |
| 학습 GPU 수 | 발표문 3,800장 · 테크크런치 인터뷰 4,000장 |
| 가중치 공개 | 발표문 ‘이달 말’ · 로이터 10월 27일 |
| 컨텍스트 길이 | 문서 100만 토큰 · AA 표기 512k(약 52만) |
그래서 지금 할 수 있는 판단은 여기까지예요. 가중치가 나온 뒤 남이 잰 점수로 체급을 판단하는 게 맞아요. 발표 수치만 보고 순위를 매기지 마세요. 미스트랄도 가중치를 공개할 때 구조 설명과 추가 벤치마크, 사후 학습 방법을 함께 내겠다고 했어요.
6. 가격과 써 보는 곳, 라이선스
정가는 100만 토큰당 입력 1.36달러, 출력 4.18달러예요. 10월 7일 문서 요금표에는 절반인 세일 가격이 함께 표시돼 있어요. 미스트랄 문서 요금표의 숫자를 옮겼어요.
| 모델 (100만 토큰당) | 입력 · 출력 |
|---|---|
| 미스트랄 라지 4 (정가) | $1.36 · $4.18 |
| 미스트랄 라지 4 (10/7 세일 표시) | $0.68 · $2.09 |
| 미스트랄 라지 3 | $0.5 · $1.5 |
| 미스트랄 미디엄 3.5 | $1.5 · $7.5 |
세일이 언제까지인지는 미스트랄 발표문과 문서에서 찾지 못했어요. Artificial Analysis 글은 “첫 2주 50% 할인”이라고 적었어요. 캐시된 입력은 100만 토큰당 0.14달러이고, 대량 작업용 배치 처리는 미스트랄 요금 안내상 50% 싸요. 정가 기준으로 라지 3보다 입력은 2.7배, 출력은 2.8배 비싸졌어요.
써 보는 곳은 미스트랄 스튜디오의 프리뷰 API예요. 발표문에 Le Chat 같은 소비자 앱 제공 이야기는 없어요. 라이선스 이름은 아직 없어요. 문서의 라이선스 칸에는 ‘Open’이라고만 적혀 있고, 라지 3는 Apache 2.0이었어요. 10월 7일 현재 허깅페이스의 미스트랄 계정에도 라지 4는 없어요. 컨텍스트는 문서 기준 100만 토큰이고, 입력은 글과 이미지예요. 160개 넘는 언어로 학습했다지만 한국어가 어느 수준인지는 발표에 없어요.
7. 무슨 뜻인가: 유럽 오픈웨이트의 체급
happy_various는 이번 발표를 유럽 오픈웨이트가 ‘1조 체급’ 경쟁에 들어왔다는 신호로 봐요.
- 로이터에 따르면 미스트랄 CEO 아르튀르 멘슈는 아부다비 행사에서 “오늘 발표하는 모델은 사이버를 포함한 몇몇 측면에서 중국 모델들보다 위에 있다. 그러니 유럽은 경쟁할 수 없다는 서사는 사실이 아니다”라고 말했어요.
- 테크크런치 인터뷰에서 미스트랄 과학 부문 부사장 피에르 스톡은 GPU 4,000장이 “중국 경쟁사보다 2~3배 적고, 폐쇄형 경쟁사보다는 훨씬 적다”고 했어요. 적은 자원으로 체급을 맞췄다는 게 회사의 주장이에요.
같은 주에 미국 리플렉션 AI도 오픈웨이트 MoE 모델 빔(전체 5,010억·활성 230억)을 발표했어요. 미국과 유럽이 각자 ‘중국 밖 오픈웨이트’ 자리를 노리는 모양새예요. 방향은 9월에 정리한 ‘AI 3사가 해킹 능력 모델을 잠근’ 흐름과 반대예요. 미스트랄은 “제공자 수준의 거부가 정당한 취약점 연구와 사고 대응을 막을 수 있다”며, 오픈웨이트와 자체 배포로 조직이 자기 규칙 아래서 보안 작업을 하게 하겠다고 해요. 어느 쪽이 맞는지는 이 글이 판단할 영역이 아니라 사실만 적어요.
도입·교육 관점에서 챙길 건 네 가지예요. 모델 비교 자료에 ① 전체 파라미터 ② 활성 파라미터 ③ 라이선스 ④ 누가 잰 점수인지를 같이 적는 습관이에요. 1조라는 숫자 하나로는 메모리도, 속도도, 쓸 수 있는 조건도 알 수 없거든요.
② 전체 약 1조 · 활성 약 500억 MoE, 이미지 입력
③ 정가 입력 $1.36 · 출력 $4.18, 10/7 세일 절반
④ 회사 발표는 최상위, 독립 지능 지수는 38점
오늘의 큰 흐름: 유럽 오픈웨이트 체급 경쟁. 1조라는 숫자보다, 가중치가 풀린 뒤 누가 잰 점수인지가 기준이에요.
자주 묻는 질문
Q. 지금 어디서 써 볼 수 있나요?
미스트랄 스튜디오의 프리뷰 API(mistral-large-4)예요. 발표문에 Le Chat 같은 앱 제공 이야기는 없고, 허깅페이스에도 10월 7일 현재 올라오지 않았어요.
Q. 활성이 500억이면 500억짜리 모델과 같은 장비에서 돌아가나요?
아니에요. 어느 전문가가 불릴지 모르니 전체 약 1조 개를 메모리에 올려 둬야 해요. 활성 수는 계산량과 속도에 관계된 숫자예요. 미스트랄은 아직 권장 장비를 발표하지 않았어요.
Q. 라이선스는 뭔가요?
10월 7일 현재 발표문과 문서에 이름이 없어요. 문서에는 ‘Open’으로만 표시돼 있고, 전작 라지 3는 Apache 2.0이었어요. 가중치가 공개될 때 확인해야 해요.
Q. 한국어도 되나요?
발표문은 EU 공식 언어 전부를 포함한 160개 넘는 언어로 학습했다고만 했어요. 한국어 품질은 따로 밝히지 않았어요.
AI 회사들이 해킹 능력 모델의 문을 먼저 잠근 9월 이야기는 이 글에 있어요. 미스트랄은 반대 방향이에요.
→ AI 사이버보안 모델, 해킹 능력 AI를 3사가 잠근 이유
참고 자료
- 미스트랄 공식 발표 — Introducing Mistral Large 4 · mistral.ai/news/mistral-large-4
- 미스트랄 문서 — Mistral Large 4 모델·요금 · docs.mistral.ai/models/mistral-large-4-0
- Artificial Analysis — Mistral Large 4 독립 평가 · artificialanalysis.ai/articles/mistral-large-4-france-ai
미스트랄 발표·문서, 로이터·테크크런치, AA 평가
직접 써 본 후기 아님 · 수치마다 잰 곳 표기
제휴 없음 · 미스트랄과 관계없음
캐릭터는 GPT 생성, 도식은 직접 제작
부록: 출처 전체 (2026-10-07 확인)
- 미스트랄 공식 발표 — Introducing Mistral Large 4 (2026-10-06) — 공개 프리뷰·Mistral Studio, 1조 파라미터·활성 490억, 가중치 ‘이달 말’, 레드팀 상대에게 완화된 조정, 3,800 GPU·유럽 데이터센터, 160개 넘는 언어, 벤치마크, 입력 $1.36·출력 $4.18, €30억 시리즈 D
- 미스트랄 문서 — Mistral Large 4 · 모델 목록 · 요금 — Public Preview, 라이선스 칸 ‘Open’, 활성 520억·전체 1.05조·시각 인코더 16억, 컨텍스트 1M, 정가와 세일 가격, 라지 3 $0.5/$1.5(Apache 2.0), 미디엄 3.5 $1.5/$7.5, 배치 50% 할인
- 미스트랄 — Mistral 3 발표 (2025-12-02) — 라지 3 전체 6,750억·활성 410억, Apache 2.0
- Reuters — France’s Mistral announces new AI model (PARIS, 2026-10-06) · The Star 전재 — 10월 27일 공개, 그 전에 보안 전문가·정부 기관에 완화 버전, 멘슈 발언, 오픈웨이트 뜻, €30억 조달
- TechCrunch — Mistral’s new 1T model aims to leapfrog closed and open rivals (2026-10-06) — 피에르 스톡 ‘4,000 GPU’, 가중치 3주 뒤, 보호 장치 있는 공개 엔드포인트
- Artificial Analysis — Mistral Large 4 평가 글 · 지능 지수 순위표 · 사이버 지수 (2026-10-07 조회) — 지능 지수 38, 사이버 지수 50, 비교 모델 점수, 첫 2주 50% 할인, 컨텍스트 512k 표기
- Hugging Face — mistralai (2026-10-07 조회) — 라지 4 저장소 없음
- Reflection AI — Introducing Beam (2026-10-05) — 전체 5,010억·활성 230억 (7장 한 줄)