목차 · 9개
이 글에는 제휴 링크가 없고 리플렉션 AI와 아무 관계가 없습니다. 내용은 리플렉션 AI 공식 발표(2026-10-05)와 TechCrunch(2026-10-05, 2025-10-09)·The Decoder(2026-10-06) 보도, Apache License 2.0 원문 기준이며, 성능·효율 수치는 회사가 밝힌 것으로 2026년 10월 7일 현재 독립 검증 전입니다. 직접 써 본 후기가 아니고, 라이선스 설명은 법률 판단이 아닙니다. 삽화는 GPT 이미지 생성, 도식은 직접 제작했습니다.
리플렉션 AI 빔 정리, 적은 연산으로 중국 모델 잡겠다는 오픈웨이트
리플렉션 AI 빔 — 더 적은 연산을 내건 오픈웨이트 모델 (캐릭터는 GPT 이미지 생성)
중국 오픈 모델만큼 잘하면서 계산은 훨씬 덜 쓴다는 미국 모델이 나왔어요. 이런 소식을 들으면 질문이 두 개 남아요. “정말 싸게 돌아가? 그리고 우리 회사가 직접 쓸 수 있어?”
요리사가 아주 많은 대형 주방을 떠올려 볼게요. 주문이 들어오면 모두가 불을 켜는 게 아니라, 그 요리를 잘하는 몇 명만 움직여요. 스무 명 중 한 명꼴이에요. 주방은 크지만 주문 하나에 드는 가스비는 작은 주방과 비슷해지죠. 게다가 이 주방은 레시피를 통째로 공개해서, 다른 가게가 자기 주방에서 같은 요리를 끓일 수 있게 하겠대요.
리플렉션 AI의 빔(Beam)이 이런 모델이에요. 덩치는 크게, 한 번에 쓰는 힘은 작게 해서 같은 답을 더 적은 연산으로 내겠다는 오픈웨이트 모델이에요.
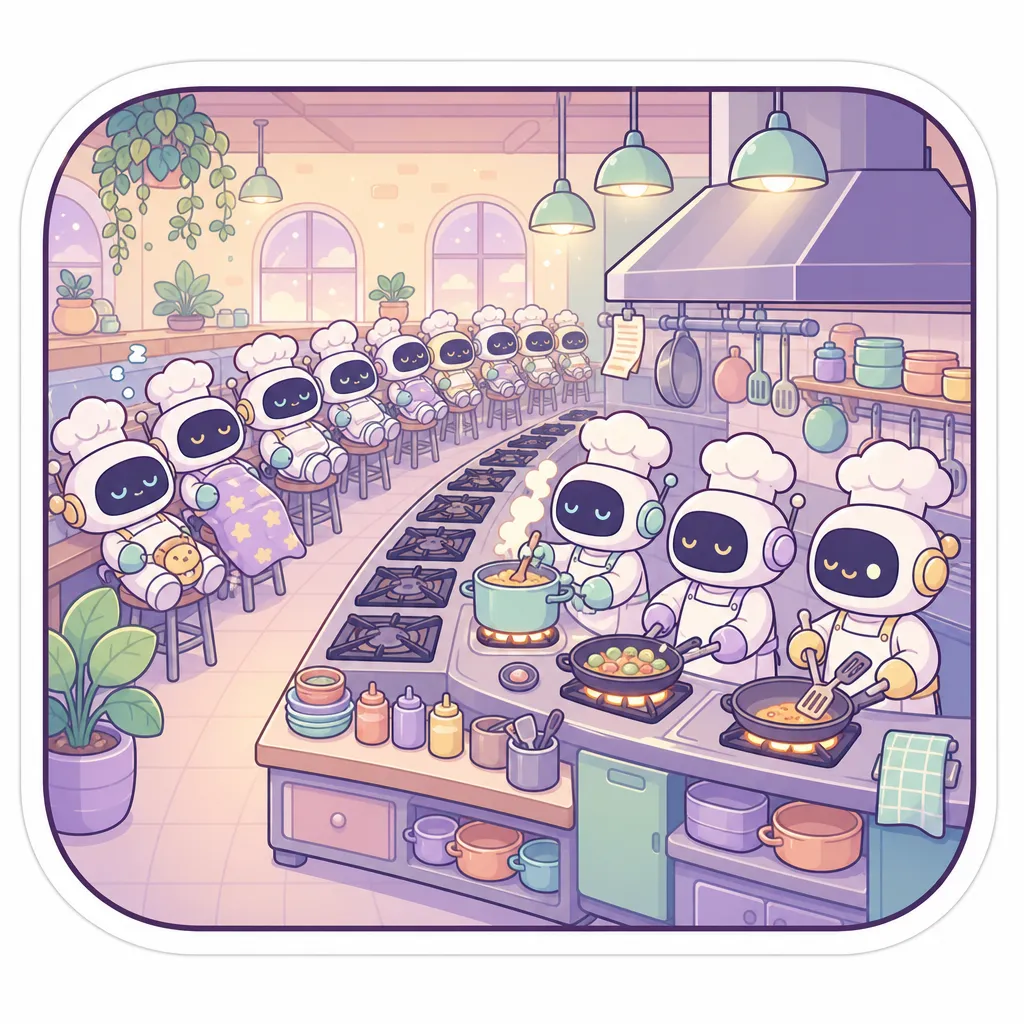
요리사 로봇이 가득한 대형 주방에서 주문 하나에 세 명만 불을 켠 장면 — 전문가 혼합(MoE) 모델을 빗댄 그림 (GPT 이미지 생성)
① 빔이 어떤 모델인지 숫자로
② ‘연산 3배에서 4배 절약’과 토큰 단가의 관계
③ 오픈웨이트가 기업에 중요한 이유와 검증 일정
2026년 10월 7일 기준 · 공식 발표와 보도
1. 무슨 일: 리플렉션의 첫 오픈웨이트
2026년 10월 5일 미국 AI 스타트업 리플렉션 AI가 첫 오픈웨이트 모델 빔을 발표했어요. 회사는 빔을 코딩, 추론, 에이전트 작업용 모델이라고 소개해요. 그리고 빔이 “서방 오픈웨이트의 최전선을 앞당긴다(advances the Western open-weight frontier)”고 적었어요.
리플렉션 AI는 구글 딥마인드 출신 미샤 라스킨과 이오아니스 안토노글루가 2024년에 세운 회사예요. TechCrunch에 따르면 2025년 10월 엔비디아 등에서 20억 달러를 투자받으며 ‘미국의 오픈 프런티어 연구소’를 내걸었어요. TechCrunch는 빔이 겨누는 상대로 딥시크, 큐웬(Qwen), Z.ai 같은 중국 오픈 모델을 꼽았어요. 오픈웨이트의 앞줄을 차지한 중국 모델에 대한 미국 쪽 답인 셈이에요.
2. 숫자로 본 빔
빔은 전체 파라미터 5,010억 개 가운데 230억 개만 한 번에 쓰는 전문가 혼합(MoE) 모델이에요. 전문가 혼합(Mixture-of-Experts)은 모델 안을 여러 ‘전문가’ 묶음으로 나누고, 토큰마다 필요한 묶음만 깨워 계산하는 구조예요. 앞의 주방 비유에서 주문마다 몇 명만 움직이는 것과 같아요.
회사 발표와 TechCrunch 보도에 나온 숫자를 표로 옮겼어요.
| 항목 | 발표 내용 |
|---|---|
| 전체 파라미터 | 5,010억 개 (501B) |
| 한 번에 쓰는 파라미터 | 230억 개 (23B) |
| 사전 학습 데이터 | 23조 8천억 토큰 (웹 + 라이선스를 받은 비공개 데이터) |
| 강화학습 | GB300 GPU 1만 500장으로 4주, 1억 번 넘는 시도 |
| 문맥 길이 | 중간 학습에서 100만 토큰까지 확장 |
| 입력 | 텍스트만 (이미지·음성 없음) |
| 라이선스 | Apache 2.0 (가중치 공개 때) |
쓰는 방법은 10월 7일 현재 하나뿐이에요. 회사가 “최종 레드팀 점검과 평가 중”이라며 받는 조기 접근 신청을 거쳐 API로 써 보는 거예요. 가중치, 기술 보고서, 모델 카드는 “이달 중(later this month)” 공개한다고 했어요. 10월 안이라는 뜻이고, 정확한 날짜는 밝히지 않았어요.
3. ‘연산 3배에서 4배 절약’의 정체
회사 주장은 “고급 추론 평가에서 GLM-5.2와 비슷한 점수를 3~4배 적은 추론 연산으로 낸다”예요. GLM-5.2는 중국 Z.ai의 대표 오픈 모델이에요. TechCrunch에 따르면 전체 7,440억 개 중 400억 개를 한 번에 써요.
이 숫자는 요금을 잰 게 아니라 계산식으로 어림한 값이에요. 회사는 Artificial Analysis와 DataCurve의 자료를 써서 ‘연산량 ≈ 2 × 한 번에 쓰는 파라미터 × 답 하나에 생성한 평균 토큰 수’로 셈했다고 밝혔어요. 한 번에 쓰는 파라미터는 230억 대 400억, 약 1.7배 차이예요. 회사 계산식을 그대로 따라가면, 나머지 차이는 빔이 답 하나에 쓰는 토큰이 더 적다는 데서 나와요.
회사도 단서를 달았어요. 프롬프트를 읽어 들이는 처리, 긴 문맥에서 늘어나는 계산, 서비스 운영 비용은 빼고 셈했고, 그래서 “측정한 추론 비용이 아니라 대략적인 연산 비교”라고 적었어요.
4. 토큰 단가와 효율의 관계
토큰 단가는 AI가 글을 읽고 쓰는 양에 매기는 값이에요. 보통 ‘100만 토큰당 몇 달러’로 붙어요. 토큰은 AI가 글을 잘게 나눠 세는 단위예요. API로 AI를 쓰면 보낸 글(입력)과 받은 글(출력)의 토큰 수만큼 돈을 내요.
그래서 답 하나의 비용은 ‘토큰 단가 × 쓰는 토큰 수’로 정해져요. 빔의 주장은 이 곱셈의 두 칸을 다 건드려요.
① 토큰 단가 쪽 — 토큰 하나를 만드는 계산은 한 번에 쓰는 파라미터에 비례해요. 230억 개만 계산하면 같은 장비로 토큰을 더 많이 만들 수 있어, 값을 낮출 여지가 생겨요
② 쓰는 토큰 수 쪽 — 답 하나에 생성하는 토큰이 적으면 단가가 같아도 비용이 줄어요. 회사는 이걸 “토큰당 더 많은 지능”이라고 표현했어요
회사는 이 결과가 “더 낮은 비용으로 강한 성능”이 된다고 했지만, 10월 7일 현재 빔의 가격표는 공식 글과 문서 어디에도 없어요. 또 가중치가 풀리면 여러 클라우드가 각자 빔을 올려 값을 매길 수 있어서, 실제 단가는 회사 하나가 정하지 않을 수도 있어요.
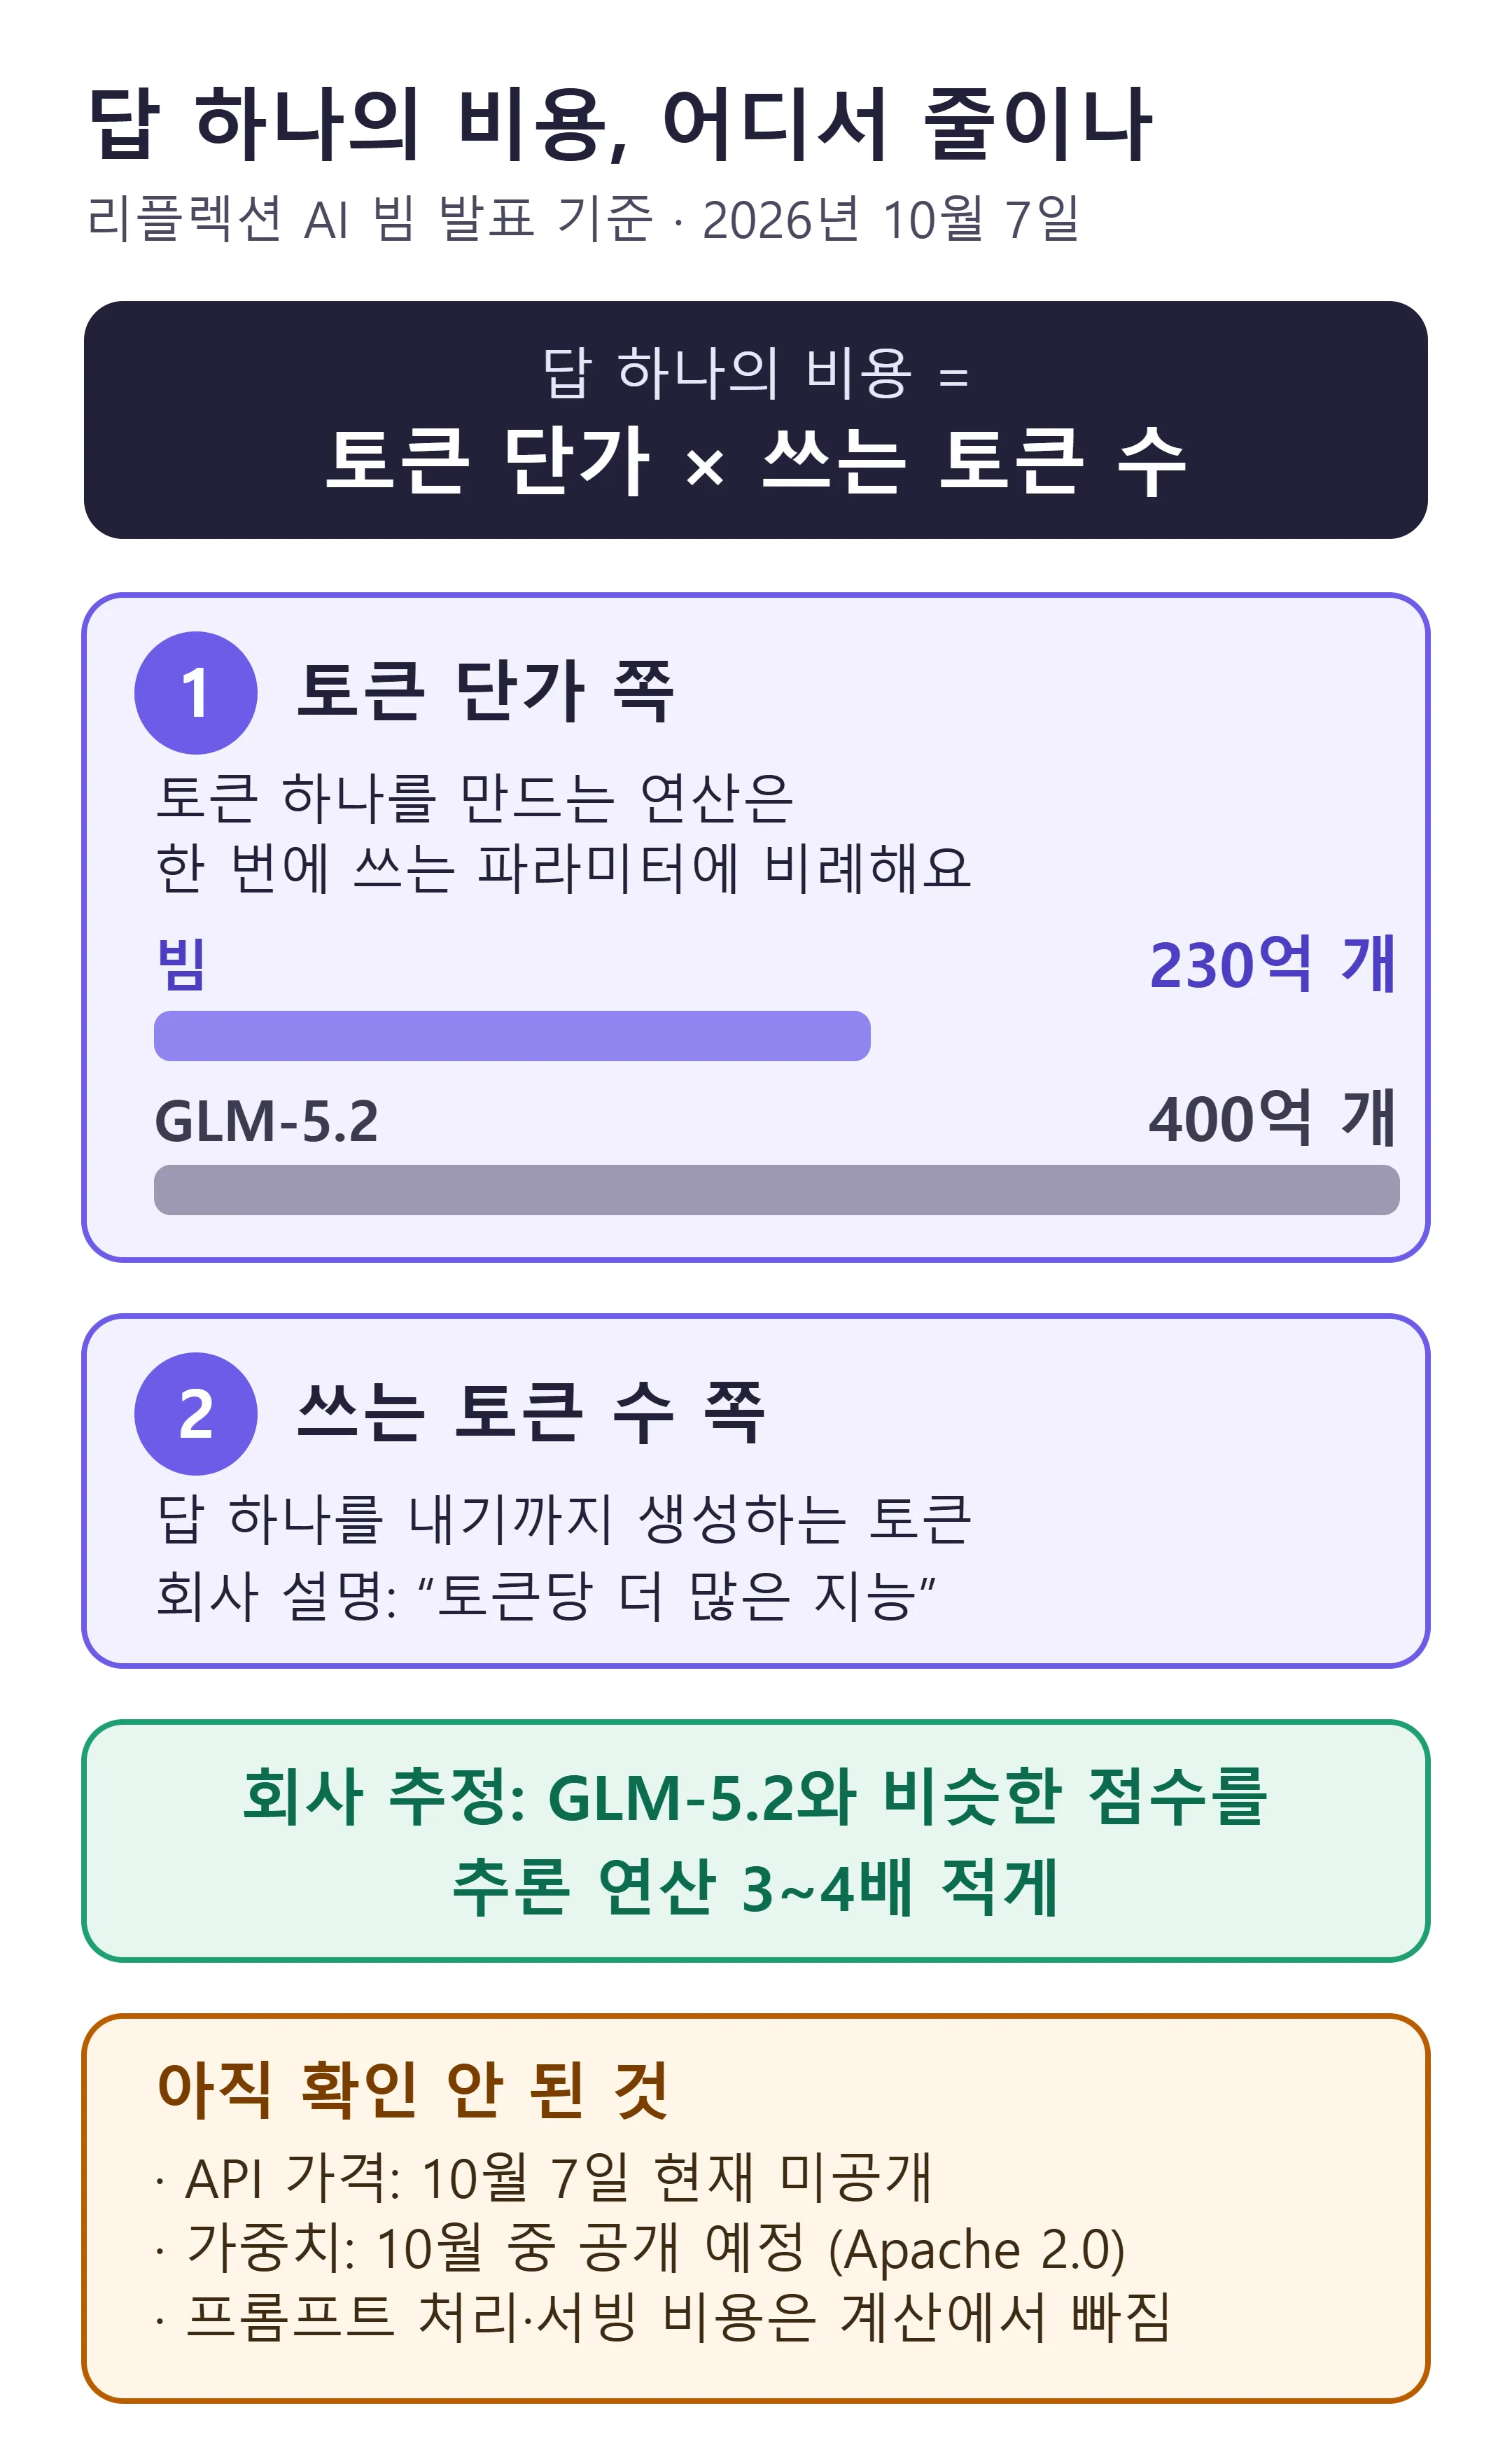
답 하나의 비용을 토큰 단가와 쓰는 토큰 수로 나눠 본 리플렉션 빔의 효율 주장과 아직 확인 안 된 것 (직접 제작)
토큰 단가로 한 달 API 비용을 직접 계산하는 법은 이 글에 정리해 뒀어요.
→ OpenAI API 비용, 한 달 요금 계산법 (2026년 10월)
5. 오픈웨이트가 기업에 중요한 이유
오픈웨이트는 학습을 마친 모델의 가중치 파일을 내려받아 직접 돌릴 수 있게 공개한 모델이에요. 가중치는 모델이 학습으로 얻은 숫자 덩어리, 비유하면 레시피와 비법 소스예요. 학습 데이터까지 공개한다는 뜻은 아니에요. 빔도 웹 데이터와 함께 라이선스를 받은 비공개 데이터로 학습했다고 밝혔어요.
로봇 요리사가 레시피 책과 비법 소스를 작은 가게 주인에게 건네는 장면 — 오픈웨이트 공개를 빗댄 그림 (GPT 이미지 생성)
API로만 쓰는 모델과 비교하면, 회사 입장에서 달라지는 점은 이래요.
| 따져 볼 점 | 오픈웨이트에서 달라지는 것 |
|---|---|
| 데이터 위치 | 자체 서버나 고른 클라우드에서 돌려, 데이터를 모델 회사로 보내지 않을 수 있음 |
| 맞춤 | 우리 데이터로 추가 학습(미세조정)해 업무에 맞출 수 있음 |
| 공급처 | 같은 모델을 여러 클라우드에서 쓸 수 있어 값을 비교하고 한 회사에 덜 묶임 |
| 비용 구조 | 토큰당 요금 대신 GPU 서버 비용. 빔은 파라미터 하나를 1바이트로 잡아도 가중치만 500GB가 넘음 |
| 라이선스 | Apache 2.0은 복제·수정·재배포·상업적 사용을 허용. 라이선스 사본과 고지를 남기는 조건 |
라스킨 대표도 2025년 TechCrunch 인터뷰에서 이렇게 말했어요. “대기업이 되면 기본적으로 오픈 모델을 원합니다. 소유권을 갖고, 맞춤으로 고칠 수 있는 것을요.” 다만 실제 도입 전에는 가중치와 함께 나올 모델 카드와 라이선스 원문을 직접 읽고, 회사 규정에 맞는지 법무·보안 담당과 확인하는 게 순서예요.
6. 검증과 비판: 아직은 회사 숫자뿐
TechCrunch는 리플렉션의 성능 주장이 독립적으로 검증되지 않았다고 짚었어요. 가중치도 아직 공개 전이라, 외부에서 직접 돌려 볼 수 없어요.
회사가 낸 비교표를 자세히 보면 ‘비슷한 점수’라는 말이 정확해요. 몇몇 항목은 GLM-5.2보다 낮고, 더 새 중국 모델들과는 차이가 커요. 회사 발표 표에서 몇 줄을 옮기면 이래요.
| 평가 (재는 것) | 빔과 비교 모델 점수 |
|---|---|
| Terminal Bench v2.1 (터미널 작업) | 빔 80.1 · GLM 5.2 81.0 · Kimi K3 88.3 |
| HLE 도구 없이 (고난도 지식) | 빔 36.2 · GLM 5.2 40.5 · Kimi K3 46.9 |
| GPQA Diamond (과학 추론) | 빔 90.5 · GLM 5.2 91.2 · Kimi K3 93.5 |
| DeepSWE v1.1 (실전 개발) | 빔 44.4 · GLM 5.2 44.0 · DeepSeek V4.1 Flash 74.2 |
| SWE-bench Verified (코드 수정) | 빔 80.9 · Inkling 77.6 · Nemotron 3 Ultra 70.7 (GLM·Kimi 점수 없음) |
The Decoder도 “Kimi K3 같은 더 강한 오픈 모델이 순수 성능에서는 여전히 앞선다”고 정리했어요. 빔이 내세우는 건 최고 점수가 아니라 점수 대비 연산이에요.
외부 검증은 시작됐어요. 벤치마크 업체 Artificial Analysis는 리플렉션에게 접근권을 받아 독립적으로 평가하는 중이라며, 10월 5일 X에 “초기 지표로는 지능 수준 대비 가장 토큰 효율적인 오픈 모델 중 하나가 될 것”이라고 남겼어요(보도 기준). 아직 점수는 내지 않았어요. 효율 주장은 가중치와 외부 점수가 나온 뒤에 판단하는 게 맞아요. 회사가 밝힌 공개 시점은 10월 중이에요.
7. 무슨 뜻인가: 토큰 단가 경쟁
서방 오픈웨이트가 ‘가장 높은 점수’ 대신 ‘같은 일을 더 적은 토큰과 연산으로’ 승부하기 시작했어요. happy_various는 이걸 토큰 단가 경쟁의 국면으로 봐요. 점수는 중국 최신 모델이 앞서 있으니, 같은 품질을 더 싸게 내는 쪽으로 싸움터를 옮긴 거예요.
도입을 맡은 분이라면 볼 곳도 바뀌어요. 벤치마크 순위표보다, 우리 일 한 건에 드는 비용을 재는 습관이 더 쓸모 있어져요.
① 우리 업무 예시 10건으로 모델마다 입력·출력 토큰 수를 재기
② 같은 모델이 여러 클라우드에 올라오면 100만 토큰당 단가를 나란히 비교하기
③ 데이터를 어디서 처리하는지, 라이선스가 우리 쓰임을 허용하는지 확인하기
② GLM-5.2급 점수에 연산은 3배에서 4배 적다는 주장
③ 가중치·Apache 2.0은 10월 중, 가격은 미공개
④ 독립 검증 전 — 외부 점수가 나온 뒤 판단
오늘의 큰 흐름: 유럽·서방 오픈웨이트 체급 경쟁. 하루 뒤인 10월 6일에는 프랑스 미스트랄도 대형 모델 Large 4를 내놓으며 가중치 공개를 예고했어요.
자주 묻는 질문
Q. 지금 바로 빔을 쓸 수 있나요?
10월 7일 현재는 리플렉션의 조기 접근 신청을 거친 API만 있어요. 가중치는 10월 중 공개 예정이고, API 가격은 아직 발표되지 않았어요.
Q. 개인 PC에서 돌릴 수 있나요?
어려워요. 한 번에 230억 개만 계산하지만 5,010억 개 전체를 메모리에 올려야 해서, 파라미터 하나를 1바이트로 잡아도 500GB가 넘어요. 보도 기준으로 가정용 장비 안내나 압축판도 아직 없어요.
Q. 2024년 ‘리플렉션 70B’ 논란과 같은 회사인가요?
아니에요. 리플렉션 70B는 2024년 9월 미국 스타트업 하이퍼라이트(HyperWrite)가 낸 모델로, 공개 뒤 외부 평가에서 발표만큼의 점수가 나오지 않아 논란이 됐어요. 빔은 딥마인드 출신이 세운 리플렉션 AI의 모델이에요. 이름만 비슷해요.
참고 자료
- 리플렉션 AI — 빔 소개(10월 5일) · reflection.ai/blog/introducing-beam
- TechCrunch — Reflection debuts Beam(10월 5일) · techcrunch.com
- Apache License 2.0 원문 · apache.org/licenses/LICENSE-2.0
리플렉션 공식 발표와 TechCrunch 등 보도
직접 써 본 후기 아님 · 수치는 회사 발표
라이선스 설명은 법률 판단 아님
제휴 없음 · 리플렉션 AI와 관계없음
캐릭터는 GPT 생성, 도식은 직접 제작
부록: 출처 전체 (2026-10-07 확인)
- 리플렉션 AI — Introducing Beam, 2026-10-05 — 501B·23B 활성 MoE, 23.8조 토큰, 강화학습 규모, GLM-5.2 대비 3~4배 적은 추론 연산(계산식과 단서), 벤치마크 표, 가중치·기술 보고서·모델 카드 이달 중 공개, Apache 2.0
- TechCrunch, 2026-10-05 — 텍스트 전용, 100만 토큰, GLM-5.2 744B·40B 활성, 독립 검증 안 됨
- The Decoder, 2026-10-06 — Kimi K3 등이 순수 성능은 앞섬
- TechCrunch, 2025-10-09 — 창업자, 20억 달러 투자, 라스킨 인터뷰
- Implicator, 2026-10-05 — Artificial Analysis의 10월 5일 X 글 인용
- Apache License 2.0 — 허용 범위와 재배포 조건
- TechNews, 2024-09-11 — 하이퍼라이트 ‘리플렉션 70B’ 성능 논란