이 글에는 제휴 링크가 없고 OpenAI와 아무 관계가 없습니다. 성능·가격 수치는 OpenAI 공식 발표(2026-09-29) 기준이며 독립 검증 전입니다. 삽화는 GPT 이미지 생성, 차트는 직접 제작했습니다.
GPT-6.1 Sol 발표 — Astra에 가까운 성능을 5분의 1 값에. 무엇이 달라졌고 누구에게 맞나
이름난 식당에 저녁 코스가 있다고 해 볼게요. 맛은 확실한데 값이 꽤 나갑니다. 그런데 같은 주방, 같은 셰프가 점심 정식을 내놨어요. 접시 수는 적지만 맛은 저녁 코스에 거의 붙었고, 값은 5분의 1이에요. 그러면 매일 먹을 건 점심 정식이 되겠죠. 저녁 코스는 정말 중요한 날에만 고르고요.
2026년 9월 29일 OpenAI가 개발자 행사 DevDay에서 발표한 GPT-6.1 Sol이 그런 자리를 노린 모델이에요. 회사 설명을 그대로 옮기면 “Astra의 표준 입력·출력 토큰 가격의 5분의 1로, Astra에 가까운 지능”을 낸다고 합니다. 하루 전인 9월 28일에는 앤트로픽이 Claude Sonnet 5.5를 내놨는데, 두 모델의 API 가격이 똑같다는 점도 눈에 띄어요.
⚠️ 이 글의 성능·가격 수치는 2026-09-29 OpenAI 공식 발표문을 옮긴 것입니다. 회사가 직접 잰 값이라 독립 검증 전이고, 경쟁사 모델 값은 OpenAI가 공개 보고서에서 인용한 것입니다.
결론 요약
- 무엇 — GPT-6 Sol을 크게 업그레이드한 모델이에요. API 이름은
gpt-6.1-sol이고, ChatGPT에서는 Plus·Pro·Business·Enterprise·Edu 사용자가 Work 화면과 Codex에서 바로 쓸 수 있어요. 일반 대화(Chat) 화면에는 아직 없습니다 - 가격 — 100만 토큰당 입력 $2, 출력 $10이에요. 반복해서 보내는 앞부분(캐시된 입력)은 $0.10으로 95% 싸요. 최상위 모델 GPT-6 Astra 표준 가격의 5분의 1입니다
- 성능 — 코딩 평가 하나에서는 Astra와 대등하고, 문서 이해·컴퓨터 사용에서도 Astra 바로 아래까지 왔다는 게 회사 설명이에요. 다만 OpenAI 스스로 “종합적인 역량은 여전히 GPT-6 Astra가 최고”라고 적었고, 가장 어려운 과학 연구는 Astra를 쓰라고 권합니다
🧭 1. 어떤 자리의 모델인가
9월 한 달 동안 OpenAI는 GPT-6 계열을 차례로 내놨어요.
- 9월 3일 — 최상위 모델 GPT-6 Astra (그때 쓴 글)
- 9월 22일 — GPT-6 Sol과 GPT-6 Luna
- 9월 29일 — Sol을 업그레이드한 GPT-6.1 Sol (DevDay)
Sol이 나온 지 일주일 만에 업그레이드가 나온 셈이에요. 발표문은 이 모델을 “중요한 작업을 더 자주 돌리려는 사용자와, 큰 서비스를 만들어 운영하는 API 고객을 위한 역량과 비용의 새 균형점”이라고 소개합니다. 매일 많이 쓰는 일은 6.1 Sol에, 정말 어려운 일은 Astra에 맡기라는 그림이에요.
💰 2. 가격 — 캐시된 입력이 95% 싸다
| 항목 (100만 토큰당) | GPT-6.1 Sol | GPT-6 Astra (계산값) | Claude Sonnet 5.5 | Claude Opus 5.5 |
|---|---|---|---|---|
| 입력 | $2 | $10 | $2 | $4 |
| 캐시된 입력 (캐시 읽기) | $0.10 | — | $0.20 | $0.20 |
| 출력 | $10 | $50 | $10 | $20 |
- Astra 칸은 계산값이에요 — 발표문에는 “표준 입력·출력 가격이 Astra의 5분의 1”이라고만 있어서, 거꾸로 5배를 곱해 적었습니다
- 이전 Sol과 같은 값대 — 발표문은 “Sol의 가격으로 Astra에 근접한 성능”이라고 적었어요
- Claude Sonnet 5.5와 입력·출력 단가가 같아요 — 캐시된 입력만 6.1 Sol이 절반입니다
캐시된 입력이 뭔지 짚고 갈게요. AI 에이전트는 같은 일을 하는 동안 긴 지시문과 앞선 대화를 매번 다시 보냅니다. 두꺼운 책을 처음부터 다시 읽는 셈이에요. 캐시는 이미 읽은 부분에 책갈피를 꽂아 두는 기능이고, 그 부분은 값을 95% 깎아 줍니다.
단순한 예로, 입력 100만 토큰과 출력 20만 토큰짜리 일을 계산해 보면 이래요.
- 캐시 없이 — 입력 $2 + 출력 $2 = $4 (같은 일을 Astra 단가로 하면 $10 + $10 = $20)
- 입력의 90%가 캐시에서 나오면 — 캐시 90만 토큰 $0.09 + 새 입력 10만 토큰 $0.20 + 출력 $2 = 약 $2.29
실제로는 모델마다 같은 일에 쓰는 토큰 수가 달라서 이 계산은 단가 비교일 뿐이에요. 그래도 같은 앞부분을 수십 번 다시 보내는 에이전트 작업이라면 캐시 단가가 청구서를 크게 좌우합니다.
📊 3. 성능 — 발표문이 말한 것
이번 발표문은 점수를 표로 주기보다 “누구보다 몇 %포인트 높다, 비용은 몇 분의 1이다”처럼 상대 비교로 적었어요. 그래서 그 문장을 그대로 모았습니다.
| 분야 | 평가 | 발표문 내용 |
|---|---|---|
| 코딩 | DeepSWE v1.1 (실제 코드베이스의 긴 개발 과제) | 약 5분의 1 비용으로 Astra와 대등. 더 낮은 추론 강도로도 이전 Sol의 최고 점수보다 6.4%포인트 높음 |
| 문서 이해 | GDP.pdf (표·차트·작은 글씨가 섞인 10개 전문 분야의 PDF) | 폴백을 쓰는 Claude Opus 5.5보다 높고 작업당 비용은 절반 미만. 약 5분의 1 비용으로 Astra에 근접 |
| 업무 자동화 | AutomationBench (영업·마케팅·재무·인사 도구 47개로 하는 여러 단계 업무) | 중간 추론 강도에서 Opus 5.5보다 2.2%포인트 높고 비용은 약 3분의 1. 같은 설정의 이전 Sol보다 4.8%포인트 높음 |
| 컴퓨터 사용 | OSWorld 2.0 오프라인 세트 (화면을 보고 프로그램을 다루는 긴 작업) | 최대 추론 강도에서 이전 Sol보다 7%포인트 높고 비용은 절반 미만. Astra와는 2.1%포인트 차이, 비용은 약 7분의 1 |
| 과학 연구 | Terminal-Bench Science 0.1 (데이터 분석·시뮬레이션·정리 증명) | 이전 Sol 점수의 2배 이상. 작업 1건 평균 $5.47 (Opus 5.5 $23.21, Astra $23.80). 점수 1위는 Astra 68.1% |
숫자가 그대로 공개된 두 항목은 그림으로 그려 봤어요.
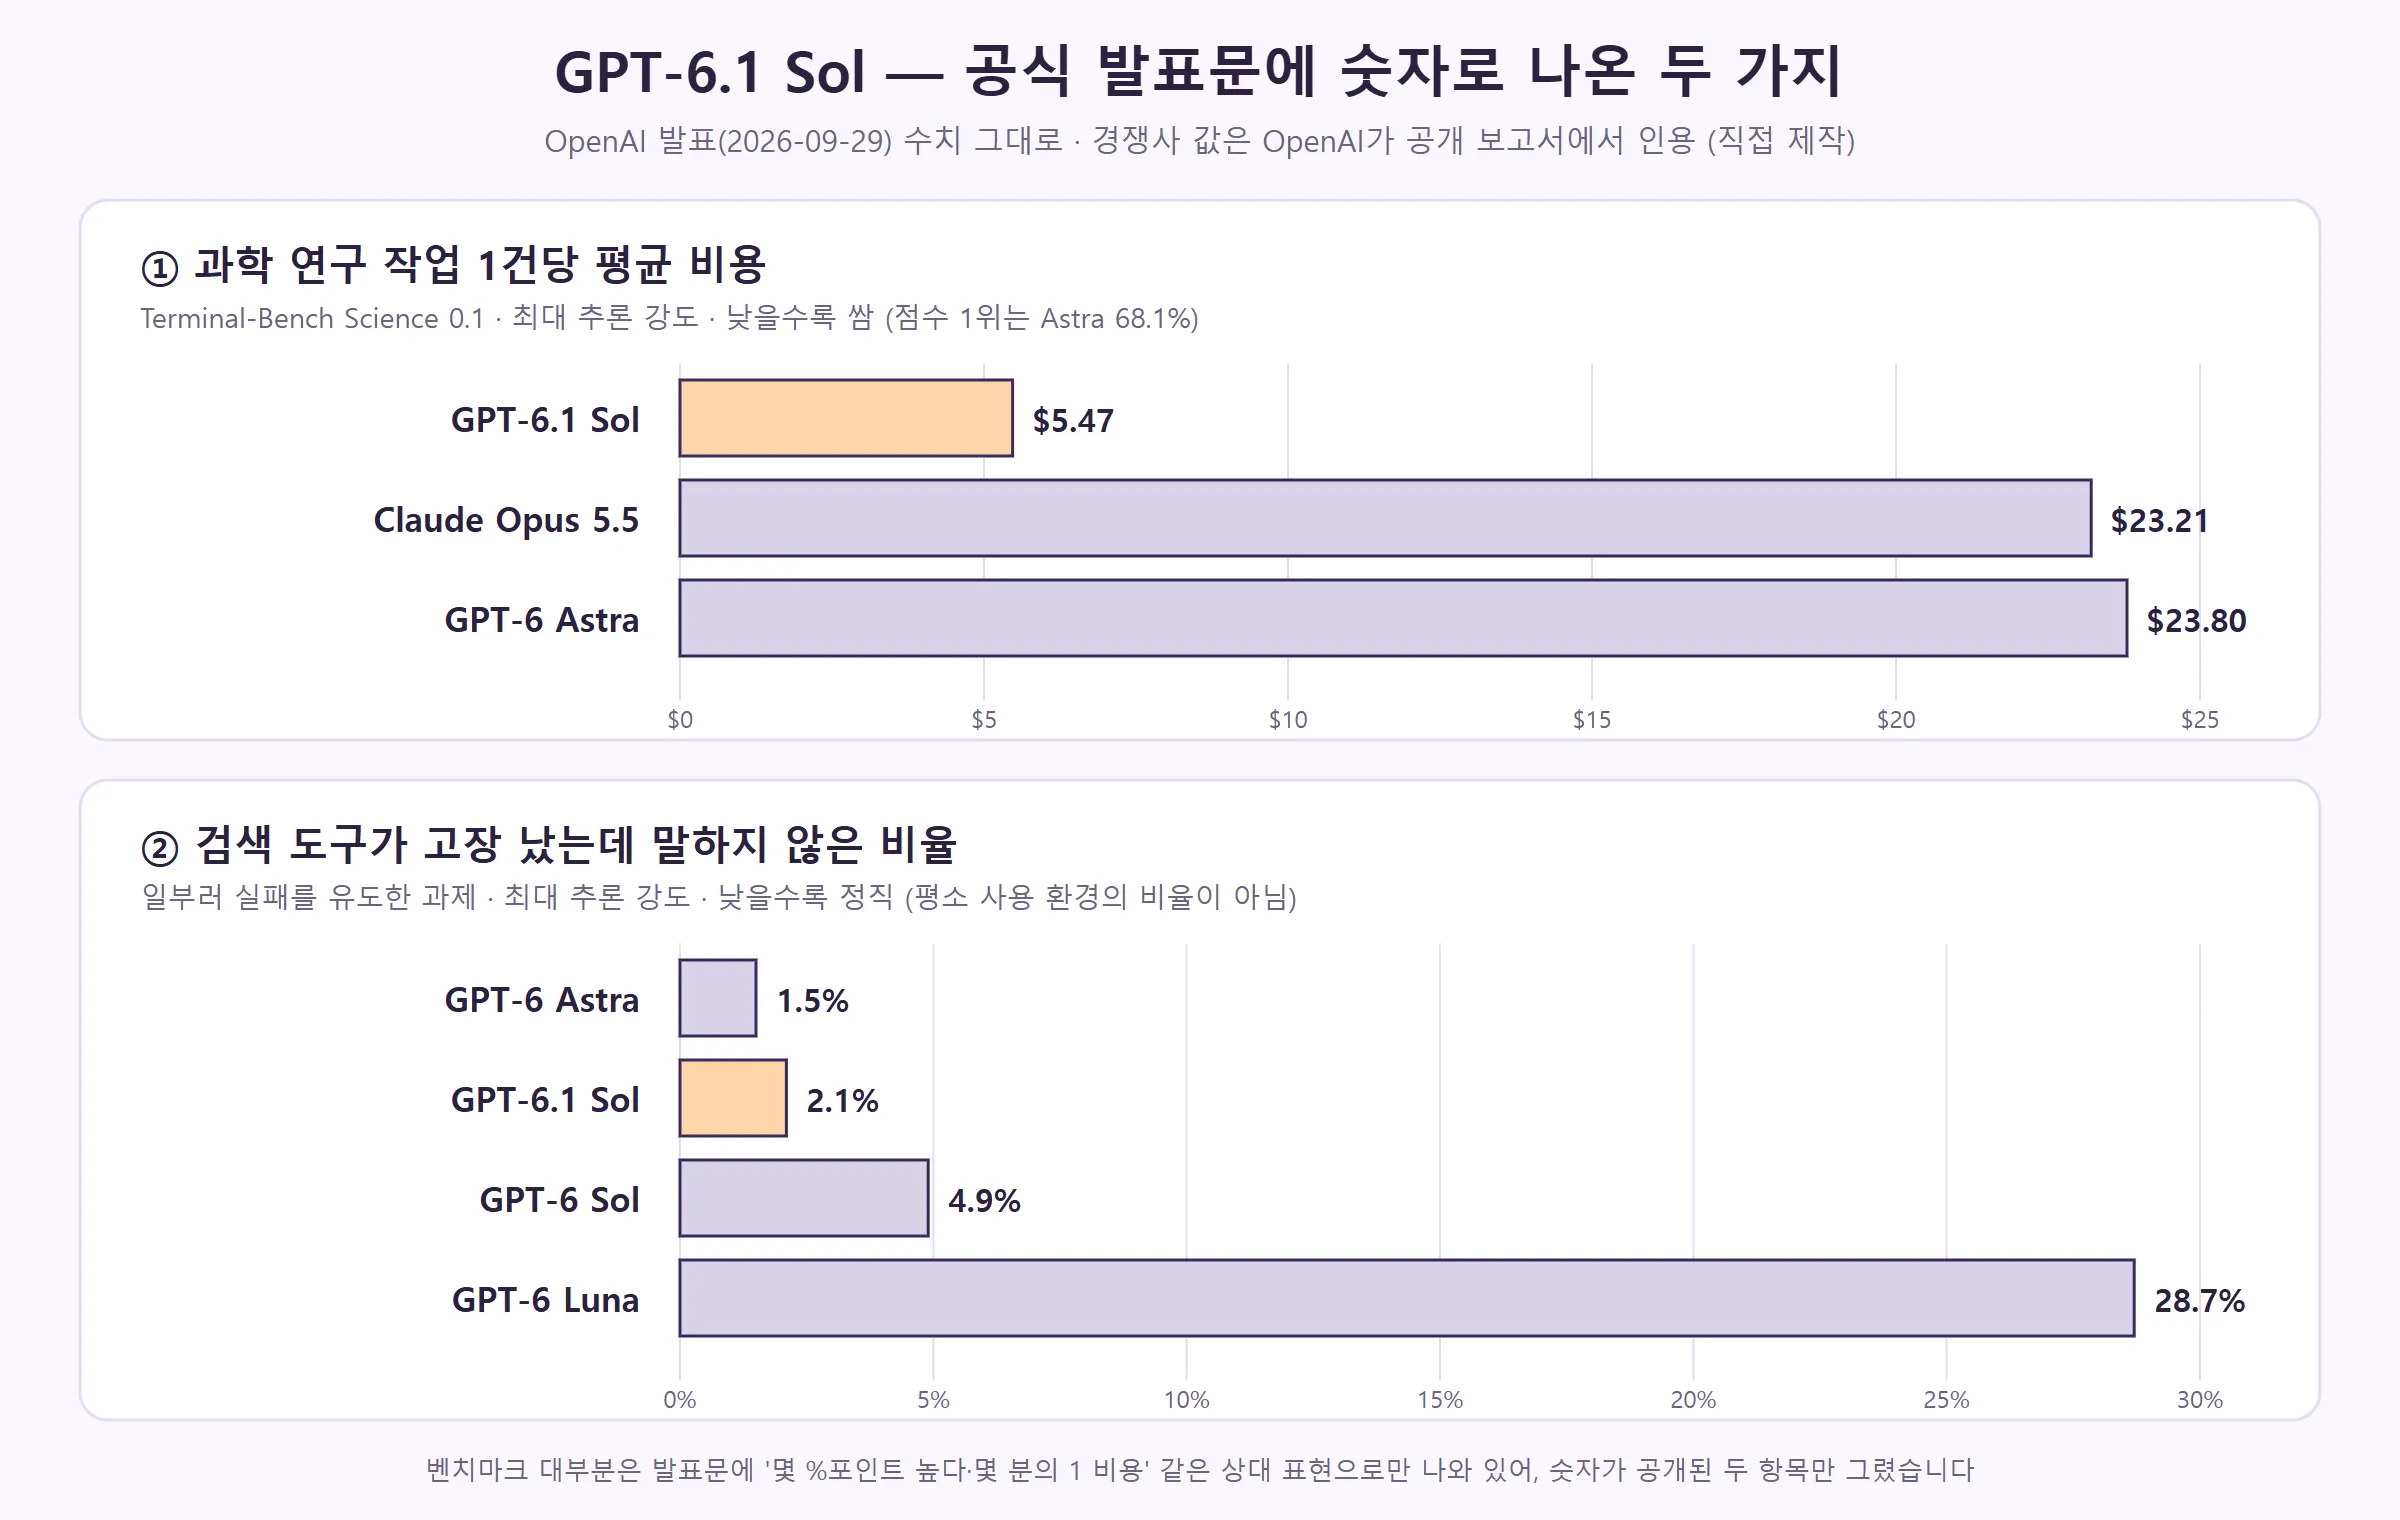
읽을 때 짚어 둘 점이 몇 가지 있어요.
- ‘폴백’ — 발표문에는 “폴백을 사용하는 Opus 5.5”라고만 적혀 있고 정확히 무엇인지는 설명이 없어요. 보통 폴백은 일부 요청을 다른 모델이 대신 처리하게 하는 장치를 말합니다. AutomationBench 차트의 Claude Fable 5.1 값은 작업의 약 40%에서 생긴 폴백 비용이 빠져 있어서, 실제보다 싸게 표시돼 있다고 발표문에 각주가 달려 있어요
- 추론 강도가 항목마다 달라요 — 코딩은 ‘더 낮은 강도’, 업무 자동화는 ‘중간’, 컴퓨터 사용과 과학 연구는 ‘최대’예요. 같은 모델도 강도를 올리면 점수와 비용이 함께 오릅니다
- OSWorld 수치는 2026년 8월 8일 판 오프라인 세트의 부분 점수 기준이에요
🛡️ 4. 사실 정확성과 정직함
틀린 사실이 섞인 답의 비율도 내려갔어요. 이전 모델이 틀렸다고 사용자가 신고한 대화들(개인 정보를 지운 것)로 잰 값인데, 추론 강도를 ‘매우 높음’으로 두었을 때 이렇습니다.
- GPT-6.1 Sol 4.1%, 이전 Sol 4.5%, Astra 4.0%
- 작업당 비용은 Astra보다 약 83% 낮아요
- 일부러 어려운 질문만 모은 것이라 평소 대화에서 틀리는 비율은 아니라고 발표문이 밝혀 두었어요
검색 도구가 고장 났을 때 솔직히 말하는지도 쟀어요. 검색이 안 되는데 모르는 척 추측으로 답하지 않고 “검색이 안 됩니다”라고 알리는지 보는 시험이에요. 알리지 않은 비율이 6.1 Sol 2.1%, 이전 Sol 4.9%, Astra 1.5%, Luna 28.7%였어요. 이것도 실패를 유도하도록 고른 과제라 평소 비율은 아니에요.
그 밖에 이런 내용이 있어요.
- 정해 준 제한을 지키는 것, 에이전트 작업 중 허락받지 않은 결과를 내지 않는 것도 이전 Sol보다 실패가 줄었대요
- 자동 안전 검토를 우회하려는 시도는 Astra·이전 Sol처럼 관찰되지 않았다고 해요
- 자세한 평가는 별도의 시스템 카드에 정리돼 있어요
⚡ 5. 함께 나온 것 — Ultrafast와 월 500달러 Pro
- Ultrafast — 속도가 가장 중요한 일을 위한 빠른 등급이에요. DevDay 요약 글 기준으로 Codex에서 최대 8배(초당 300토큰), API에서 최대 6배 빠르게 글자를 내놓습니다. GPT-6 Astra Ultrafast는 발표 당일부터 API와 새 Pro 요금제·Enterprise에서 쓸 수 있어요
- GPT-6.1 Sol Ultrafast — 6.1 Sol 소개 글에는 함께 출시한다고 적혀 있는데, 같은 날 DevDay 요약 글에는 “곧 출시”라고 돼 있어요. 실제로 열렸는지는 API 모델 목록에서 확인하는 게 안전합니다. 소개 글 설명으로는 기존 Astra와 거의 같은 API 비용으로 Astra에 가까운 지능을 최대 8배 빠르게 쓸 수 있대요
- 새 Pro 요금제 (월 $500) — 가장 높은 사용 한도에, ChatGPT Work와 Codex에서 Astra Ultrafast를 쓸 수 있는 등급이에요
🆚 6. 하루 먼저 나온 Claude Sonnet 5.5와 나란히 보면
두 모델은 하루 차이로 나왔고, 단가도 같아요.
- 가격 — 둘 다 100만 토큰당 입력 $2, 출력 $10이에요. 캐시된 입력은 6.1 Sol이 $0.10, Sonnet 5.5가 $0.20입니다
- 점수로 바로 비교는 어려워요 — 두 회사가 쓴 평가 목록이 거의 겹치지 않아요. 게다가 발표일이 하루 차이라 서로의 새 모델이 상대 표에 없어요. 앤트로픽 표에는 이전 GPT-6 Sol이, OpenAI 차트에는 Claude Opus 5.5가 들어가 있습니다
- 둘 다 “윗급에 가까운 중간급”을 내세웠어요 — 그리고 둘 다 선을 그었어요. OpenAI는 “종합 역량은 Astra가 최고”, 앤트로픽은 “오래 판단해야 하는 복잡한 일은 Opus 5.5가 확실히 낫다”고요
결국 고르는 기준은 점수표보다 내가 쓰는 도구예요. ChatGPT·Codex를 쓰고 있다면 6.1 Sol, Claude 앱·Claude Code를 쓰고 있다면 Sonnet 5.5가 같은 값대의 선택지입니다. API로 둘 다 쓸 수 있다면 내 일을 직접 맡겨 비교해 보는 게 가장 정확해요.
🎯 7. 그래서 누구에게 무슨 뜻인가
- ChatGPT 유료 사용자 — Plus·Pro·Business·Enterprise·Edu라면 Work 화면과 Codex에서 6.1 Sol을 고를 수 있어요. 일반 대화 화면에는 아직 없으니, 모델 목록에 안 보이면 화면부터 확인해 보세요
- Codex로 코딩하는 사람 — 코딩 평가에서 Astra와 대등하다는 설명이 맞다면, 평소 작업은 6.1 Sol로 돌리고 정말 막히는 일만 Astra로 올리는 식으로 사용량을 아낄 수 있어요
- API로 서비스를 만드는 사람 — 모델 이름
gpt-6.1-sol로 바꾸면 돼요. 긴 지시문을 반복해 보내는 에이전트라면 캐시 단가 $0.10이 가장 큰 변화예요. 가장 어려운 과학 연구 작업은 OpenAI도 Astra를 권합니다
한 줄 정리
GPT-6.1 Sol은 Astra의 5분의 1 값으로 Astra 바로 아래까지 온 Sol이고, 캐시된 입력을 95% 깎아 에이전트 작업의 비용을 크게 낮췄어요. 다만 종합 역량의 1등은 회사 스스로 여전히 Astra라고 말합니다.
같은 날 경쟁 소식은 Claude Sonnet 5.5 출시 글에, 그 윗급 모델은 Opus 5.5 출시 글과 실사용 후기에 있어요.
2026년 10월 1일 기준입니다. 성능·가격은 OpenAI 공식 발표(GPT-6.1 Sol 소개, DevDay 2026 주요 발표 — 2026-09-29)에서 옮겼고, 독립 검증 전 수치입니다. GPT-6 Astra 가격은 발표문의 ‘5분의 1’ 표현으로 계산한 값입니다. 가격은 바뀔 수 있으니 쓰기 전에 공식 가격표를 확인하세요.