목차 · 9개
이 글에는 제휴 링크가 없고 구글과 아무 관계가 없습니다. 내용은 구글 블로그·구글 개발자 블로그(2026-10-06)와 허깅페이스 모델 카드·구글 딥마인드 모델 카드·Gemini API 문서(2026-10-08 확인) 기준이며, 모델과 앱을 직접 써 본 후기는 아닙니다. 성능·속도·메모리 수치는 모두 구글이 잰 것이고 본문에 잰 곳을 각각 적었습니다. 개인정보·보안 규정 준수에 대한 판단은 담지 않았습니다. 삽화는 GPT 이미지 생성, 도식은 직접 제작했습니다.
임베딩젬마 2 정리, 폰 안에서 사진·영상 찾는 구글 검색 모델
임베딩젬마 2 — 폰 안에서 사진·영상을 찾는 구글 검색 모델 (캐릭터는 GPT 이미지 생성)
“사진첩에서 ‘케이크 촛불 끄는 장면’을 말로 찾을 수는 없을까? 그런데 그러려면 사진을 전부 어디 서버에 올려야 하나?” 구글이 10월 6일에 공개한 임베딩젬마 2(EmbeddingGemma 2)가 이 두 번째 질문을 겨냥한 모델이에요.
도서관 사서가 집으로 출장을 왔다고 떠올려 보세요. 책과 사진, 녹음테이프를 도서관으로 실어 가지 않고, 우리 집 책장 앞에서 하나하나에 ‘뜻 주소’ 스티커를 붙여요. 나중에 “바다 사진 어디 있지?” 하고 물으면 그 질문에도 주소를 매겨서, 주소가 가까운 물건부터 꺼내 줘요.
임베딩젬마 2는 글·사진·영상·소리에 같은 뜻 주소를 붙이는 7억 4천만 파라미터 공개 모델이에요. 폰과 노트북 안에서 돌도록 만들어서, 자료를 서버로 보내지 않고 검색하는 앱을 만들 수 있어요.
출장 온 사서 로봇이 집 책장 앞에서 책·사진·테이프에 같은 색 스티커를 붙이는 장면 — 자료는 집 밖으로 나가지 않아요 (GPT 이미지 생성)
① 임베딩과 ‘기기 안 검색’이 무슨 뜻인지
② 폰에서 도는 크기·속도와 그 숫자를 잰 곳
③ 같은 날 나온 나노 바나나 2.1의 가격 변화
2026년 10월 8일 기준 · 구글 발표·문서
1. 무슨 일: 구글이 같은 날 낸 두 모델
2026년 10월 6일 구글 딥마인드가 기기 안에서 도는 검색용 모델 임베딩젬마 2를 공개했어요.
- 가중치를 누구나 내려받을 수 있는 공개 모델이고, 라이선스는 상업적 이용을 허용하는 Apache 2.0이에요. 허깅페이스와 캐글에서 받을 수 있어요.
- 구글은 지난해 나온 1세대가 2,000만 번 넘게 다운로드됐다고 밝혔어요. 1세대는 글만 다뤘고, 2세대는 코드·사진·영상·소리까지 넓혔어요. 바탕은 구글의 공개 모델 젬마 4예요.
같은 날 구글은 이미지 생성·편집 모델 나노 바나나 2.1(Nano Banana 2.1)도 정식 출시했어요. 이쪽은 구글 서버에서 도는 모델이라 성격이 반대예요. 6장에서 짧게 정리해요.
2. 임베딩 뜻: 뜻을 숫자 좌표로
임베딩(embedding)은 글이나 사진의 뜻을 숫자 묶음으로 바꾼 거예요. 임베딩젬마 2는 무엇을 넣든 숫자 768개로 바꿔요.
- 뜻이 비슷한 것끼리는 숫자 묶음도 가깝게 나와요. 그래서 질문을 같은 방식으로 바꾼 뒤 가장 가까운 자료를 고르면 그게 검색이 돼요. 단어가 똑같지 않아도 뜻이 비슷하면 찾아지는 이유예요.
- 임베딩젬마 2는 글·코드·사진·영상·소리를 한 좌표 공간에 놓아요. 구글은 이 덕분에 사진 설명 붙이기, 음성 받아쓰기, 글 임베딩을 모델 여러 개로 이어 붙이던 과정을 줄일 수 있다고 설명해요.
구글이 든 예가 알기 쉬워요. 검색창에 독일어로 “Katze”(고양이)를 치면 고양이 사진이 모이고, “Katze schläft auf Tastatur”(키보드 위에서 자는 고양이)까지 치면 바로 그 사진이 맨 위로 올라와요. 글자를 칠 때마다 결과가 바뀌어요. RAG(검색 증강 생성)는 이렇게 찾은 자료를 AI 답변에 넣어 주는 방식이고, 임베딩은 그중 ‘찾기’를 맡아요.
3. 크기: 필요한 부분만 골라 싣기
임베딩젬마 2는 전체 7억 4천만 파라미터지만, 필요한 부분만 골라 실을 수 있어요.
- 글·코드만 다루면 2억 7천만, 사진을 더하면 4억 4천만, 소리를 더하면 5억 7천만이에요. 어느 조합으로 만든 좌표든 같은 공간이라 서로 비교할 수 있대요.
- 구글이 공개한 기기용(LiteRT) 파일 크기는 이래요.
| 구성 | 파라미터 · 기기용 파일 |
|---|---|
| 글·코드 | 2억 7천만 · 165MB |
| 글·코드 + 사진·영상 | 4억 4천만 · 388MB |
| 전체 (+ 소리) | 7억 4천만 · 485MB |
구글은 픽셀 11 프로에서 양자화(숫자를 더 작은 단위로 줄여 저장)한 모델이 글 전용은 약 191MB, 전체는 약 567MB의 메모리로 돈다고 밝혔어요. 한 번에 넣을 수 있는 길이는 8,192토큰으로 1세대의 4배예요. 구글 설명으로는 소리 5분 30초, 사진 29장, 영상 프레임 58장 분량이에요. 결과 숫자 768개는 512·256·128개로 줄일 수 있어요(마트료시카 표현 학습, MRL). 저장 공간이 최대 6분의 1로 줄어드는 대신 품질이 떨어지는데, 얼마나 떨어지는지는 5장에서 다뤄요.
4. 자료를 밖으로 안 보내는 검색
구글이 앞세운 쓰임은 자료를 기기 밖으로 보내지 않고 찾고 분류하는 앱이에요. 구글이 함께 내놓은 예시는 넷이에요.
① 인스턴트 미디어 검색: 폰의 사진·영상을 글이나 사진으로 찾아요. 자료의 좌표는 폰 안 SQLite 데이터베이스에 저장되고, 구글은 “인터넷 연결이 필요 없다”고 적었어요.
② 비디오 모먼트 파인더: 폰에 있는 영상에서 “아이들이 웃는 장면” 같은 순간을 찾아 시각을 표시해요. 소리를 받아쓰거나 자막을 만들지 않고 바로 찾는대요.
③ 포사이트(Foresight): 맥용 실험 앱이에요. 회의 소리를 들으며 메모를 보강하고 내 파일에서 필요한 내용을 찾아 줘요. 임베딩젬마 2와 생성 모델 젬마 4를 기기 안에서 같이 써요.
④ 결정 엔진: 따로 학습시키지 않고 입력을 분류해 다음 동작을 고르는 기능이에요. 구글 시연에서는 체스 한 수마다 후보 500개를 100밀리초 안에 평가했어요.
①②는 구글 AI 엣지 갤러리 앱(안드로이드·iOS)에서 바로 써 볼 수 있어요. 안드로이드 앱 개발 도구 ML Kit에는 “몇 주 안에” 넣는다고 했어요.
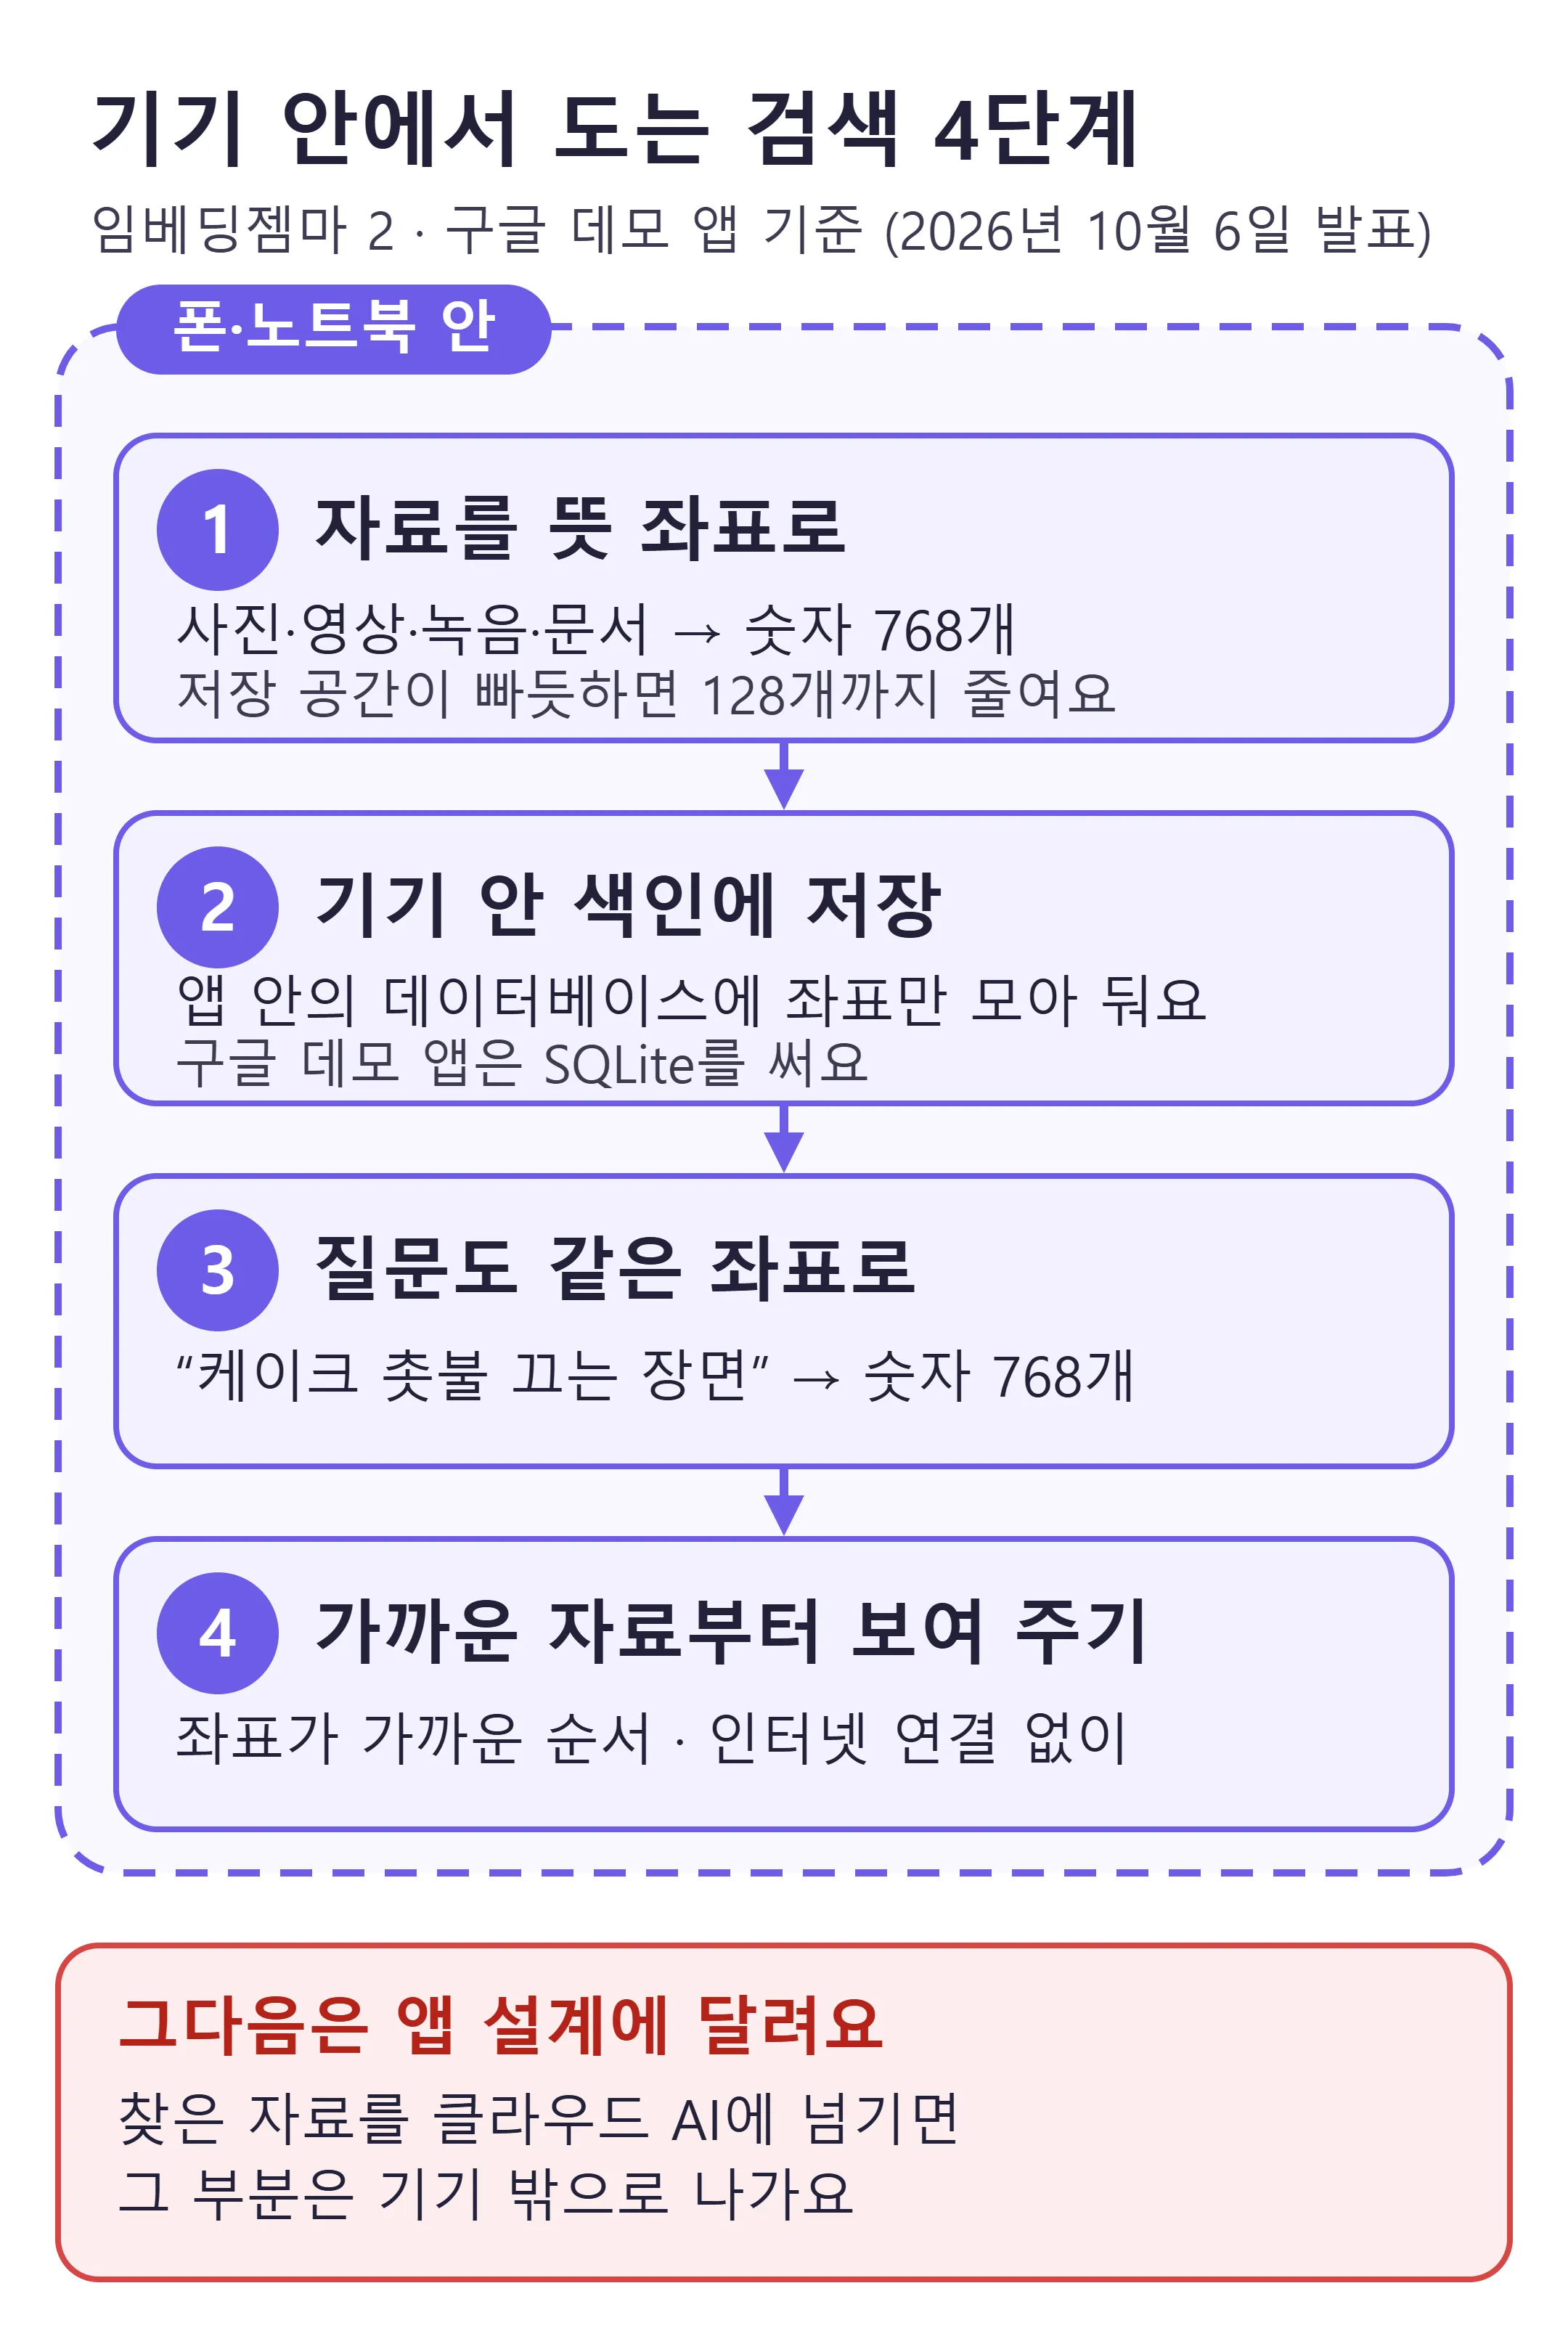
기기 안에서 도는 검색 4단계 — 자료와 질문을 같은 좌표로 바꿔 가까운 것부터 찾고, 그다음 단계는 앱 설계에 달려요 (직접 제작)
happy_various 브리핑은 이걸 “민감한 자료에도 AI 검색을 붙이기 좋아진다”는 신호로 봤어요. 사실 범위로 옮기면 검색 단계를 기기 안에 두는 설계가 쉬워졌다는 거예요. 다만 앱 전체가 기기 안에서 도는지는 앱마다 달라요. 찾은 자료를 클라우드 AI에 넘겨 답을 쓰게 하면, 그 부분은 기기 밖으로 나가요. 개인정보 규정에 맞는지는 이 글이 판단하지 않아요.
5. 검증: 성능 숫자는 누가 쟀나
로봇이 별 메달을 들어 보이는 옆에서, 사람이 자기 사진첩과 초시계로 직접 재 보는 장면 — 회사 점수와 내 자료로 잰 결과 (GPT 이미지 생성)
이 글에 나온 임베딩젬마 2의 성능 숫자는 모두 구글이 잰 거예요. 공개 벤치마크를 썼지만 측정과 발표는 구글이 했어요. 구글 모델 카드의 대표 점수를 옮기면 이래요.
| 평가 (구글 측정) | 임베딩젬마 2 · 1세대 |
|---|---|
| MTEB 다국어 글 검색 | 61.36 · 61.15 |
| MTEB 코드 검색 | 78.68 · 68.76 |
| MIEB 사진 (lite) | 64.64 · 해당 없음 |
| MMEB 영상 | 50.67 · 해당 없음 |
| MAEB 소리 | 49.39 · 해당 없음 |
코드 검색은 9.92점(약 14%) 올랐고, 다국어 글 검색은 1세대와 거의 같아요. 구글이 말하는 ‘크기 대비 최고’는 10억 파라미터 미만 모델끼리 견준 구글의 주장이에요. 10월 8일까지 다른 기관이 다시 잰 결과는 찾지 못했어요.
구글 자료 안에도 그대로 옮기면 안 되는 지점이 적혀 있어요.
① 점수는 원래 정밀도의 모델로 잰 거예요. 모델 카드는 결과가 모두 full-precision 체크포인트 기준이라고 적었는데, 폰에서 도는 건 4비트·8비트로 줄인 모델이에요.
② 좌표를 128개로 줄이면 글·코드는 약 90%, 사진·영상·소리 검색은 약 75% 품질로 떨어진대요. 구글도 내 데이터로 먼저 확인하라고 권해요.
③ 100개 넘는 언어를 다루지만, 모델 카드는 언어마다 성능이 같지 않을 수 있다고 적었어요. 한국어 점수는 따로 없어요.
④ 속도는 구글 AI 엣지 팀이 기기마다 5번 돌린 평균이에요. 글 128토큰 기준 픽셀 11 프로(TPU) 8.3밀리초, 아이폰 18 프로(GPU) 11.6밀리초, S26 울트라(CPU) 27.1밀리초예요.
⑤ 메모리도 재는 법마다 달라요. 블로그는 픽셀 11 프로 글 전용 약 191MB, 기기용 모델 카드는 같은 폰의 CPU 메모리 112MB(가속기 메모리 제외)라고 적었어요.
그래서 지금 할 수 있는 판단은 여기까지예요. 내 자료와 내 기기로 한 번 재 본 뒤에 고르기가 맞아요. 구글 점수를 내 작업의 성적으로 옮기지 마세요.
6. 같은 날 나온 나노 바나나 2.1
나노 바나나 2.1은 구글의 이미지 생성·편집 모델이에요. 10월 6일 Gemini API에서 정식(GA) 버전으로 나왔어요.
- 구글 딥마인드 모델 카드에 따르면 제미나이 3.6 Flash를 바탕으로 했고, 제미나이 앱·검색 AI 모드·AI 스튜디오·Gemini API·구글 광고·Flow·Stitch에 들어가요. 임베딩젬마 2와 달리 구글 서버에서 돌아요.
- 바뀐 점은 1K·2K·4K 화질, 글자·인포그래픽 정확도, 여러 번 고쳐도 인물이 유지되는 일관성, 참고 이미지 최대 14장이에요.
- 10월 8일에 본 API 가격표를 전작 나노 바나나 2와 나란히 놓으면 이래요.
| 항목 (100만 토큰당) | 2.1 · 나노 바나나 2 |
|---|---|
| 입력 (글·이미지) | $1.50 · $0.50 |
| 출력 (글·생각) | $7.50 · $3 |
| 출력 (이미지) | $30 · $60 |
| 1K 이미지 한 장 | $0.0336 · $0.067 |
| 4K 이미지 한 장 | $0.113 · $0.151 |
이미지 출력 단가는 절반이 됐지만 입력은 3배, 글 출력은 2.5배 올랐어요. 4K 한 장은 쓰는 토큰이 2,520개에서 3,780개로 늘어서 25% 정도만 싸졌어요. ‘가격 절반’은 1K·2K 이미지 한 장 기준이에요. 성능 숫자도 구글이 잰 거예요. 모델 카드의 글로 이미지 만들기 ‘전체 선호도’ 점수(Elo)는 구글의 나란히 보기 사람 평가(SxS human eval)로 낸 값이에요. 나노 바나나 2.1(생각 켬) 1050, 나노 바나나 2(생각 켬) 990, 나노 바나나 프로 935예요. 모델 카드는 1K에서 작은 글씨가 흐리고 왼쪽·오른쪽을 헷갈리는 일이 있다는 한계도 함께 적었어요. 나노 바나나 2는 지원 중단 예정(deprecated)으로 바뀌었고, 종료 날짜는 10월 8일 현재 정해지지 않았어요.
7. 무슨 뜻인가: 찾기는 기기 안으로
happy_various는 이번 발표를 ‘기기 안에서 검색·분류를 돌리는 설계가 쉬워졌다’는 신호로 봐요. 무료로 받는 공개 모델이고, 폰 메모리 수백 MB로 돌고, iOS·맥·윈도·리눅스·웹에서 쓰는 도구도 같이 나왔어요(안드로이드 ML Kit은 몇 주 뒤). 클라우드 임베딩 API를 쓰면 자료를 서버로 보내야 하는데, 그 찾기 단계를 기기에 남기는 선택지가 폰에 들어가는 크기로 나온 거예요.
같은 날 나노 바나나 2.1은 반대 방향이에요. 무거운 이미지 생성은 구글 서버에서 하되 한 장 값을 내렸어요. 찾기는 작은 공개 모델로 기기 안에서, 만들기는 서버에서 더 싸게. 같은 회사가 하루에 두 방향을 다 낸 셈이에요.
도입·교육 관점에서 챙길 건 네 가지예요. ① 우리 자료(한국어 문서·사진)로 직접 재 보기 ② 어느 단계까지 기기 안에서 도는지 그려 보기 ③ 좌표 개수를 줄였을 때 품질 확인하기 ④ 라이선스와 기기 메모리 확인하기예요.
② 글·사진·영상·소리를 숫자 768개로 바꿔 찾기
③ 폰 메모리 약 191MB(글)·567MB(전체), 구글 측정
④ 같은 날 나노 바나나 2.1, 이미지 값 절반·입력 3배
오늘의 큰 흐름: 소형 모델 가격전. 찾는 모델은 ‘무료로 내 기기에서’, 그리는 모델은 ‘한 장 값 절반’으로 내려왔어요. 다만 두 쪽 숫자 모두 구글이 잰 거예요.
자주 묻는 질문
Q. 지금 바로 써 볼 수 있나요?
구글 AI 엣지 갤러리 앱(안드로이드·iOS)에 인스턴트 미디어 검색과 비디오 모먼트 파인더가 들어갔고, 맥용 포사이트 앱도 내려받을 수 있어요. 개발자는 허깅페이스·캐글에서 가중치를 받아요.
Q. 한국어도 잘 찾나요?
모델 카드는 100개 넘는 언어를 다룬다고 했지만, 언어마다 성능이 같지 않을 수 있다고 적었어요. 한국어 점수는 따로 공개하지 않았어요. 우리 자료로 직접 확인해야 해요.
Q. 기기 안에서 돌리면 개인정보 걱정이 없어지나요?
그렇게 단정할 수 없어요. 기기 안 검색은 자료를 서버로 보내지 않는 설계를 가능하게 할 뿐이고, 앱이 찾은 내용을 어디로 보내는지는 앱마다 달라요. 규정에 맞는지는 앱 설계와 관련 규정을 따로 봐야 해요.
Q. 나노 바나나 2.1도 폰 안에서 도나요?
아니에요. 제미나이 앱·검색·Gemini API 같은 구글 서비스에서 도는 모델이에요. 이번 발표 중 기기 안에서 도는 건 임베딩젬마 2예요.
찾은 자료를 AI 답변에 붙이는 RAG가 뭔지는 이 글에서 설명했어요.
→ LLM 위키 뜻, 카파시가 제안한 AI 지식 정리법과 RAG 차이
참고 자료
- 구글 블로그 — EmbeddingGemma 2 · blog.google/innovation-and-ai/technology/developers-tools/embeddinggemma-2
- 임베딩젬마 2 모델 카드 · huggingface.co/google/embeddinggemma-2
- 나노 바나나 2.1 모델 카드 · deepmind.google/models/model-cards/nano-banana-2-1
구글 블로그·모델 카드·Gemini API 문서
직접 써 본 후기 아님 · 수치마다 잰 곳 표기
제휴 없음 · 구글과 관계없음
캐릭터는 GPT 생성, 도식은 직접 제작
부록: 출처 전체 (2026-10-08 확인)
- 구글 블로그 — EmbeddingGemma 2: an open, lightweight multimodal embedding model (2026-10-06, 구글 딥마인드) — 7억 4천만 파라미터, Apache 2.0, 젬마 4 기반, 1세대 2,000만 다운로드, 모듈 구성, MRL 최대 6배 절감, 픽셀 11 프로 약 191MB·567MB, 8K 문맥, MTEB 코드 68.76→78.68
- 구글 개발자 블로그 — Bring multimodal semantic search to the edge with EmbeddingGemma 2 (2026-10-06, Google AI Edge·Android ML 팀) — 인스턴트 미디어 검색·비디오 모먼트 파인더·포사이트·결정 작업, 로컬 SQLite, 인터넷 연결 불필요, ML Kit 몇 주 안, QAT INT4·INT8
- 구글 개발자 블로그 — EmbeddingGemma 2: The Developer Guide (2026-10-06) — 270M·440M·570M·740M 구성, 8,192토큰, 차원별 품질(128d 글 약 90%·멀티모달 약 75%)
- 허깅페이스 — google/embeddinggemma-2 모델 카드 (2026-10-08 조회) — 벤치마크 표(full-precision 기준), 100개 넘는 언어와 언어별 성능 차이, 128d 품질 저하 경고
- 허깅페이스 — litert-community/embeddinggemma-2-740m-litert-lm (2026-10-08 조회) — 기기용 파일 크기, 기기별 지연 시간·메모리(5회 평균, 가속기 메모리 제외)
- 구글 딥마인드 — Nano Banana 2.1 모델 카드 (2026-10-06) — 제미나이 3.6 Flash 기반, 배포 채널, 사람 평가 Elo, 알려진 한계
- Gemini API — 릴리스 노트 · 가격 · 지원 중단 일정 (2026-10-08 조회) — 10월 6일 GA, 2.1과 2의 가격, 나노 바나나 2 종료일 미정