이 글에는 제휴 링크가 없고 OpenAI·앤트로픽과 아무 관계가 없습니다. 제가 직접 만든 중계기의 개발 기록을 바탕으로 썼습니다. 삽화는 GPT 이미지 생성, 도식은 직접 제작했습니다.
사람이 판단하고 AI가 만들었다 — 감독과 스태프 (LLM 중계기 개발기)
영화 촬영장을 떠올려 볼게요. 카메라를 미는 사람, 조명을 맞추는 사람, 세트를 짓는 사람, 마이크 막대를 드는 사람이 따로 있습니다. 감독은 그 일을 직접 하지 않아요. 대신 “이 장면으로 가자”, “이건 빼자”, “한 번 더”를 정합니다. 영화가 끝나면 화면 위로 크레디트가 올라가죠. 누가 어떤 일을 했는지 적힌 긴 명단이에요.
제 LLM 중계기의 저장 기록에도 크레디트 같은 줄이 있어요. 작업을 저장할 때 붙이는 메모 맨 끝에 Co-Authored-By: Claude …처럼 함께 쓴 이름을 적는 공동 작성자 꼬리표입니다. 마지막 편에서는 이 꼬리표를 하나하나 세어 봤어요.
이 글은 LLM 중계기 개발기의 33편이자 마지막 편입니다. 지난 32편 「가짜는 진짜를 대신 못 한다」에서는 흉내 낸 AI로 통과한 시험이 실제 환경에서 한 번 돌려 보는 점검을 대신하지 못하는 이유를 이야기했어요. 오늘은 11주 동안 쌓인 기록 전체를 숫자로 펼쳐, 사람과 AI가 각각 무엇을 했는지 돌아봅니다.
결론 요약
- 기록 — 7월 13일부터 10월 1일까지 저장 기록이 394개 쌓였어요. 합치기 기록을 뺀 작업 기록 297개 가운데 214개(72%)에 AI(Claude)가 공동 작성자로 올라 있고, 8월 31일부터는 작업 기록 71개가 모두 그랬습니다
- 나눈 일 — AI는 코드와 시험(0개에서 799개로), 릴리스 노트 77개, 자세한 저장 메모를 썼어요. 사람은 무엇을 만들고 뺄지 정하고, AI의 “고쳤다”를 실제 환경에서 확인하고, 직접 재고, 지킬 규칙을 정했습니다
- 남은 것 — 1편의 세 질문에는 모두 “된다, 다만 생각보다 손이 많이 간다”로 답하게 됐어요. 사용량에 따라 나눠 보내기와 모델 추천은 아직 계획입니다
🎬 1. 11주를 숫자로 — 크레디트를 세어 보다
낱말 두 개만 먼저 짚을게요.
- 본 줄기(main) — 여러 갈래로 나눠 한 작업을 최종으로 모아 두는 줄기예요. 이 글의 숫자는 모두 본 줄기 기준입니다
- 릴리스 노트 — 새 판(버전)을 내놓을 때 “무엇이 바뀌었는지” 적는 안내문이에요
그리고 4편에서 본 것처럼 저장 기록은 두 종류예요. 실제로 무언가를 바꾼 작업 기록, 그리고 따로 한 작업을 본 줄기에 들이는 합치기 기록입니다.
| 항목 | 숫자 | 기준 |
|---|---|---|
| 기간 | 7월 13일 첫 기록 ~ 10월 1일 마지막 기록 | 10월 2일 확인 |
| 저장 기록 | 394개 (작업 기록 297 + 합치기 기록 97) | 10월 2일 확인 |
| 판(버전) | v0.1.0 → v0.1.109 | 10월 1일 v0.1.109 |
| 릴리스 노트 | 77개 (8월 3일 v0.1.32부터 v0.1.109까지) | 10월 2일 확인 |
| 시험(테스트) | 0개 → 48개 → 229개 → 586개 → 799개 | 7월 13일 아침·밤, 7월 21일, 8월 26일, 9월 25일 저장 메모 |
| 품질 검사(게이트) | 첫날 6개 → 지금 12종 | 검사 목록 문서, 10월 2일 확인 |
| 사고 | 36건 | 연재를 준비하며 저장 기록에서 추린 목록, 10월 1일 |
1편에서 “약 11주, 저장 기록 390개”라고 한 숫자는 9월 29일까지의 것이에요. 그 뒤 10월 1일에 마지막 판 v0.1.109와 함께 4개가 더 쌓였습니다.
시험 숫자는 제가 따로 센 값이 아니에요. AI가 저장 메모 끝에 “시험 799개, 798개 통과, 1개 건너뜀”처럼 적어 둔 값을 날짜순으로 옮겼어요. 9월 25일 뒤로는 메모에 전체 수가 적혀 있지 않아서 거기서 멈췄습니다.
📊 2. 주마다 쌓인 기록 — 몰아친 주와 조용한 주
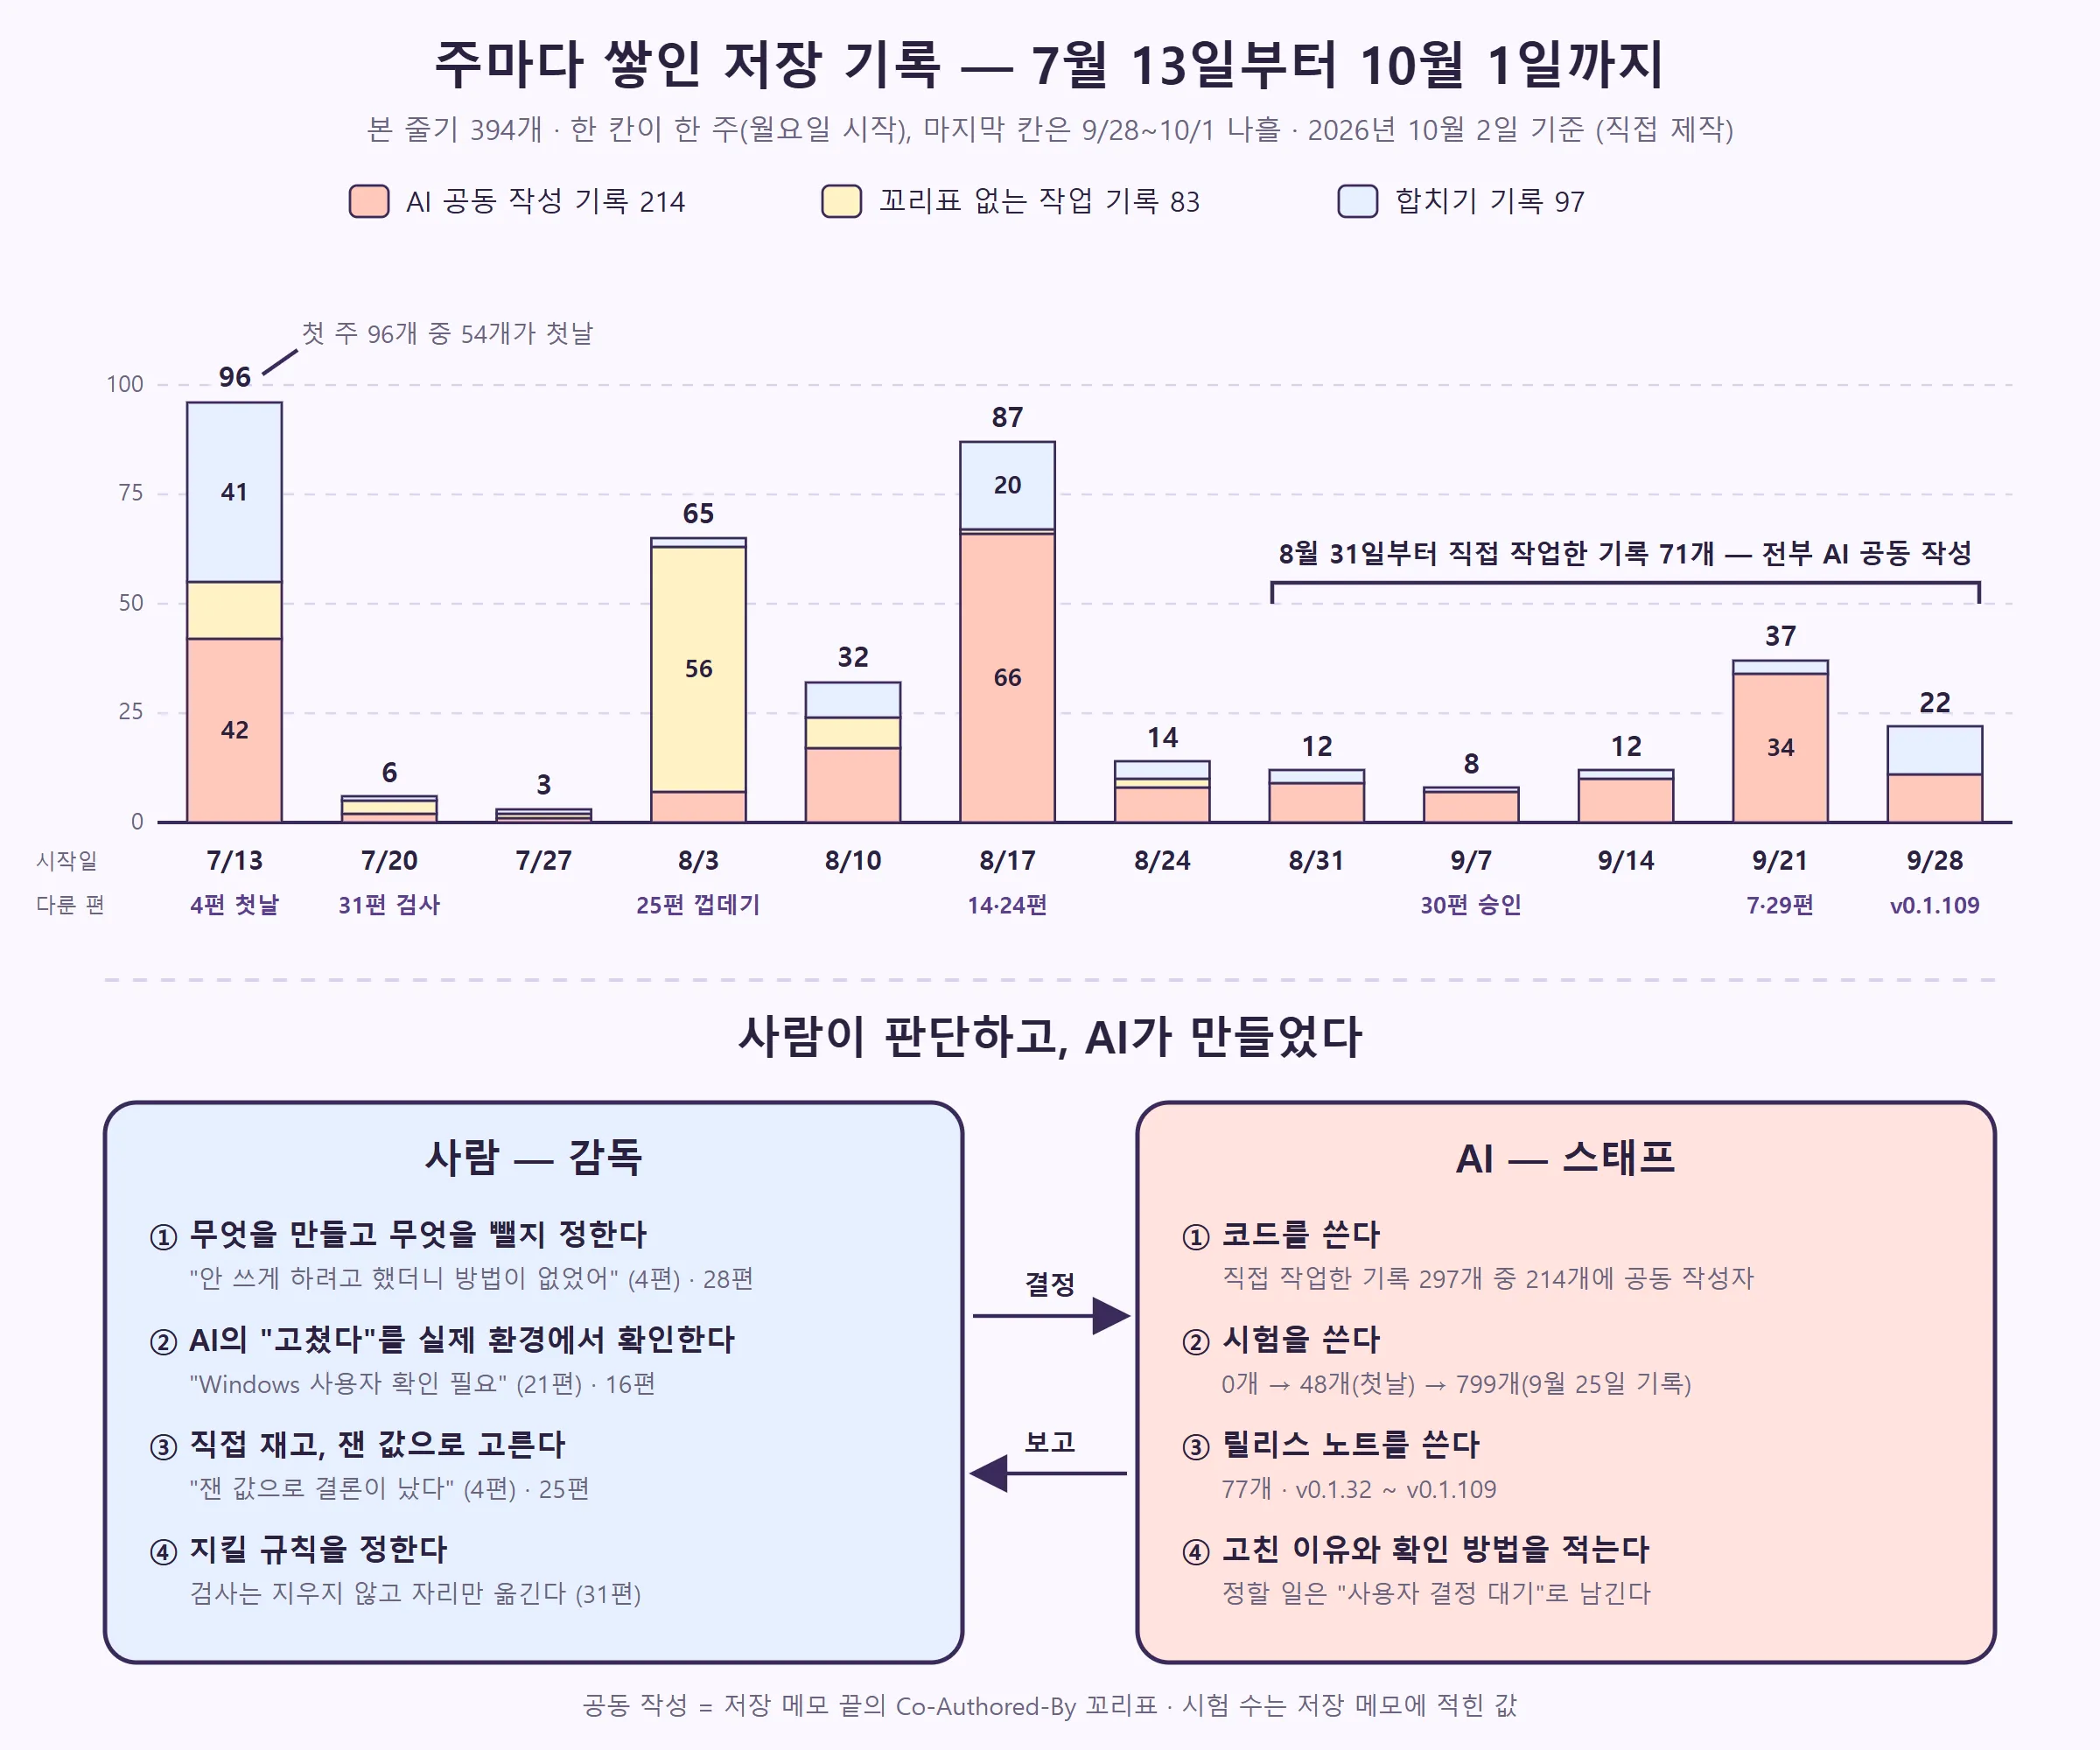
394개를 한 주 단위로 나눠 쌓으면 이렇게 됩니다. 막대 하나가 한 주(월요일 시작)이고, 분홍은 AI가 공동 작성자로 올라 있는 작업 기록, 노랑은 꼬리표가 없는 작업 기록, 하늘색은 합치기 기록이에요. 막대 아래에는 그 주에 있었던 일을 다룬 편을 적어 두었어요.
기록에서 읽히는 것만 적어 볼게요.
- 가장 많은 주는 첫 주(96개)예요. 그중 54개가 첫날 하루에 쌓였어요(4편)
- 둘째·셋째 주는 6개와 3개로 조용했어요
- 8월 첫 주(65개)는 무거운 앱 껍데기를 걷어내고(25편) 자동 업데이트를 새로 붙인(23편) 주예요. 꼬리표 없는 기록 83개 가운데 56개가 이 한 주에 몰려 있어요
- 8월 셋째 주(87개)에는 대화가 섞인 사고(14편)와 조용한 업데이트 사고(24편)를 고쳤어요. 이 주의 작업 기록 67개 중 66개에 꼬리표가 있어요
- 9월 셋째 주(37개)에는 빈 책상(7편)과 고르기만 하는 판정 창구(29편)가 들어갔어요
색의 흐름도 하나 보여요. 뒤로 갈수록 분홍이 막대를 채우고, 8월 31일부터 10월 1일까지 작업 기록 71개는 모두 공동 작성자 꼬리표를 달고 있습니다.
🤖 3. 크레디트에 오른 이름 — AI가 한 일
공동 작성자 꼬리표가 붙은 작업 기록은 297개 중 214개, 약 72%예요. 합치기 기록까지 넣은 394개로 따지면 54%입니다. 한 기록에 이름은 하나씩 붙어 있었고, 이름은 이렇게 나왔어요(10월 2일 기준).
| 꼬리표에 적힌 이름 | 기록 수 | 처음 ~ 마지막 |
|---|---|---|
| Claude Fable 5 | 100 | 7월 13일 ~ 9월 4일 |
| Claude Opus 4.8 | 42 | 7월 13일 ~ 7월 21일 |
| Claude Opus 5 | 15 | 8월 6일 ~ 9월 22일 |
| Claude Fable 5.1 | 35 | 9월 8일 ~ 9월 24일 |
| Claude Opus 5.5 | 21 | 9월 25일 ~ 10월 1일 |
| 다른 AI 코딩 도구 | 1 | 8월 11일 |
같은 Claude라도 시기에 따라 다른 모델 이름이 적혀 있어요. 그때그때 쓰던 모델이 바뀌어 온 흔적입니다.
Codex는 꼬리표에 한 번도 나오지 않아요. 다만 저장소의 개발 안내 문서에는 같은 저장소의 다른 작업 사본을 “Codex·ChatGPT 세션이 써 왔다”는 뜻의 메모가 있어요. 그쪽에서 온 기록에는 꼬리표가 없어서, 꼬리표 없는 83개 가운데 몇 개가 Codex의 몫인지는 기록만으로 가를 수 없었어요. 그래서 이 글에서는 ‘꼬리표 없음’으로만 셉니다.
꼬리표가 붙은 기록을 열어 보면 AI가 맡은 일이 보여요.
- 코드 — 기능을 넣고 고장을 고친 변경 그 자체예요
- 시험 — 첫날 아침 0개였던 시험이 9월 25일 기록에는 799개가 돼 있어요. 고장을 고칠 때마다 같은 고장을 다시 잡는 시험이나 검사를 함께 붙였거든요(4편·31편)
- 릴리스 노트 — 8월 3일부터 판마다 쓴 안내문이 77개예요. 릴리스 노트를 쓰거나 고친 작업 기록 91개 중 59개에 AI 꼬리표가 있어요
- 저장 메모 — 무엇이 왜 고장 났고, 어떻게 고쳤고, 어떻게 확인했는지를 길게 적었어요. 틀린 보고를 스스로 고쳐 적은 문장도 이 메모 안에 있어요. 21편에서 본 “v0.1.15의 ‘좀비 고침’ 보고는 트레이 경로만 고친 것으로, 틀렸다”가 그 예예요
그리고 AI가 정하지 않고 남겨 둔 것도 메모에 있어요. 7월 21일 오전 8시 4분의 기록은 검사를 돌리는 방식을 바꾸는 일과 관련 문서를 두고 “사용자 결정 대기 — 이 커밋에 미포함”이라고 적고 빼 두었어요. 이 이야기는 다음 절에서 이어집니다.
🎥 4. 감독이 한 일 — 정하고, 확인하고, 재고, 규칙을 세우다
사람 쪽 일은 꼬리표처럼 셀 수 있는 숫자로 남지 않아요. 대신 메모 곳곳에 흔적이 있습니다. 기록에서 찾은 것을 네 가지로 묶었어요.
① 무엇을 만들고 무엇을 뺄지 정한다
첫날 오후의 v0.1.8 메모에는 제가 한 말이 그대로 남아 있어요. “방금 Codex를 안 쓰게 하려고 했더니 방법이 없었어.” 그래서 연결 해제, 잠깐 사용 안 함, 모델별 끄기가 한 판에 들어갔어요(4편). 써 보다가 빠진 것을 짚는 일이 사람 몫이었어요.
빼는 쪽의 기준은 28편에서 나왔어요. 참고 지식을 더 넣었더니 오히려 지적이 사라진 실험 끝에 남은 원칙, “넣어서 좋아진다는 것을 증명하기 전에는 넣지 않는다”입니다. 좋아 보이는 것을 더하는 일보다, 재 보고 아니면 빼는 일이 판단이었어요.
② AI의 “고쳤다”를 실제 환경에서 확인한다
AI의 “고쳤다”는 보고였지 끝이 아니었어요. 기록에는 그 보고가 다시 고쳐진 일이 두 번 크게 남아 있습니다.
- 16편 — 7월 14일에 ‘다 했음’ 도장 문제를 고쳤는데, 일주일 뒤 7월 21일 기록에는 말이 없는 AI들에게서 잘림이 여전히 ‘다 했음’으로 가려지고 있었다는 진단이 적혀 있어요
- 21편 — 첫날 밤 v0.1.15에서 남은 프로세스(좀비)를 정리했다고 적은 기록을, 다음 날 저녁의 기록이 “틀렸다”고 고쳐 적었어요
21편의 그 기록 끝에는 이런 문장도 있어요. “잔존 0개는 Windows 사용자 확인 필요.” 맥에서 개발하는 AI가 확인할 수 있는 데까지 확인하고, 윈도에서 정말 남는 프로세스가 없는지는 사람에게 넘긴 거예요. 32편의 결론도 같아요. 중계기의 위험 점검 문서에는 “릴리스 전 실환경 점검 1회는 대체 불가”라는 뜻의 줄이 있습니다. 실제 컴퓨터에서 마지막으로 켜 보는 일은 사람 몫이었어요.
③ 직접 재고, 잰 값으로 고른다
첫날 오후 첫 답이 늦게 오던 문제는 가설을 여럿 세우고 지워 가다가 끝났는데, 결론을 낸 메모의 첫 문장이 “사용자가 잰 값으로 결론이 났다”였어요. 그보다 조금 앞선 메모에는 사용자가 명령어 도구를 직접 실행해 봤다는 문장도 있고요(4편).
잰 값을 기준으로 삼는 습관은 사람의 말에도 똑같이 적용됐어요. 25편에서 함께 쓰던 사람이 “네이티브가 성능이 좋다”고 했을 때, 기록은 그 말을 그대로 따르지 않고 실측으로 확인했다고 적고 있어요. 그렇게 나온 숫자가 메모리 329MB에서 61MB였습니다.
④ 지킬 규칙을 정한다
3절 끝의 “사용자 결정 대기”는 11분 뒤에 풀렸어요. 7월 21일 오전 8시 15분의 다음 기록에 그 결정이 반영돼 검사 방식이 바뀌었는데, 방향은 이랬어요(31편).
- 시험을 돌릴 때마다 무거운 검사까지 함께 돌던 방식을 그만두고, 기본 시험은 몇 초 안에 끝나게 한다
- 무거운 검사는 지우지 않는다. 저장하기 전, 합치기 전, 내놓기 전처럼 정해 둔 때에 따로 돌린다
- 이 방침은 문서에 “되돌리지 말 것”이라고 적어 둔다
기록에는 결정을 기다린 줄과 결정이 반영된 줄이 11분 간격으로 나란히 남아 있어요. AI가 스스로 정하지 않고 사람에게 넘긴 것이 바로 ‘무엇을 지킬지’였어요. 이 프로젝트의 역할 분담이 가장 짧게 드러나는 장면입니다.
🧭 5. 1편의 세 질문에 답하기
1편에서 던진 질문 세 개에, 33편의 기록을 바탕으로 답해 볼게요.
① 사람이 쓰는 명령어 도구를, 프로그램이 부를 수 있는 창구로 바꿀 수 있을까? 됩니다. Codex와 Claude의 명령어 도구를 어댑터로 감싸 ‘OpenAI 호환’ 창구 뒤에 세웠어요(5·6편). 다만 사람을 위해 만든 도구라, 사람을 전제로 한 버릇을 하나씩 걷어 내야 했어요. 실행된 폴더의 메모를 읽어 오는 버릇(7편), 끈 뒤에도 남는 프로세스(21편), 허락을 기다리며 멈추는 동작(30편)이 그랬습니다.
② AI마다 잘하는 게 다른데, 골라 쓰거나 아예 동시에 쓰면 어떨까? 됩니다. 스펙 카드로 고르고(9편), 병렬 채팅(26편)과 코드 리뷰 대결(27편)로 동시에 써요. 다만 한 AI가 동시에 받을 수 있는 수에는 한도가 있고(10·26편), 많이 넣는다고 좋아지지도 않았어요(28편). 고르는 일도 재 보고 하는 일이었습니다.
③ 프로그램마다 복사되던 연결 코드를 한 곳으로 모을 수 없을까? 됩니다. 줄 세우기, 취소 전달, 한도, 오류 전달을 중계기 한 곳에 모았어요(10~13·18편). 한 곳에서 고치면 모든 프로그램이 함께 나아져요. 거꾸로 한 곳의 작은 빈틈이 넓게 번질 수도 있었어요. 취소 신호를 놓친 연결 부품 하나가 그 AI의 창구 전체를 멈추게 할 수 있고(11편), 실제로 빠진 설정 한 줄이 새로 붙인 AI의 호출을 전부 막은 적도 있어요(13편). 그래서 고칠 때마다 붙인 검사를 지우지 않습니다(31편).
🔭 6. 다음 단계 — 아직은 계획
마지막으로 앞으로의 이야기예요. 아래 두 가지는 계획이고, 아직 만들지 않았습니다.
- 사용량에 따라 나눠 보내기 — 급하게 답이 필요한 대화는 빠른 모델로, 한꺼번에 처리할 많은 일은 놀고 있는 AI로 보내는 것이에요
- 모델 추천 — 모델마다 쌓인 품질·속도·생각에 쓴 양의 기록을 모아, 어떤 일에 어떤 AI가 맞는지 추천하는 것이에요
재료가 되는 기능은 일부 들어가 있어요. 9월 24일(v0.1.104)부터 중계기는 AI·모델·쓰는 프로그램·날짜별로 요청 수, 토큰, 평균 걸린 시간, 추정 비용을 장부에 남겨요. 다음 날부터는 프로그램이 모델 이름 대신 ‘빠른 대화용’ 같은 역할 이름으로 부르면 중계기가 연결된 모델 중에서 고르고, 한도를 다 쓴 모델은 빼고 다른 모델로 보내요(v0.1.105). 9편의 스펙 카드도 추천의 재료가 될 수 있고요. 하지만 장부를 보고 스스로 나눠 보내거나 추천하는 부분은 아직 없습니다.
저장소 문서에 ‘후속 후보’와 ‘미결’로 적혀 있는 것도 있어요.
- 같은 질문을 반복해서 판정할 때 앞의 결과를 다시 쓰는 저장 기능 — 판정 창구 안내서에 “후속 후보(현재 없음)”
- 중계기를 다시 켤 때 Codex·Claude 연결을 자동으로 되살리는 기능 — 위험 점검 문서에 “미결 후보”
정리
① 7월 13일부터 10월 1일까지 저장 기록 394개가 쌓였고, 작업 기록 297개 중 214개에 AI(Claude)가 공동 작성자로 올라 있어요. 8월 31일부터는 71개 전부였어요(10월 2일 기준) ② AI는 코드·시험·릴리스 노트·저장 메모를 썼고, 사람은 무엇을 만들고 뺄지 정하고, “고쳤다”를 실제 환경에서 확인하고, 직접 재고, 지킬 규칙을 정했어요 ③ 1편의 세 질문은 모두 “된다, 다만 손이 많이 간다”로 답했고, 사용량에 따른 배분과 모델 추천은 아직 계획이에요
이것으로 LLM 중계기 개발기를 마칩니다. 놀고 있는 구독 AI를 일하게 할 수 없을까라는 질문에서 시작해, 어댑터와 교통정리, 이상하게 구는 AI, 설치와 업데이트, 그리고 중계기 위에 올린 기능까지 33편을 이어 왔어요. 끝까지 읽어 주셔서 고맙습니다.
연재 전체 목차
1부 왜 만들었나
- 1편 퇴근하면 노는 AI 구독, 일하게 할 수 없을까 — LLM 중계기 개발기를 시작하며
- 2편 중계기란 무엇인가 — 콘센트 모양이 다른 나라에서 쓰는 만능 어댑터
- 3편 ‘OpenAI 호환’은 왜 표준 콘센트가 됐나 — 모양은 같은데 전압이 살짝 다를 때
- 4편 AI와 함께 하루 만에 만든 첫 버전 — 짐 풀고, 고치고, 밤에야 눕는 이삿날
2부 여러 AI를 한 줄로
- 5편 AI마다 다른 플러그를 같은 어댑터로 — 서랍 속 충전기 젠더 이야기
- 6편 부를 때마다 새로 켤까, 켜 둔 채 쓸까 — 콜택시와 정류장에서 기다리는 셔틀버스
- 7편 AI가 엉뚱한 메모를 읽고 왔다 — 빈 책상이 필요했던 이유
- 8편 로그인했는데 401 — 서랍 속 옛 열쇠가 문을 막다
- 9편 모델마다 다른 스펙을 카드로 — 가전제품 에너지 라벨처럼 고르기
3부 교통정리
- 10편 중계기에 톨게이트가 필요한 이유 — 차선 수가 다른 고속도로 요금소
- 11편 전화를 끊었는데 상담원은 계속 대기 중 — 취소 신호를 끝까지 전하는 법
- 12편 1분에 몇 번까지 부를 수 있나 — 은행 창구 번호표처럼 간격을 두는 페이서
- 13편 설정 한 줄 빠졌을 뿐인데 전멸 — 이름표 없는 손님은 맨 뒤로
- 14편 ‘저는 Claude예요’라고 말한 다른 AI — 공용 메모장을 같이 쓴 두 팀
4부 AI가 이상하게 굴 때
- 15편 생각만 하다 답을 못 한 AI — 연료를 예열에 다 써 버린 자동차
- 16편 ‘다 했어요’라더니 잘린 답 — 영수증엔 완납, 물건은 반만
- 17편 성공 응답 속에 숨은 실패 — 합격 봉투 안에 든 불합격 통지
- 18편 에러 메시지를 자르지 마라 — 블랙박스 영상의 앞부분만 남겼을 때
- 19편 한국어는 토큰을 더 먹는다 — 같은 짐도 포장 단위가 다르다
5부 만들고 나서가 더 어렵다 — 설치·업데이트
- 20편 맥에서 되는데 윈도에서 안 되는 이유 — D:를 인터넷 주소로 착각한 날
- 21편 끄는 것도 기술이다 — 퇴근했는데 사무실 불이 켜져 있다
- 22편 ‘준비 중’이 끝나지 않는 화면 — 영원히 ‘조리 중’인 주문 번호판
- 23편 자동 업데이트가 계속 되돌아간 이유 — 깨어나기도 전에 끝난 건강검진
- 24편 조용한 업데이트는 멈춘 줄 안다 — 층 표시 없는 엘리베이터
- 25편 무거운 껍데기를 걷어내다 — 대형 SUV에서 경차로
6부 중계기 위에서, 그리고 회고
- 26편 한 질문, 여러 AI의 답 — 같은 문제를 여러 과외 선생님에게
- 27편 AI끼리 코드리뷰 대결 — 여러 심사위원의 교차 채점
- 28편 지식을 넣었더니 지적이 사라졌다 — 참고서를 줬더니 답안이 짧아졌다
- 29편 생각하지 않고 고르기만 하는 창구 — 객관식에 서술형 답을 쓴 학생
- 30편 AI가 허락을 기다리다 멈췄다 — 결재 도장을 기다리는 서류
- 31편 검사는 지우지 않는다 — 사고 다발 교차로의 신호등
- 32편 가짜는 진짜를 대신 못 한다 — 모의고사와 실전
- 33편 사람이 판단하고 AI가 만들었다 — 감독과 스태프 (이 글)
2026년 10월 2일 기준입니다. 숫자는 제가 만든 중계기 저장소의 본 줄기 저장 기록(시각·메모·공동 작성자 꼬리표)과 문서를 10월 2일에 세어 본 값이고, 시험 수는 저장 메모에 적힌 값입니다. 다음 단계로 적은 두 가지는 계획이며 아직 만들지 않았습니다. 특정 기업·서비스의 공식 입장이 아닙니다.